INTERSPEECH 2024 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。本次论文预讲会按照技术领域投稿和实验室专场两种形式进行招募,欢迎大家投稿报名。
中国移动研究院九天团队【专场】
时间:7月9日(周二)19:00 ~ 20:40
形式:线上
议程:每位嘉宾分享20分钟(含5分钟QA)
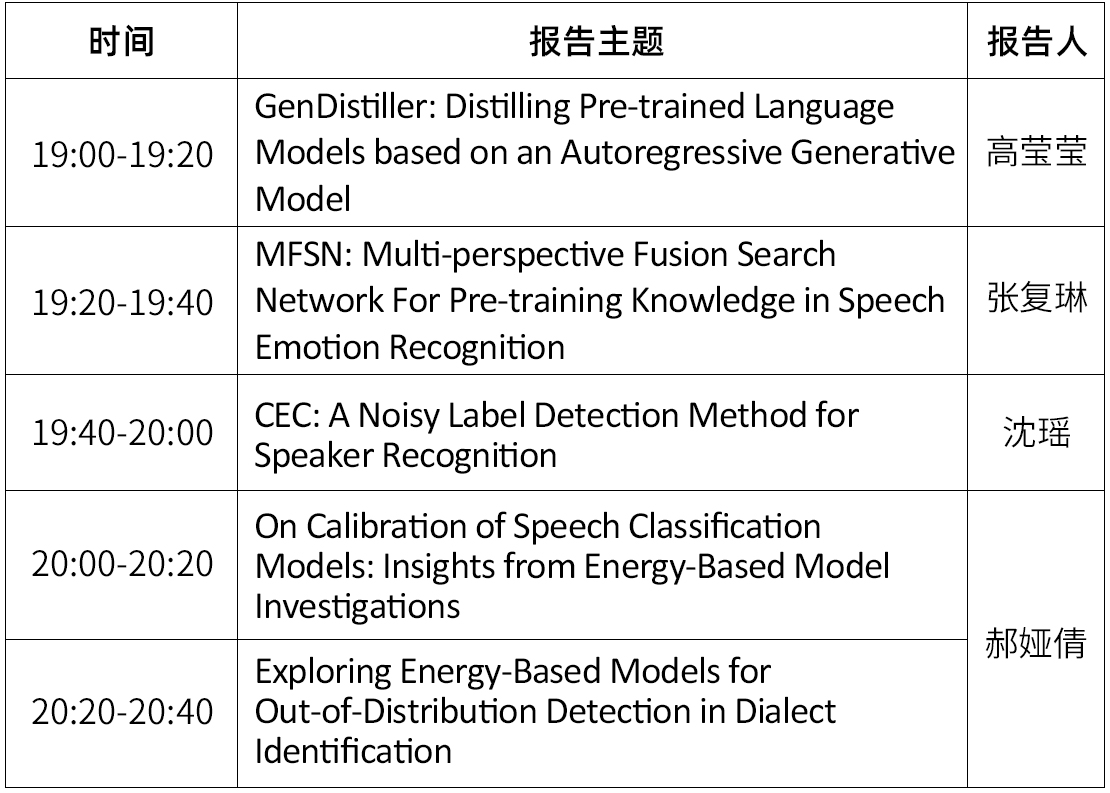
嘉宾&主题
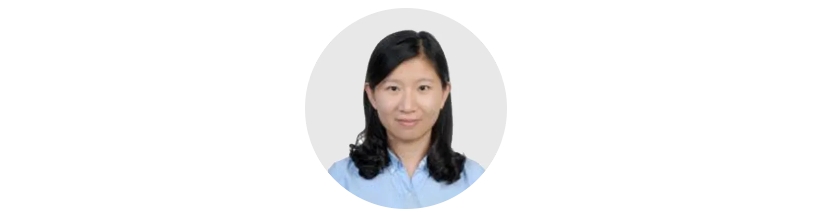
嘉宾简介:张复琳,硕士,毕业于北京理工大学,现就职于中国移动研究院人工智能与智慧运营中心,主要从事声纹识别、多模态情感分析等领域的研究。
报告题目 :MFSN: Multi-perspective Fusion Search Network For Pre-training Knowledge in Speech Emotion Recognition
摘要:在人机交互领域,语音情感识别是非常重要的一项课题,许多工作通过直接提取预训练模型的信息来进行语音情感识别,没有事先考虑这么做是否合适。为此,我们提出了一种新的融合搜索框架MFSN,来利用语音预训练模型提取的信息进行语音情感识别。我们将语音信息分为文本相关的情感信息和声学相关的情感信息,从语义和声学两个角度来捕捉与情感相关的线索。然后我们设计了一个新型的融合搜索框架,充分利用这两种线索进行情感识别。我们还针对声学情感信息设计对比了不同的建模方法,填补了目前已有建模方法的空白。最后,通过在多个数据集上的实验验证了MFSN的先进性。
论文:http://arxiv.org/abs/2306.09361
论文:https://arxiv.org/abs/2406.13268
嘉宾简介:郝娅倩,博士,毕业于中国科学院大学,现任职于中国移动研究院人工智能与智慧运营中心。她的研究方向包括统计优化与体系化人工智能。
报告题目 1:On Calibration of Speech Classification Models: Insights from Energy-Based Model Investigations
摘要1:在语音分类任务中,深度学习模型通常能够达到高精度,但存在校准不足的问题,表现为分类器过度自信。校准的重要性在于它对保证深度学习系统决策可靠性起着关键作用。本研究通过训练融合判别模型和生成模型的联合能量模型(EBM),探讨了EBM在语音分类任务中校准置信度的有效性,从而提高了分类器的校准能力并减轻了过度自信问题。在年龄、情感和语言识别三个具体语音分类任务上进行了实验评估。突显了EBM在校准语音分类模型方面的竞争力。这项研究强调了EBM在语音分类任务中的潜力,展示了它们能够在不牺牲准确性的情况下增强校准的能力。
报告题目 2:Exploring Energy-Based Models for Out-of-Distribution Detection in Dialect Identification
摘要2:方言的多样性为仅针对特定语言模式训练的模型带来了挑战,使得这些模型在面对未见过或分布外(OOD)数据时容易出错。本研究引入了一种新型的边缘增强联合能量模型(MEJEM),专门用于方言的OOD检测。通过整合生成模型和能量边际损失,我们旨在增强方言识别系统的鲁棒性。此外,我们探讨了两种OOD得分方法用于方言的OOD检测,并且我们的研究明确表明,能量得分优于softmax得分。利用Sharpness-Aware Minimization优化联合模型的训练过程,我们通过最小化损失和尖锐度来提升模型泛化能力。在方言识别任务上的实验验证了能量模型的有效性,并提供了对其性能的见解。
直播将通过语音之家微信视频号进行直播
扫码添加语音小管家,进入语音之家讨论群
为了共创高质量的论文预讲会,我们诚挚邀请所有 INTERSPEECH 2024 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。
联系人邮箱
bd@speechhome.com
联系人微信