INTERSPEECH 2024 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。本次论文预讲会按照技术领域投稿和实验室专场两种形式进行招募,欢迎大家投稿报名。
INTERSPEECH 2024 论文预讲会第五期邀请到南开大学人类语言技术实验室做本次会议的专场分享,欢迎大家观看。
实验室概况
南开大学人类语言技术实验室依托于南开大学、数据与智能系统安全教育部重点实验室DISSec和天津市媒体计算工程中心TMCC。在南开大学杰出人才引进项目的有力支持下,建立了一支以秦勇教授为核心,定位于高水平创新型研究的团队。该团队目前有教授2人、高级研究员1人、硕博士生15人。团队聚焦于智能交互技术、智能音频分析技术、自动语音质量评测技术、语音及相关多模态基础模型评测技术等。团队目前承担科技部科技创新2030新一代人工智能重大项目;国基金面上项目;南开-联想、南开-零犀、南开-马上消费校企合作项目;南开大学交叉研究中心项目等。
第五期
南开大学人类语言技术实验室【专场】
时间:7月27日(周六)19:00 ~ 20:00
形式:线上
议程:每位嘉宾分享30分钟(含5分钟QA)
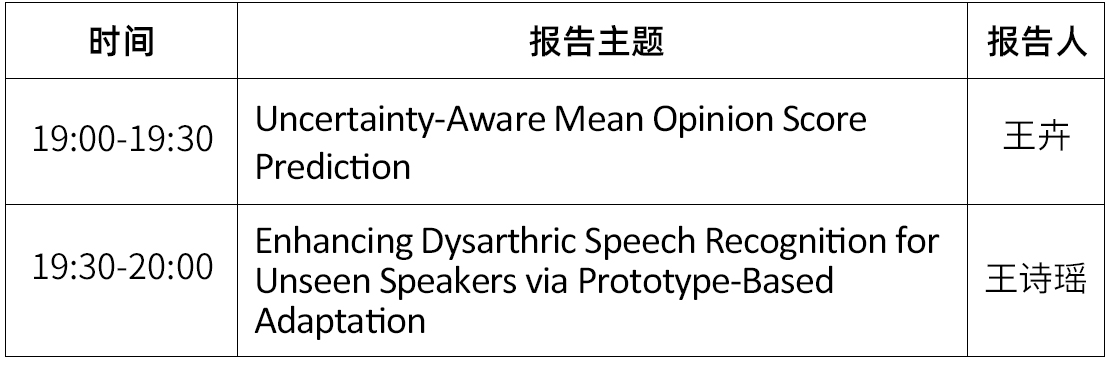
嘉宾&主题
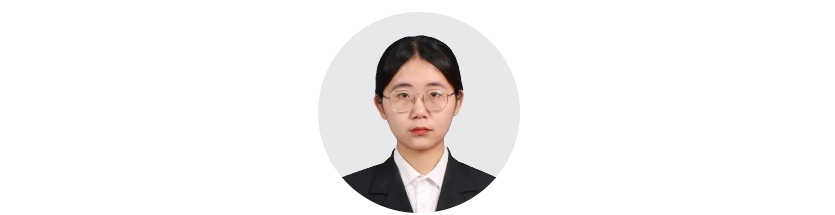
嘉宾简介:王卉,南开大学计算机学院人类语言技术实验室,二年级博士生,导师为秦勇教授。主要研究方向语音质量评估。
报告题目 :Uncertainty-Aware Mean Opinion Score Prediction
摘要:由于说话人之间固有的可变性,构音障碍语音识别(DSR)面临着巨大的挑战,当将DSR模型应用于新的构音障碍说话人时,会有严重的性能下降。传统的说话人适应方法通常涉及对每个说话人的模型进行微调,但这种策略成本高昂,需要大量的数据收集,对构音障碍说话人来说不方便。为了解决这个问题,我们引入了一种基于原型的方法,该方法在没有额外微调的情况下显著提高了未见过的构音障碍说话人的DSR性能。我们的方法使用微调后的HuBERT作为特征提取器来产生每个单词的原型,这些原型封装了未见过说话人的发音特征,是分类的基础。此外,我们结合了监督对比学习来改进特征提取。通过提高表示质量,我们进一步提高了DSR的性能,实现了有效的个性化DSR。
直播将通过语音之家微信视频号进行直播
扫码添加语音小管家,进入语音之家讨论群
为了共创高质量的论文预讲会,我们诚挚邀请所有 INTERSPEECH 2024 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。
联系人邮箱
bd@speechhome.com
联系人微信