ICASSP 2025 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 ICASSP 2025 录用论文的作者进行报告交流。
ICASSP 2025 论文预讲会邀请到南开大学人类语言技术实验室在3月17日和3月18日分别做两期专场分享,本文介绍第一场相关内容,欢迎大家预约观看。
实验室概况
南开大学人类语言技术实验室依托于南开大学、数据与智能系统安全教育部重点实验室DISSec和天津市媒体计算工程中心TMCC。在南开大学杰出人才引进项目的有力支持下,建立了一支以秦勇教授为核心,定位于高水平创新型研究的团队。该团队目前有教授2人、高级研究员1人、硕博士生20人。团队聚焦于智能交互技术、智能音频分析技术、自动语音质量评测技术、语音及相关多模态基础模型评测技术等。团队目前承担科技部科技创新2030新一代人工智能重大项目;国基金面上项目;南开-联想、南开-零犀、南开-马上消费校企合作项目;南开大学交叉研究中心项目等。
第八期:南开大学人类语言技术实验室(一)【专场】
时间:3月17日(周一)19:00 ~ 20:40
形式:线上
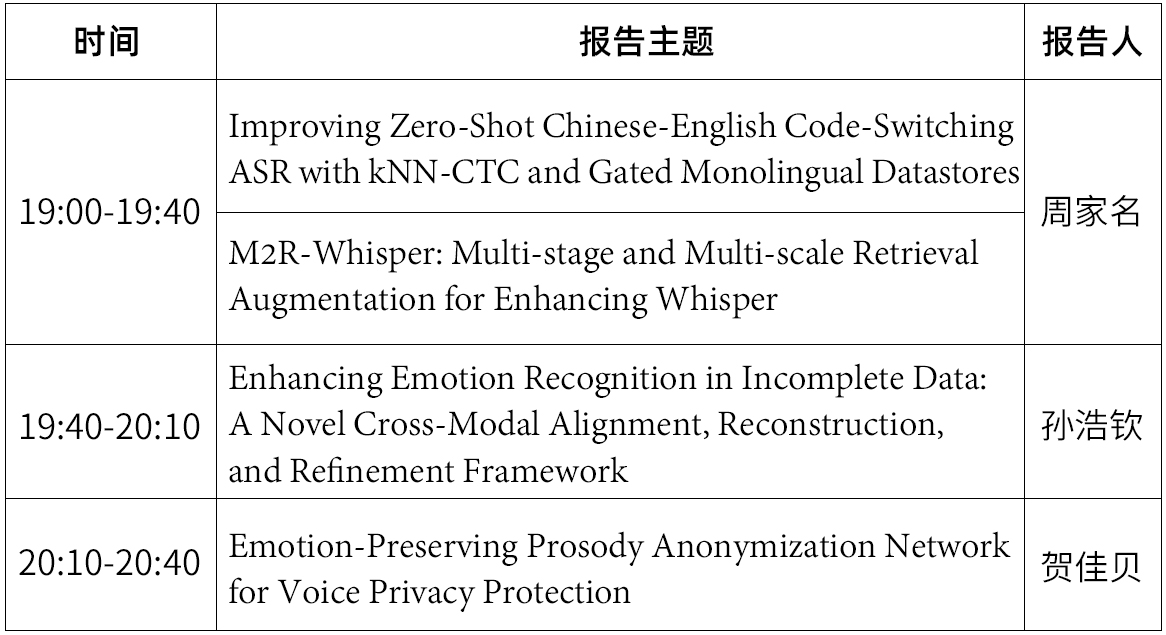
嘉宾&主题
嘉宾简介:周家名,南开大学人类语言技术实验室一年级博士生,研究方向为语音识别、领域适配、语音语言大模型。曾在ICASSP上发表多篇论文。
分享主题1:Improving Zero-Shot Chinese-English Code-Switching ASR with kNN-CTC and Gated Monolingual Datastores
摘要1:k-最近邻(kNN)结合联结时序分类(CTC)的语音识别模型(kNN-CTC)在单语语音识别任务中表现出色。然而,当直接应用于语码转换等多语言场景时,该模型面临着诸多挑战。尽管存在性能提升的潜力,但使用单一双语数据存储的 kNN-CTC 模型可能会引入另一种语言的干扰噪声。为解决此问题,我们提出了一种新颖的基于 kNN-CTC 的语码转换语音识别(CS-ASR)框架。该框架采用两个独立的单语数据存储,并结合门控机制进行数据存储的选择,从而有效降低噪声干扰。我们的方法能够为每个语音帧选择最合适的数据存储,确保将特定语言的信息融入语音识别过程。我们将这一框架应用于先进的基于 CTC 的模型,构建了一个高性能的 CS-ASR 系统。大量实验结果表明,我们的门控数据存储选择机制显著提升了零样本中英双语语码转换语音识别的性能。
论文链接:https://arxiv.org/abs/2406.03814
分享主题2:M2R-Whisper: Multi-stage and Multi-scale Retrieval Augmentation for Enhancing Whisper
摘要2:尽管 Whisper 在多语种自动语音识别(ASR)方面表现出强大的性能,但在准确识别各种子方言(subdialects)方面仍然面临挑战。本文提出了一种新颖的多阶段、多尺度检索增强方法 M2R-whisper,旨在提升低资源条件下的 ASR 性能。该方法基于上下文学习(ICL)和检索增强技术的原理,在预处理阶段采用句子级 ICL 来利用上下文信息,同时在后处理步骤中集成词元级 k-最近邻(kNN)检索,以进一步优化最终的输出分布。通过协同结合句子级和词元级检索策略,M2R-whisper 有效地减少了各种类型的识别错误。在普通话和子方言数据集(包括 AISHELL-1 和 KeSpeech)上进行的实验表明,ASR 准确率得到了显著提升,且所有这些改进均在无需更新任何参数的情况下实现。
论文链接:https://arxiv.org/abs/2409.11889
嘉宾简介:孙浩钦,南开大学人类语言技术实验室二年级博士生,研究方向为语音情感识别、音频理解、语音检索。曾在INTERSPEECH,ICASSP上发表多篇论文。
分享主题 :Enhancing Emotion Recognition in Incomplete Data: A Novel Cross-Modal Alignment, Reconstruction, and Refinement Framework
摘要: 多模态情感识别系统在很大程度上依赖于完整的模态数据,当模态数据不完整时,系统性能就会明显下降。为了解决这个问题,我们提出了跨模态对齐、重构和完善(CM-ARR)框架,它依次进行跨模态对齐、重构和完善阶段,以处理缺失的模态并提高情感识别能力。该框架利用基于分布的无监督对比学习来对齐异构模态分布,从而减少差异。重建阶段应用归一化流模型来转换这些对齐的分布,并恢复缺失的模态。细化阶段采用基于点的监督对比学习来破坏语义相关性并突出情感特征,从而丰富重建表征的情感内容。大量实验证实了 CM-ARR 的卓越性能。
嘉宾简介:贺佳贝,南开大学人类语言技术实验室三年级博士生,研究方向为隐私保护、说话人识别、语音隐私保护。曾在IEEE Trans,TELECOMMUN SYST上发表多篇论文。
分享主题:Emotion-Preserving Prosody Anonymization Network for Voice Privacy Protection
摘要:在语音匿名化过程中实现情感保留与隐私保护之间的平衡是一项重大挑战,尤其是因为有效处理韵律这一语音中的关键特征颇具难度。虽然在匿名化语音中保留韵律特征能增强情感表达,但这也会增加说话人信息泄露的风险。为解决这一矛盾,我们提出了一种轻量级的情感保留韵律匿名化(EPPA)网络,该网络提取与说话人无关的韵律特征以保留语音情感,同时将这些特征转换为另一位说话人的风格,从而实现匿名化。通过将EPPA与用于匿名化的音色克隆相结合,同时保留语音内容,我们实现了更加平衡的语音转换。使用2024年语音隐私挑战赛(VPC)的评估指标进行评估时,我们所提出的采用最近中心距离(CCD)匿名化策略的EPPA在情感表达、内容清晰度和隐私保护方面均表现出色,与六种基线解决方案相比,在平均排名和加权排名中均获得了最高名次。
参与方式
直播将通过语音之家微信视频号进行直播
手机端、PC端可同步观看
👇👇👇
预讲会征集
ICASSP 2025 论文预讲会面向全球线上招募,结合定向邀请与征集报名的方式,来选择预讲会的嘉宾。
为了共创高质量的论文预讲会,我们诚挚邀请所有 ICASSP 2025 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。
预讲会报名方式
联系人邮箱:bd@speechhome.com
联系人微信