INTERSPEECH 2025 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 INTERSPEECH 2025 录用论文的作者进行报告交流。
INTERSPEECH 2025 论文预讲会第一期邀请到香港理工大学做本次会议的专场分享,欢迎大家观看。
第一期-香港理工大学【专场】
时间:6月20日(周五)19:30 ~ 21:30
形式:线上
议程:每位嘉宾分享20分钟(含5分钟QA)
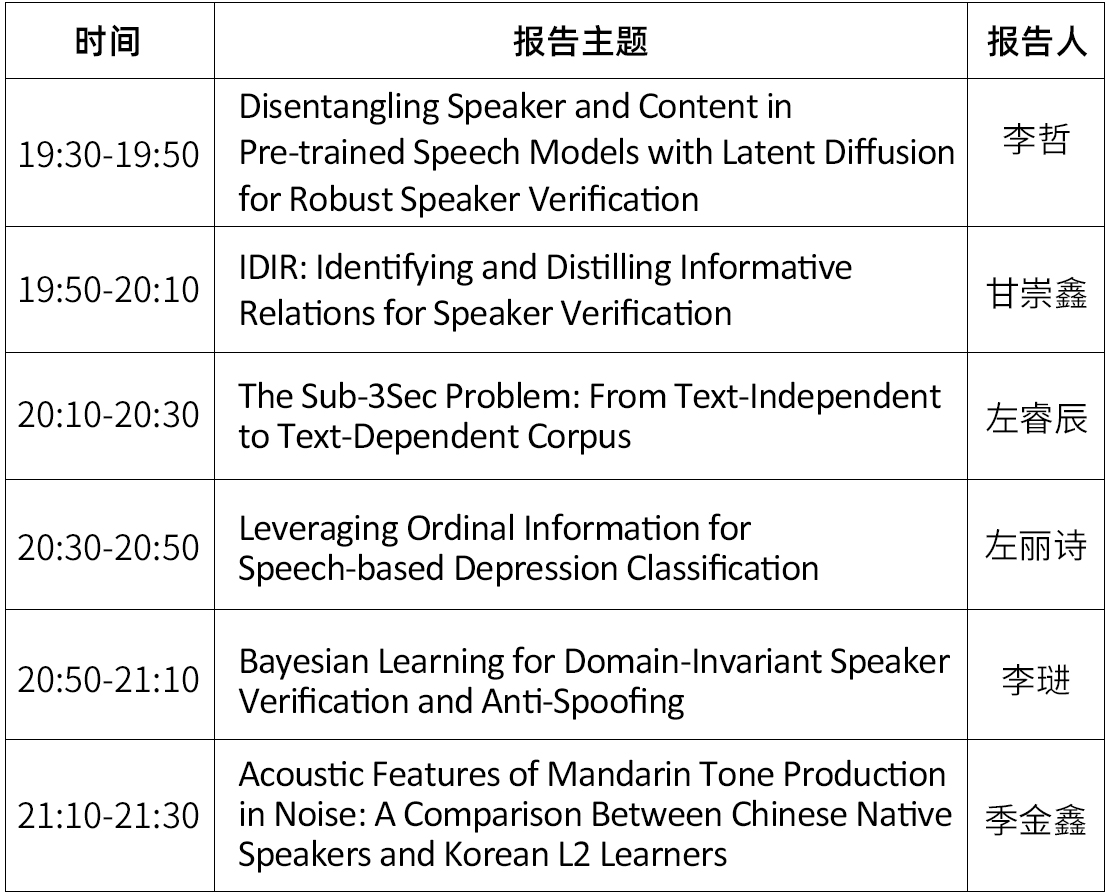
嘉宾&主题
嘉宾简介:李哲,香港理工大学电机及电子工程学系博士研究生,导师为MAK Man-Wai教授。目前,他在微软亚洲研究院(MSRA)担任实习生,合作导师为刘树杰博士。他曾作为访问学生学者在美国斯坦福大学开展国际联合研究,合作导师为Mert Pilanci教授。硕士毕业于新疆大学,导师为中国工程院院士吾守尔·斯拉木(Wushour Silamu)教授。他是IEEE会员及中国人工智能学会会员。在学术研究方面,李哲主持过1项研究生科研创新项目,并作为核心成员参与了多项国家重点研发计划、国家自然科学基金(NSFC)项目以及香港研究资助局(RGC)项目。此外,他在语音领域顶刊T-ASLP、语音会议 ICASSP 和 InterSpeech 以及其他 CCF推荐会议、SCI、EI期刊和中文核心期刊上共发表论文50篇,获得授权发明专利3项、软件著作权1项。他作为主要完成人荣获2020年中国人工智能学会优秀科技成果奖,其参与的论文荣获PRICAI 2024的Best Student Paper Runner-Up Award。
分享主题:Disentangling Speaker and Content in Pre-trained Speech Models with Latent Diffusion for Robust Speaker Verification
摘要:面向说话人验证的解纠缠语音表征学习旨在将语音内容与说话人特征解耦为独立的表征。然而,现有基于变分自编码器(VAE)的方法通常依赖于缺乏语义含义的隐变量,限制了其在说话人验证任务中的效果。为克服这一局限性,本文提出一种基于扩散模型的方法,在隐空间中有效实现说话人特征与语音内容的解耦与分离。该方法在VAE框架基础上引入说话人编码器,用于学习说话人特征的隐变量,并通过帧级隐变量捕获语音内容表示。与以往基于序列VAE的方法不同,本文方法在隐空间中引入条件扩散模型,以获得说话人感知的表征。在VoxCeleb数据集上的实验结果表明,该方法能够有效地从预训练语音表征中分离出说话人特征。
嘉宾简介:甘崇鑫,目前是香港理工大学电机及电子工程学系的一名博士研究生,IEEE学生会员, 导师是麦文伟教授。他硕士和本科分别毕业于香港理工大学电子及信息工程学系和郑州大学网络工程学系。目前,他是微软亚洲研究院多媒体计算组的一名实习生,研究工作聚焦于多模态的语音通用大模型。他的研究兴趣包括说话人识别、对比学习和声音事件检测。
分享主题 :IDIR: Identifying and Distilling Informative Relations for Speaker Verification
摘要:传统的基于特征的知识蒸馏方法通过将学生网络的特征与教师网络的特征对齐来进行学习。然而,这种一对一的对齐方式忽略了一个 mini-batch 内不同说话人之间的结构关系。此外,由于学生网络与教师网络之间存在较大的容量差异,两者在特征表示上往往会存在显著差异。为了解决这些问题,我们提出了一种同时蒸馏说话人间(inter-speaker)和说话人内(intra-speaker)关系的方法。与其模拟所有学生与教师特征之间的成对关系,我们提出了识别并蒸馏有效关系(Identifying and Distilling Informative Relations, IDIR)的方法,使学生网络能够从教师网络中学习说话人之间的关系。此外,我们还在这些有效关系的相似度分数中引入了一个边际项,从而进一步减少说话人内部的特征方差,并增强说话人之间的区分度。在三个测试集上使用简单的 x-vector 学生模型进行的实验表明,该方法在说话人识别任务中展现出优秀的性能,验证了其优越性与有效性。
嘉宾简介:左睿辰,香港理工大学电机及电子工程学系博士研究生,导师为MAK Man-Wai教授和LEE Kong Aik教授。其本科毕业于北京理工大学电子信息工程系,与中国科学院自动化研究所联合培养,导师为张铁林博士和徐波博士,曾参与中国科学院战略性先导科技专项与中国“脑十年”计划,期间研究方向为脉冲神经网络与多感官信号处理。她曾于美国新常春藤联盟弗吉尼亚大学与加拿大渥太华大学有博士学习经历,研究方向为生物信号处理。目前,她的研究工作聚焦于文本相关说话人识别,语料库,与短时语音任务。
分享主题:The Sub-3Sec Problem: From Text-Independent to Text-Dependent Corpus
摘要:本文介绍了说话人验证中的 3 秒以下问题,这是一项很少被探索的短时任务。该问题源于与文本相关的说话人验证 (TD-SV) 语料库的费时费力人工注释和昂贵的录音成本。为了解决这个问题,我们提出了一种自动管道流程,用于从与文本无关的说话人验证 (TI-SV) 语料库中提取短语。ASR 模型识别短语和时间戳,并使用 N-gram 分析确保短语在说话者中是常见的,从而实现充分的注册测试实验。使用此流程,我们创建了 Sub3Vox,这是一个来自于 VoxCeleb1 的 TD-SV 语料库,包含来自 1,250 位说话者的超 370 万条简短话语——远远大于现有的 TD-SV 语料库。结果表明, TD-SV 的匹配注册和测试短语行为可将 EER 降达 45.23%。此外,缩短测试语句会导致 TI-SV 性能显著下降,但 TD-SV 性能仅略受影响,这提供了首个3 秒以下短时语音长度对性能影响的分析。
数据集介绍链接(暂):https://slash1028.github.io/
嘉宾简介:左丽诗,香港理工大学电机及电子工程学系的一名博士研究生,导师是麦文伟教授。她本科毕业于南京农业大学。她的研究兴趣包括抑郁症语音识别,语音疾病检测, 领域泛化。
分享主题:Leveraging Ordinal Information for Speech-based Depression Classification
摘要:尽管抑郁程度本质上是有序的,但以往许多抑郁检测的研究却过于简化这一问题,将其视为一个二分类问题,从而忽略了抑郁严重程度中细微的变化和顺序关系。我们提出通过一个有序损失函数(ordinal loss)来构建一个包含有序信息的潜在空间,以促进抑郁分类的学习。具体来说,我们为抑郁评分定义了 K 个阈值,从而在不同的抑郁等级(例如轻度与非轻度)上创建了一系列的二分类任务。有序损失函数不仅支持基本的二分类任务,还能使模型学习这些等级之间的关系。我们的方法在抑郁检测中优于当前最先进的方法,显示出在建模中考虑抑郁严重程度的有序性的重要性。
嘉宾简介:李琎,目前是香港理工大学电机及电子工程学系的一名博士研究生,主要研究方向是说话人识别和anti-spoofing,在多个语音会议以第一作者身份发表多篇论文。
分享主题:Bayesian Learning for Domain-Invariant Speaker Verification and Anti-Spoofing
摘要:自动说话人验证(ASV)和反欺骗系统在现实世界中的领域不匹配(domain mismatch)条件下表现会显著下降。一种名为松弛的实例频率归一化(RFN)的方法,通过在时间和通道轴上基于特征统计对频率成分进行归一化,被认为是减少说话人嵌入网络中特征图领域依赖性的有前景手段。我们主张,不同的频率应赋予不同的权重,并且应考虑由于领域转移所带来的权重不确定性。为此,我们提出利用变分推理(variational inference)来建模这些权重的后验分布,从而得到贝叶斯加权RFN(BWRFN)。这种方法克服了固定权重RFN的局限性,使其在领域不匹配的条件下更加有效。在跨数据集ASV、跨TTS反欺骗以及对欺骗鲁棒的ASV等任务上的大量实验表明,BWRFN在性能上显著优于WRFN和RFN。
嘉宾简介:季金鑫,香港理工大学与同济大学联合培养博士双学位项目。研究方向为实验语音学,主要研究内容为汉语声调以及韵律的声学分析以及语音感知实验。
分享主题:Acoustic Features of Mandarin Tone Production in Noise: A Comparison Between Chinese Native Speakers and Korean L2 Learners
摘要:目前关于汉语学习者在噪音环境下的语音产出研究仍较为有限。本研究以高水平汉语韩国留学生为研究对象,系统考察其在双人言语噪音(80 dB)、白噪音(80 dB)及安静条件下对普通话四个声调的声学特征(音高、音强和时长)的调整策略,并与汉语母语者进行对比分析。
实验共招募53名被试(27名汉语母语者,26名高水平韩语二语学习者),要求他们在三种实验条件下产出28个目标字。通过线性混合效应模型(LMM)分析发现,韩语二语学习者在两种噪音条件下均显著提高了四个声调的音强和时长,而汉语母语者仅在白噪音中显著增加了上声和去声的时长。进一步采用广义可加混合效应模型(GAMM)分析音高数据,结果表明两组被试在噪音条件下均对四个声调的音高进行了调整,但上声的调整模式存在显著的组间差异。
基于二语发音的反馈控制理论,本研究对中韩被试的声调调整差异进行了探讨。在高强度噪音环境下,汉语声调的感知与识别难度增加,导致被试的听觉反馈调节能力下降。在此情况下,汉语母语者能够有效利用发音前馈控制机制,并结合发音反馈控制保持声调产出的准确性;相比之下,韩语二语学习者由于发音前馈控制能力较弱,因此在噪音环境下表现出更多的音高偏误,需要更多依赖音强和时长进行发音补偿。研究结果揭示了二语学习者在噪音环境下的发音调节机制,为相关理论的完善提供了新的实证依据。
参与方式
直播将通过语音之家微信视频号进行直播
手机端、PC端可同步观看
👇👇👇
预讲会征集
INTERSPEECH 2025 论文预讲会面向全球线上招募,结合定向邀请与征集报名的方式来选择预讲会的嘉宾。

为了共创高质量的论文预讲会,我们诚挚邀请所有 INTERSPEECH 2025 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。
预讲会报名方式
联系人邮箱:bd@speechhome.com
联系人微信