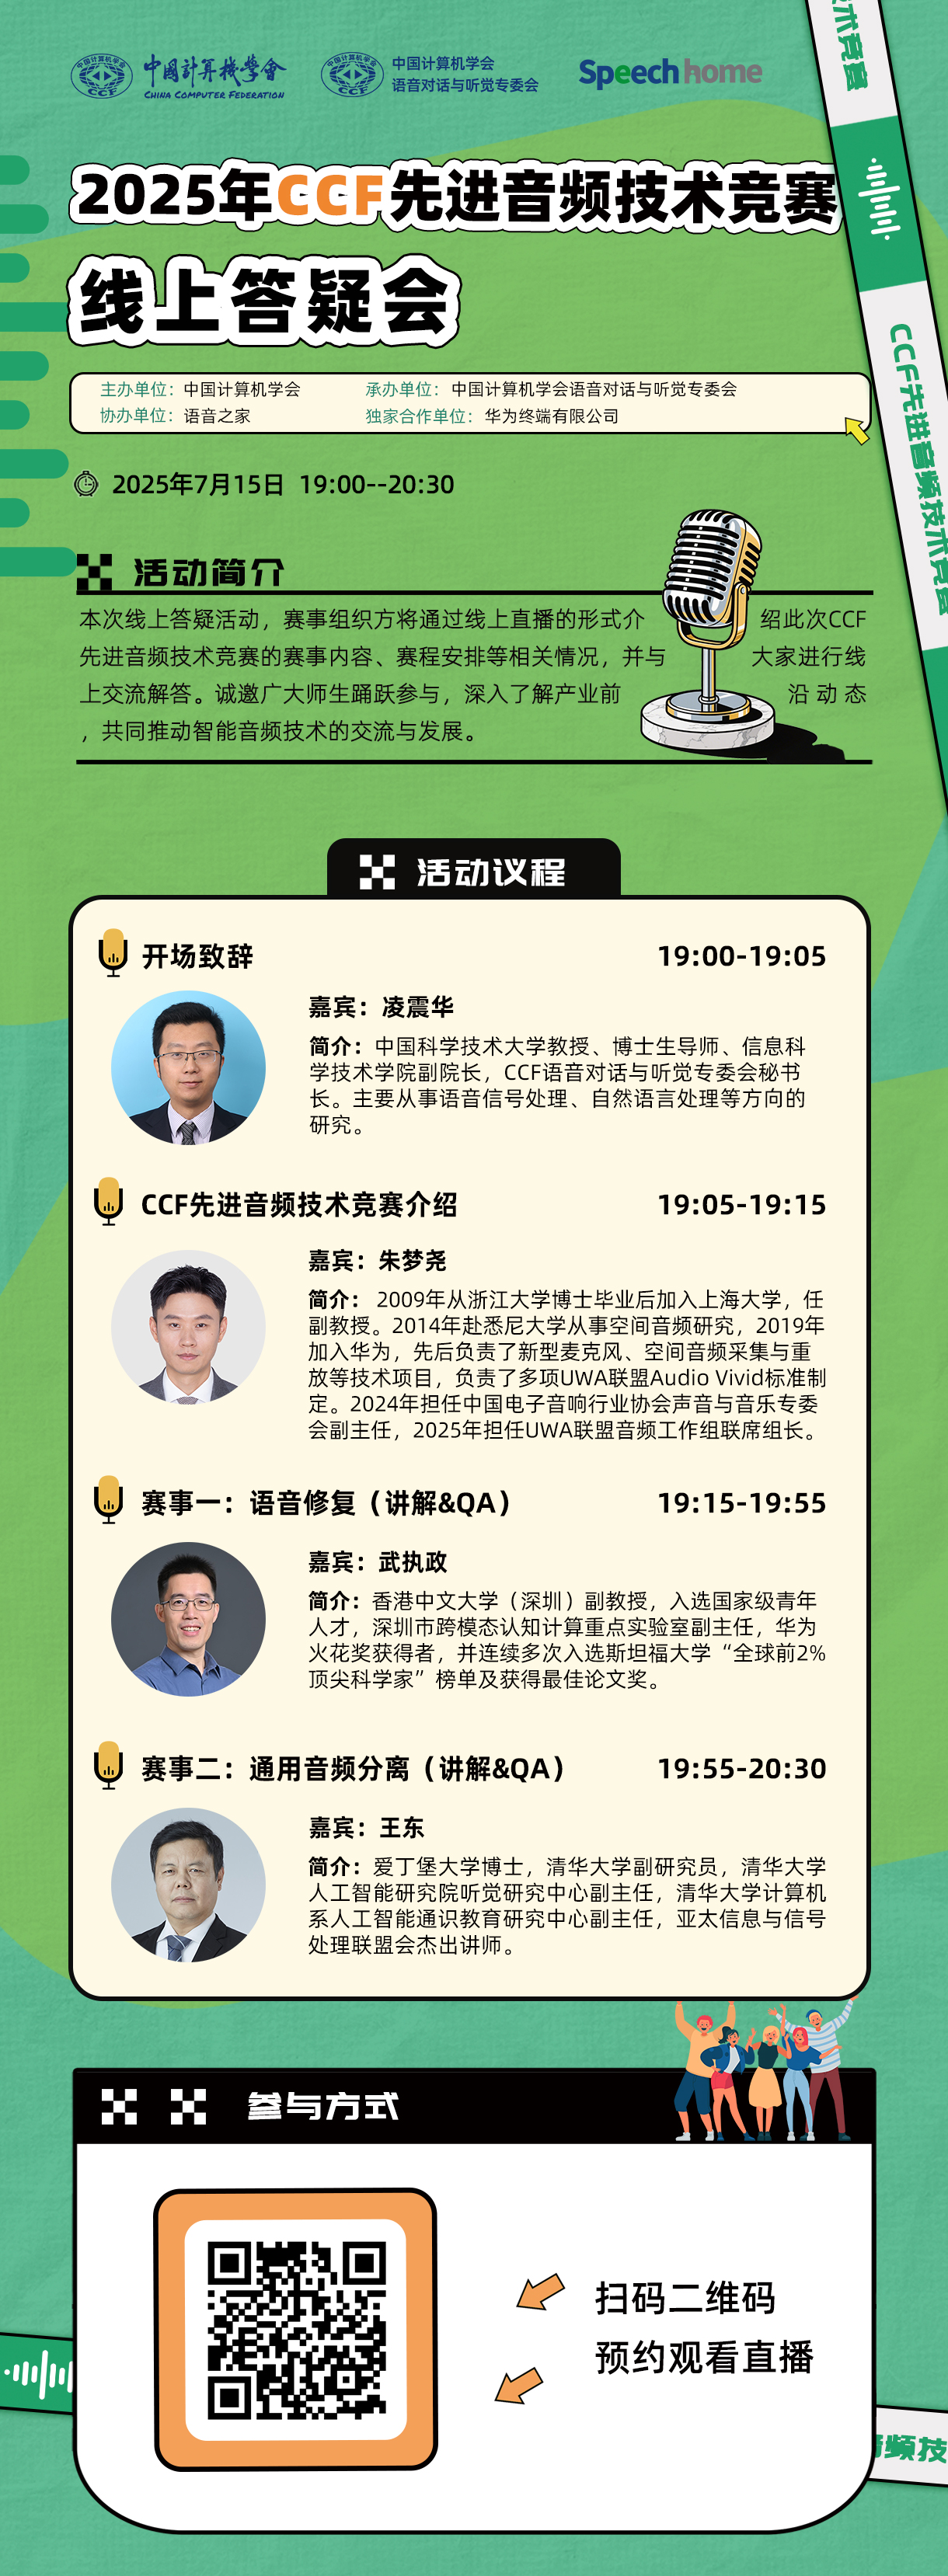
由中国计算机学会主办、CCF语音对话与听觉专委会承办、语音之家协办、华为终端有限公司独家合作的CCF先进音频技术竞赛将开启线上直播答疑,与大家进行交流互动,欢迎大家预约观看。
本次线上答疑活动,赛事组织方将通过线上直播的形式介绍此次CCF先进音频技术竞赛的赛事内容、赛程安排等相关情况,并与大家进行线上交流解答。诚邀广大师生踊跃参与,深入了解产业前沿动态,共同推动智能音频技术的交流与发展。
活动信息
活动时间:7月15日(周二)19:00-20:30
观看直播:通过微信视频号直播,欢迎预约观看👇
活动议程
开场致辞 — 19:00~19:05
嘉宾简介:凌震华,中国科学技术大学教授、博士生导师、信息科学技术学院副院长,CCF语音对话与听觉专委会秘书长。主要从事语音信号处理、自然语言处理等方向的研究。
CCF先进音频技术竞赛介绍 — 19:05~19:15
嘉宾简介:朱梦尧,2009年从浙江大学博士毕业后加入上海大学,任副教授。2014年赴悉尼大学从事空间音频研究,2019年加入华为,先后负责了新型麦克风、空间音频采集与重放等技术项目,负责了多项UWA联盟Audio Vivid标准制定。2024年担任中国电子音响行业协会声音与音乐专委会副主任,2025年担任UWA联盟音频工作组联席组长。
讲解概要:首先介绍华为终端业务以及音频部;本次大赛的创立背景,技术需求与挑战,以及对于学生的需要;最后介绍本次大赛的赛程安排、赛事特点、奖项设置等。
赛事一:语音修复(讲解&QA) — 19:15~19:55
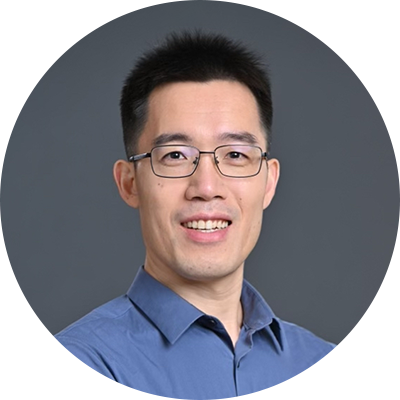
嘉宾简介:武执政博士现任香港中文大学(深圳)副教授,入选国家级青年人才,深圳市跨模态认知计算重点实验室副主任,华为火花奖获得者,并连续多次入选斯坦福大学“全球前2%顶尖科学家”榜单及获得最佳论文奖。武教授于南洋理工大学获得博士学位,曾任职于Meta(原Facebook)、苹果、爱丁堡大学及微软亚洲研究院等国际知名机构,从事学术研究和技术领导工作。武教授发起了多个开源项目,包括Merlin、Amphion和Emilia,已被全球超过700家单位采用(含OpenAI)。其中,Amphion多次登顶GitHub趋势榜,Emilia成为HuggingFace音频类最受欢迎数据集(Most Liked)。武教授发起了语音鉴伪和语音转换国际评测,并担任2019年语音合成国际评测(Blizzard Challenge 2019)的组织者。武教授现为人工智能语音领域权威期刊IEEE/ACM TASLP、SPL等编委,并出任IEEE Spoken Language Technology Workshop 2024大会主席。
讲解概要:
- 基线模型:基于AnyEnhance搭建,AnyEnhance是一个基于掩码生成模型(masked generative model)的声音增强模型,可同时处理多种录制失真(包括去噪、去混响、去削波、超分辨率等)。
- 基线框架:数据内容,官方数据训练流程,更多数据模拟流程,模型推理和评估流程介绍。
赛事二:通用音频分离(讲解&QA) — 19:55~20:30
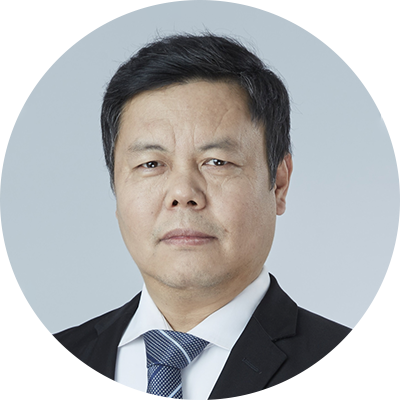
嘉宾简介:王东,爱丁堡大学博士,清华大学副研究员,清华大学人工智能研究院听觉研究中心副主任,清华大学计算机系人工智能通识教育研究中心副主任,亚太信息与信号处理联盟会杰出讲师,在Nature子刊、PAMI 等期刊和会议发表论文150余篇,出版《机器学习导论》《图解人工智能》等著作8部。王东老师是公益社区AI光影社的发起人,长期从事AI科普和教育活动,发布的《人工智能通识讲义》被全国1300多家单位下载使用。
讲解概要:
- 基线训练数据:分别使用开源数据 AISHELL-1、MUSIC(21类)作为人声、乐器声来构造训练集。为模拟房间内回声,使用开源数据 RIRs 以 0.5 的概率为原始数据添加混响。每条训练数据固定为 4 声源,其中随机有 0~2 个人声声源,其余为乐器声声源,各个声源音频混叠 SNR 在 [-3,3] 中进行均匀采样。所有数据均为 pcm_s16le 格式、16kHz 采样率的单声道音频。
- 基线模型:Conv-Tasnet,一种端到端时域音频分离模型。利用 TCN(Temporal Convolutional Network)进行掩码估计,采用 Permutation Invariant Training (PIT) 搭配 SI-SDR 损失进行模型优化,确保在多源条件下源–目标对齐和高质量分离。