
过去一年,语音与音频模型在工程化和应用层面都有不少新变化。
从 ASR 到语音合成,再到音频与对话结合的新方向,模型能力在不断演进,开发者的使用方式也在持续变化。
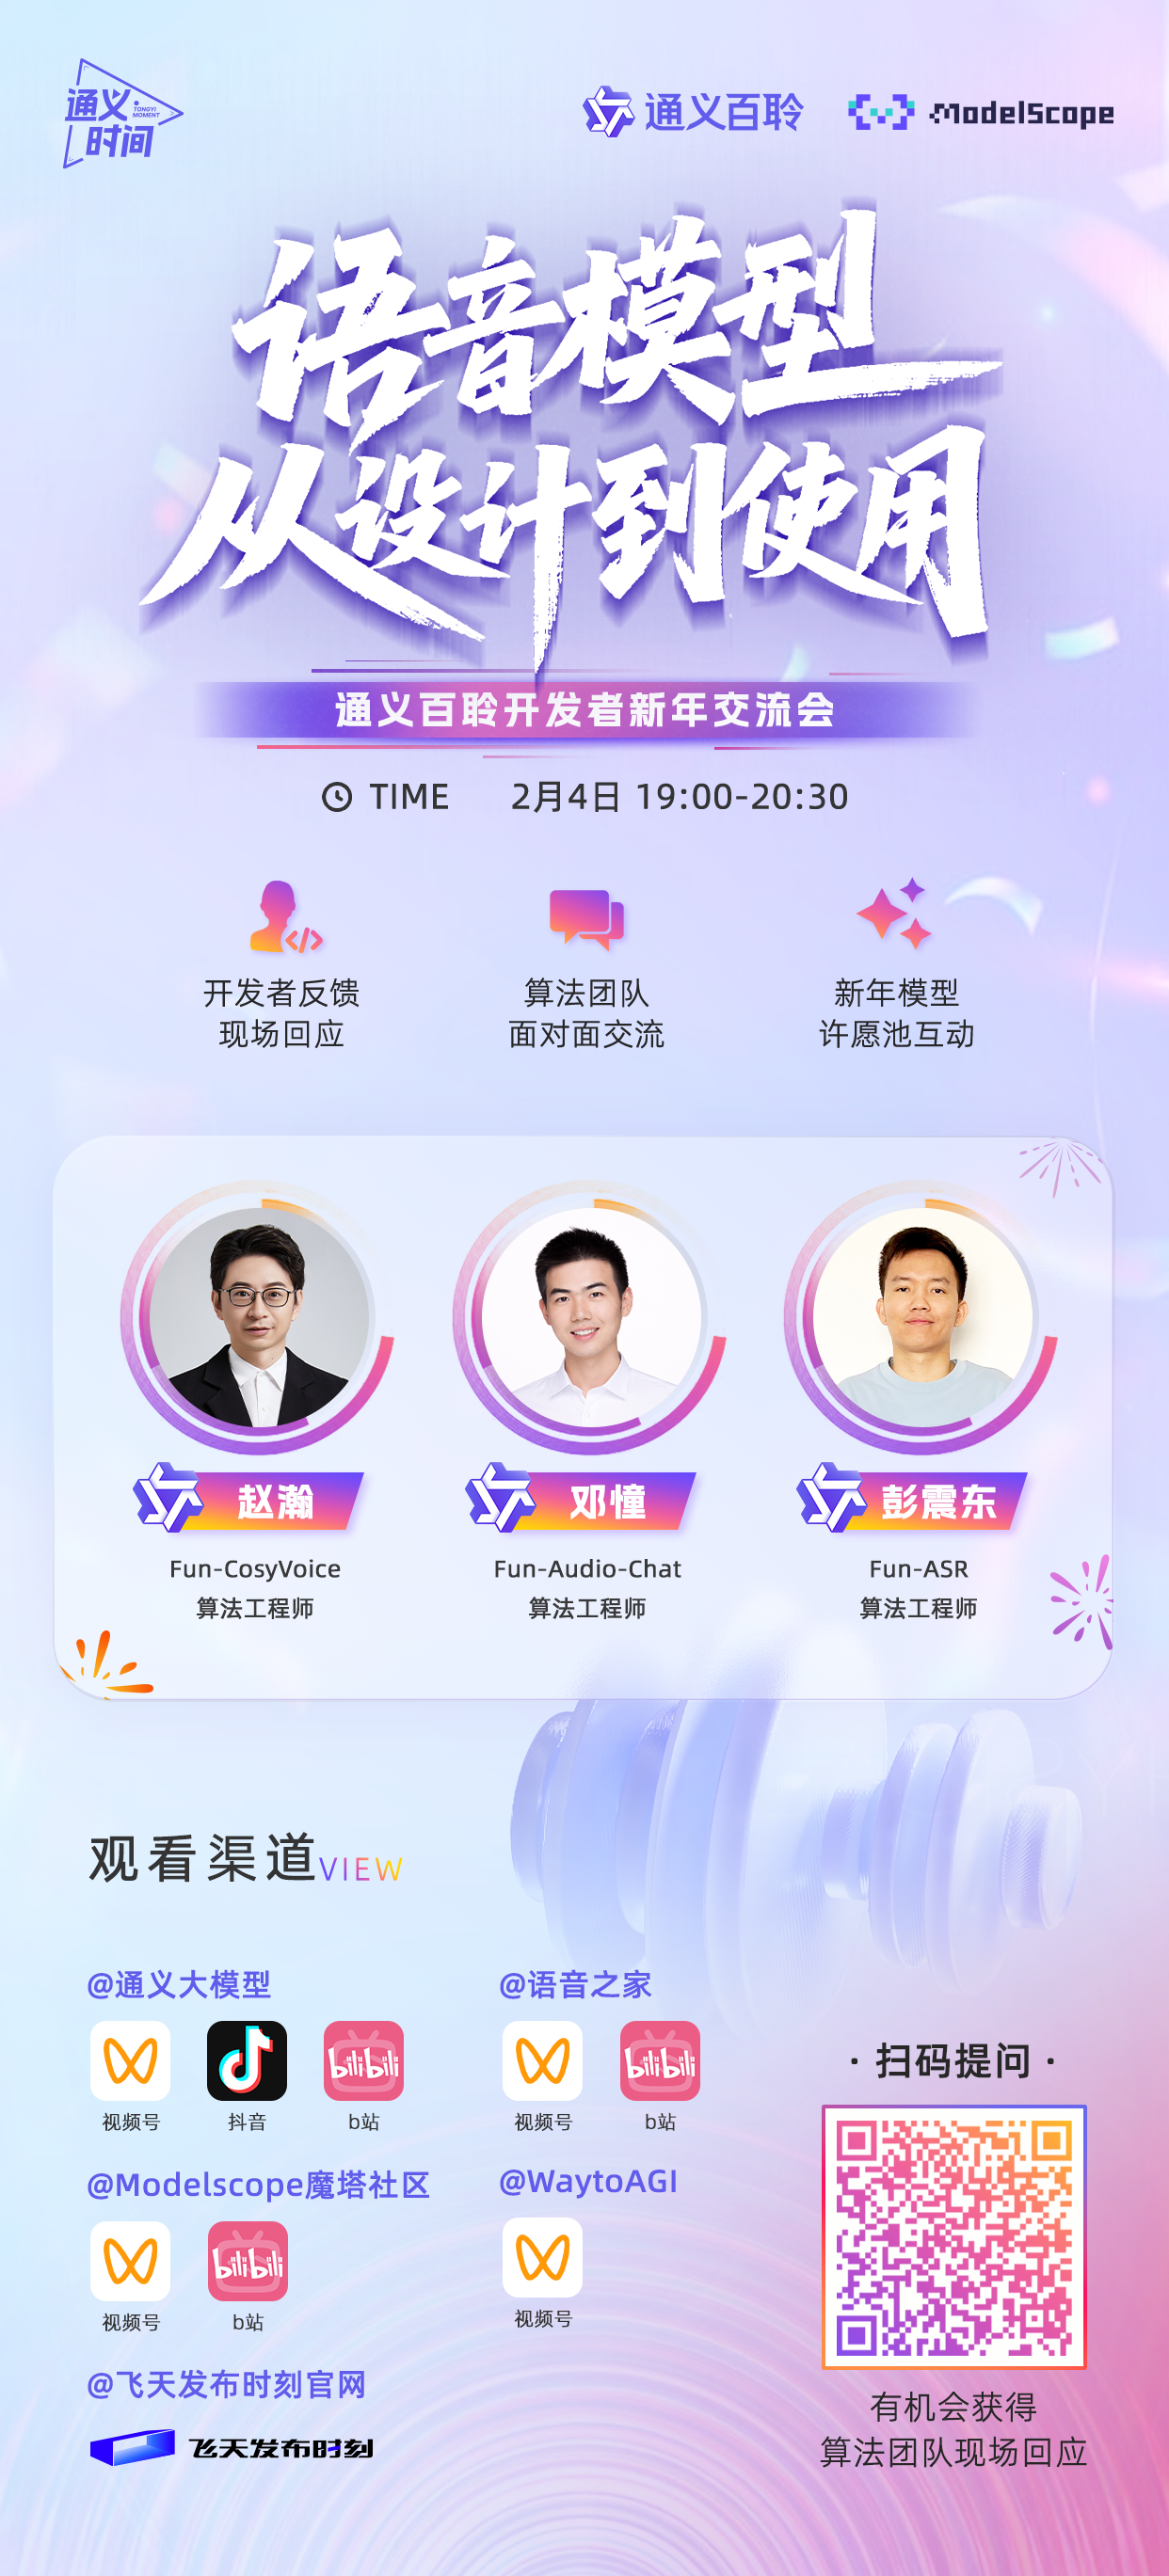
近期,通义百聆陆续发布并迭代了多款语音与音频模型,包括 Fun-ASR、Fun-CosyVoice 等模型,并推出全新的语音交互模型Fun-Audio-Chat。从社区反馈来看,不少开发者已经在实际场景中进行了尝试,也积累了一些真实的问题和思考。
在新年到来之前,通义百聆将举办一场面向开发者的线上交流直播。与常见的模型发布或单向分享不同,这场活动更强调算法团队与开发者之间的直接交流:算法老师将结合模型设计过程,分享关键判断,也会现场回应开发者在使用过程中的问题。
👾 主题:通义百聆开发者新年交流会--语音模型从设计到使用
🕖 时间:2月4日(周三)19:00~20:30
👓 观看地址:直播将通过视频号进行直播 👇👇
直播前,主办方开放了一份开发者问卷,用于提前收集模型体验反馈和交流问题。部分问题将随机选中,在直播中由算法老师现场回应。填写问卷的开发者,还有机会获得通义新年礼盒🎁。