ICASSP 2026 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 ICASSP 2026 录用论文的作者进行报告交流。
ICASSP 2026 论文预讲会第七期邀请到 萨里大学视觉语音与信号处理中心 做本次会议的专场分享,欢迎大家观看。
实验室概况
萨里大学视觉语音与信号处理中心(CVSSP)由模式识别领域的开创者之一、英国皇家工程院院士 Josef Kittler 教授于 1986 年成立,致力于机器感知(视觉、听觉)、信号处理和人工智能等方向的前沿研究。中心现有研究人员 180 余人(包括 20 余名教师、40 余名博士后及近 100 名博士生),由英国皇家工程院院士 Adrian Hilton 教授领衔。CVSSP 在计算机视觉和音视频人工智能领域长期位居全英前列,拥有世界级的音视频采集设备以及大规模计算与存储平台(1000+ CPU、300+ GPU、2PB 存储)。
CVSSP 机器听觉实验室目前有约 30 名研究人员,在王文武、Mark Plumbley 和 Philip Jackson 三位教授的带领下,围绕语音、音乐及一般声音(如环境声音、声音事件与声学场景)开展信号处理与人工智能研究,同时积极拓展音视频理解与多模态智能方向。相关研究任务涵盖音频与音视频的降噪、增强、分离、定位、跟踪、检测、分类、识别、标注、检索、生成、编辑等等,以及面向复杂场景的音视频事件理解、跨模态推理与生成建模,并涉及超分辨、表示转换与高效编码等多个层面。
第七期-萨里大学视觉语音与信号处理中心(CVSSP)【专场】
时间:3月16日(周一)19:00 ~ 20:40
形式:线上
议程:每位嘉宾分享20分钟(含5分钟QA)
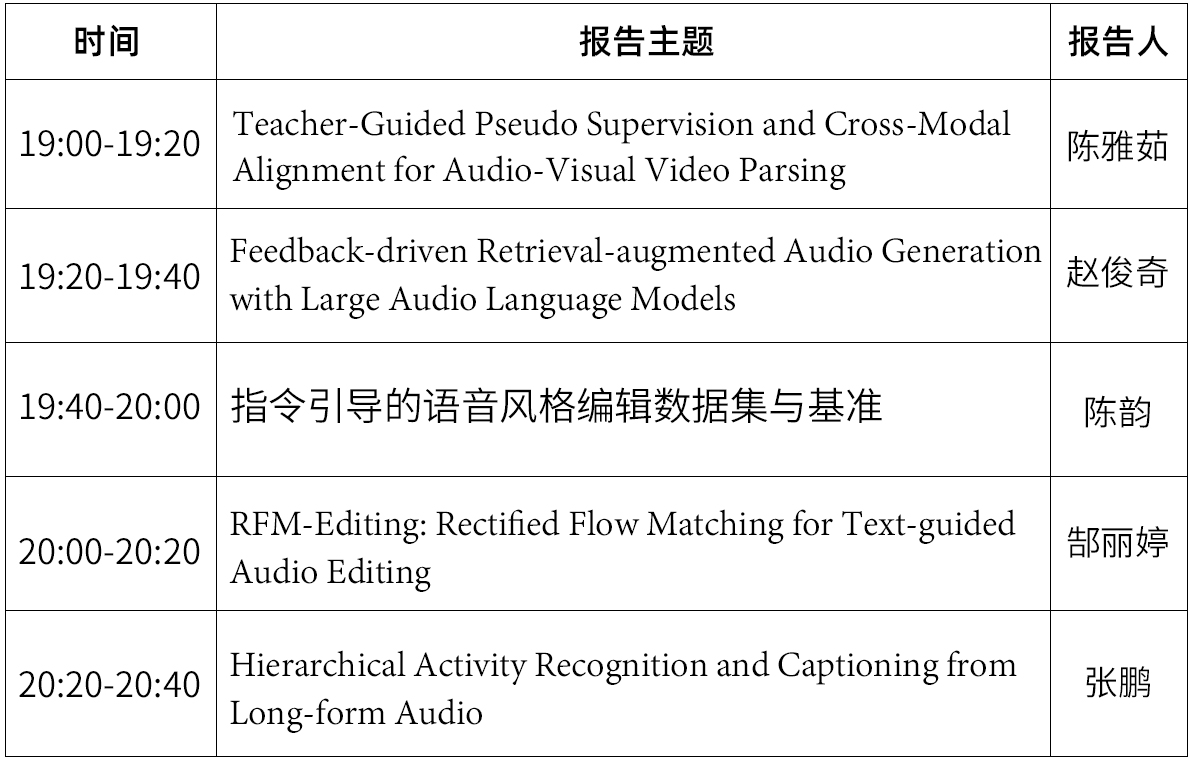
嘉宾&主题
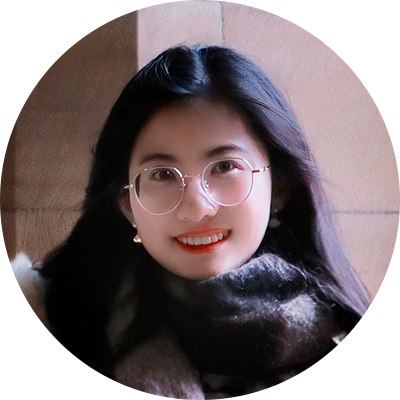
嘉宾简介:陈雅茹,萨里大学视觉语音与信号处理中心2022级博士研究生,师从王文武教授,研究方向为基于自然场景下的视频解析,研究内容为视听事件检测与定位。在ICASSP, ICMR, CVPR, Information Fusion等期刊会议发表文章若干。
分享主题:Teacher-Guided Pseudo Supervision and Cross-Modal Alignment for Audio-Visual Video Parsing
摘要:弱监督音视频视频解析(AVVP) 旨在在缺乏时间标注的情况下,检测可听事件、可见事件以及音视频联合事件。以往工作主要通过对比学习或协同学习来优化全局预测,但在稳定的段级监督以及类别感知的跨模态对齐方面仍然不足。为此,我们提出了两项关键策略:(1)一种指数滑动平均(EMA)引导的伪监督框架,通过自适应阈值或 Top-k 选择生成可靠的段级掩码,从而在仅有视频级标签的条件下提供稳定的时间指导;(2)一种类别感知的跨模态一致性(CMA)损失,在可靠的段–类别对上对齐音频与视觉嵌入,在保持时间结构的同时促进跨模态一致性。在 LLP 和 UnAV-100 数据集上的实验结果表明,所提出的方法在多项评价指标上均取得了当前最优(SOTA)性能。
论文链接:https://arxiv.org/abs/2509.14097
嘉宾简介:赵俊奇,萨里大学视觉语音与信号处理中心2023级博士研究生,研究方向为多模态声音生成,研究内容包括文生音频,歌曲生成和音频分离等。在ICASSP,INTERSPEECH, EUSIPCO等期刊会议发表文章若干。
分享主题 :Feedback-driven Retrieval-augmented Audio Generation with Large Audio Language Models
摘要:我们提出了一种通用的、基于反馈驱动的检索增强生成(RAG)方法,利用大型音频语言模型(Large Audio Language Models, LALMs)来解决文生音频(Text-to-Audio, TTA)中某些特定声音事件缺失或生成不理想的问题。不同于以往基于 RAG 的 TTA 方法通常需要从零开始训练专用模型,我们的方法利用微调后的LALMs 对生成的音频结果进行分析,从外部数据库中检索出预训练音频生成模型难以直接生成的概念,并将这些检索到的音频信息融入到生成过程中。实验结果表明,我们不仅提升了 LALMs 识别缺失声音事件的能力,而且所提出的方法能够在不同模型之间实现稳定的性能增益,其效果优于现有的基于 RAG 的专用方法。
嘉宾简介:陈韵,萨里大学博士二年级,师从 Mark D. Plumbley 教授。其研究方向为表达性语音生成与编辑,关注语音风格的可控建模与细粒度表达,并对基于自然语言指令的语音编辑方法具有长期研究兴趣;此外,也涉及融合语音、文本与视觉信息的多模态表达性语音合成,以探索更加自然、灵活的语音生成与人机交互形式。
分享主题:指令引导的语音风格编辑数据集与基准
摘要:语音风格编辑旨在在保持语音语言内容和说话人身份不变的前提下,修改语音的风格属性。然而,现有的大多数方法依赖于显式的风格标签或参考语音,这在灵活性和可扩展性方面均存在明显限制。近期一些工作尝试使用自然语言描述进行风格控制,但仍受限于指令表达过于简化、风格控制粒度较粗等问题。为解决上述局限,我们提出了指令引导的语音风格编辑数据集(ISSE)。该数据集包含近 400 小时语音数据和 10 万余对源–目标语音样本,每一对样本均与多样且细粒度的文本编辑指令精确对齐。此外,我们构建了一套系统化的指令式语音数据生成流程,结合大语言模型、情感化文本到语音合成以及语音转换技术,以生成高质量的配对语音样本。在此基础上,我们在 ISSE 上训练了一个指令引导的自回归语音生成模型,并从指令遵循性、音色保持性和内容一致性等方面对其性能进行了评估。实验结果表明,与其他数据集相比,ISSE 能够支持更加准确、可控且具有良好泛化能力的语音风格编辑。
论文链接:https://arxiv.org/pdf/2509.24570
Demo链接:https://ychenn1.github.io/ISSE/
嘉宾简介:郜丽婷,萨里大学视觉语音与信号处理中心2025级博士研究生,导师为王文武教授,研究方向为通用音频编辑,研究内容为基于扩散模型的文本引导音频编辑。研究生期间曾在ICASSP2026(Accepted),IEEE Signal Processing Letters及ACM IH&MMS上发表论文。
分享主题 :RFM-Editing: Rectified Flow Matching for Text-guided Audio Editing
摘要:扩散模型在文本到音频生成TTA任务中已经展现出显著的进展。然而,文本引导的音频编辑仍处于早期发展阶段。该任务旨在在保留音频中其余内容不变的前提下,对目标内容进行修改,因此对基于文本指令的精确定位能力和高保真编辑提出了较高要求。现有的基于训练的方法以及零样本方法通常依赖完整的音频描述或代价高昂的优化过程,在处理复杂编辑场景时往往面临困难,或在实际应用中缺乏可行性。本文提出了一种新颖的、端到端且高效的基于修正流匹配(Rectified Flow Matching)的扩散文本引导的音频编辑框架,并构建了一个包含多事件重叠音频的数据集,以支持复杂场景下的模型训练与基准评测。实验结果表明,在无需辅助描述或显式掩码的情况下,所提出的方法能够实现与语义高度一致的编辑效果,并在多项评价指标上保持具有竞争力的编辑质量。
论文链接:https://arxiv.org/abs/2509.14003
Demo链接:https://katelin-glt.github.io/RFM-Editing-Demo/
嘉宾简介:张鹏,萨里大学视觉语音与信号处理中心2025级博士研究生,师从王文武教授,研究方向为音视联合场景理解。
分享主题:Hierarchical Activity Recognition and Captioning from Long-form Audio
摘要:现实场景中的日常行为往往具有较长持续时间和层次结构,而现有研究多集中于短音频和简单事件。为探索这一问题,我们构建了 MultiAct 数据集,涵盖长时音频中的活动、子活动和事件等多层级标注,并配有相应的文本描述与摘要。同时,我们尝试了一种统一的层次化建模思路,初步探索长时音频中多层次行为理解与描述生成的可行性,希望为后续研究提供参考。
参与方式
直播将通过语音之家微信视频号进行直播
手机端、PC端可同步观看
👇👇👇
预讲会征集
ICASSP 2026 论文预讲会面向全球线上招募,结合定向邀请与征集报名的方式,来选择预讲会的嘉宾。

为了共创高质量的论文预讲会,我们诚挚邀请所有 ICASSP 2026 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。