
ACL 2026 | 超越句子级标签:融合对话上下文与个人经历的自然情感语音合成

ACL(Annual Meeting of the Association for Computational Linguistics)是计算语言学与自然语言处理(NLP)领域最具影响力的国际学术会议之一,每年汇聚全球顶尖学者、研究机构与工…
191 0 0


ACL(Annual Meeting of the Association for Computational Linguistics)是计算语言学与自然语言处理(NLP)领域最具影响力的国际学术会议之一,每年汇聚全球顶尖学者、研究机构与工…

全双工语音对话模型(Spoken Dialogue Model, SDM)已经能够同时进行听、说与被打断的实时交互。但一个更基础的问题始终没有被充分回答: 为全双工 SDM 设计强化学习训练时,应当以何种信号作为奖励? 现有方法大多只覆盖评…
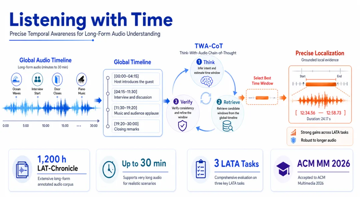
近年来,基于大语言模型(LLM)的音频大语言模型(Large Audio Language Models, LALMs)在音频理解任务上取得了显著进展,在短音频场景中已经展现出优异的性能。然而,当输入扩展到播客、访谈、会议、直播等常见的持续…
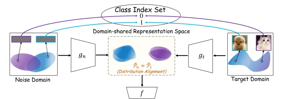
SSNA团队 投稿,量子位 | 公众号 QbitAI 迁移学习里的“源数据”,未必非得是图像、文本或音频。 一组从高斯分布里随机采样出来、没有任何语义的噪声,也能帮助模型在少量标注下学得更好。 这项工作名为半监督噪声自适应(Semi-Sup…

通义千问正式发布第三代图像生成基座模型 Qwen-Image-3.0,重点提升复杂指令理解、信息图生成与文字渲染能力。 核心特点 内容丰实:支持最大4.5k token输入,轻松生成报纸、分镜、试卷等复杂版面。 细节真实:支持 10px 小…

Qwen-Audio-3.0-TTS实时语音合成模型发布。本次发布包含两个版本: Flash:面向实时交互,首包延迟在300ms左右。 Plus:面向高质量生成,在自然度和音色还原度上表现更佳。 本次更新,我们把精力放在了开发者在生产环境中…

GitHub:https://github.com/Eps-Acoustic-Revolution-Lab/EAR-Audio-Preview VS Code Marketplace:https://marketplace.visualst…
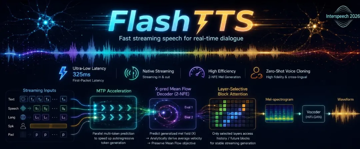
近年来,基于大语言模型(LLM)的文本转语音技术快速发展,基于大语言模型(LLM)的TTS方案已经在自然度、音色相似度和零样本音色克隆(zero-shot voice cloning)等方面取得显著进展。然而,随着语音助手、实时语音对话、虚…
