语音合成和语音识别资料查询说明
文章转载请标明出处:微信公众号 低调奋进 个人网站http://yqli.tech/本来整理语音合成相关的文章、数据以及开源工具等等。现在,我对资料进行整理,添加了语音识别模块,在这里分享给大家,节省读者查找资料的时间。接下来,我给大家详细…
490 0 0


文章转载请标明出处:微信公众号 低调奋进 个人网站http://yqli.tech/本来整理语音合成相关的文章、数据以及开源工具等等。现在,我对资料进行整理,添加了语音识别模块,在这里分享给大家,节省读者查找资料的时间。接下来,我给大家详细…

受到 Google 一篇论文CASCADED ENCODERS FOR UNIFYING STREAMING AND NON-STREAMING ASR的启发,准备采用级联编码来改善 Second Pass 的识别效果。 最近也有其他离在线…

本文是OpenSpeaker系列的第二篇文章,全系列可参考这篇文章或者文末的专栏: https://zhuanlan.zhihu.com/p/419848589 根据规划,今天先来看第一部分数据整理: OpenSpeaker

云 知 声 (社 招) (语音识别/声纹识别)算法研究员 上海 [ 岗位职责 ] 1、负责语音识别/关键词检索/声纹识别算法的研究; 2、负责语音识别/关键词检索/声纹识别算法引擎开

0、摘要 本文总结了使用大型自动语言识别(ASR)模型进行的大量工作的结果,这些模型使用了包含大约一百万小时音频的无标签数据集进行预训练。作者发现,预训练、自监督训练和增大模型大小这三种方法的结合可以极大地提高数据有效利用率,即使对具有数万…
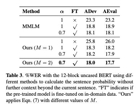
1、研究背景 预训练模型的Bert, GPT,GPT2为下游诸多nlp任务提供很好的帮助,但其在ASR中应用却很少研究,因此本文主要研究这些预训练模型Bert, GPT,GPT2在ASR中的应用。 2、详细设计 本文主要回顾一下Transf…

声明:平时看些文章做些笔记分享出来,文章中难免存在错误的地方,还望大家海涵。平时搜集一些资料,方便查阅学习:http://yqli.tech/page/speech.html。 如转载,请标明出处。欢迎关注微信公众号:低调奋进 Tied &…

这次要分享的是出门问问最近分享的一篇 Paper Unified Streaming and Non-streaming Two-pass End-to-end Model for Speech Recognition,他们团队还并奉上了训…