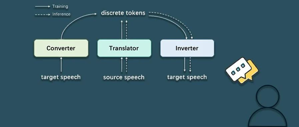
AAAI 2021 | 不依赖文本也能做翻译?UWSpeech语音翻译系统了解一下

语音到语音翻译已经被越来越多地应用在人们的日常生活和工作中。但是目前的语音翻译系统高度依赖于语音对应的文本,不能应用于如方言、少数民族语言等没有文字的语言。为此,微软亚洲研究院提出了语音翻译系统 UWSpeech,该系统可针对没有文字的语言…
61 0 0


语音到语音翻译已经被越来越多地应用在人们的日常生活和工作中。但是目前的语音翻译系统高度依赖于语音对应的文本,不能应用于如方言、少数民族语言等没有文字的语言。为此,微软亚洲研究院提出了语音翻译系统 UWSpeech,该系统可针对没有文字的语言…
Mel-filterbank经常被用于训练声音分类算法,然而它存在的偏差也令其有明显的局限性。近日,Google提出了一种优于Mel-filterbank的前端LEAF,这种前端可以创建出具有最小偏差的音频分类模型。 在机器学习中,梅尔滤波…
说起语音识别,大家的第一反应就是那些看起来眼熟却总也搞不清楚的概念和公式,比如MFCC、HMM、GMM、Viterbi图、解码对齐等等,再往下深入,哪个是哪个,具体用途是什么,就都说不清楚了,总觉得那得是业内大牛才能搞懂的。去网上搜索,各种…

歌唱合成SVS(singing voice synthesis)是根据歌词和乐谱信息合成歌唱,相比于TTS使机器“开口说话”,歌唱合成则是让机器唱歌,因此更具有欣赏性。 互联网的时代,人机交互更加频繁和智能,歌唱合成则添加了人机交互的趣味性…

基于深度学习的端到端语音合成技术进展显著,但经典自回归模型存在生成速度慢、稳定性和可控性差的问题。 去年,微软亚洲研究院和微软 Azure 语音团队联合浙江大学提出了快速、鲁棒、可控的语音合成系统 FastSpeech,近日研究团队又将该技…

单音子模型的假设是一个音素的实际发音与其左右的音素无关。这个假设与实际并不符合。由于单音子模型过于简单,识别结果不能达到最好,因此需要继续优化升级。就此引入多音子的模型。最为熟悉的就是三音子模型,即上下文相关的声学模型。以kaldi的thc…

高仿真的音频合成需要处理高采样率的音频数据,尤其是歌唱合成。相对于使用16kHz和24kHz的音频,使用48kHz的音频将会覆盖更宽的频带和更长的音频序列,这将给音频合成造成极大的挑战。本文针对使用48kHz音频带来的问题,提出了HiFiS…

WACV 2021的录用论文Visual Speech Enhancement Without A Real Visual Stream。该文研究涉及计算机视觉与语音处理的交叉。 论文信息

在刚刚结束的NIST OPENASR评测中,TEG AI语音联合清华大学,刷新世界小语种语音识别比赛6项第一。从2000年开始,NIST组织的RT(英文语音识别),LRE(语音语种识别),SRE(语音说话人识别),OPENKWS(语音关键词…

PyTorch + Kaldi,腾讯 AI Lab 开源轻量级语音处理工具包 PIKA,专注于端到端语音识别任务。 Kaldi 是一个开源的语音识别系统,由 Daniel Povey 主导开发,在很多语音识别测试和应用中广泛使用。但它依赖大…