
 语音小管家
本期将介绍上海交通大学听觉认知与计算声学实验与 Microsoft Research Asia 合作完成的论文 TF-MoE: Time-Frequency Mixture-of-Experts for Efficient Speech Separation,分享一项面向低算力语音分离的最新研究成果。
近年来,语音分离(Speech Separation, SS)前端模型的参数量已经明显下降,但计算量仍然偏高,端侧部署依然受限。为了解决这个问题,我们提出了 TF-MoE,一种稀疏 Mixture-of-Experts(MoE)框架,目的是在几乎不增加推理成本的情况下提升模型容量。TF-MoE 建立在 mel-band-splitting Conformer 主干上,并交替引入时间维和频率维 MoE 模块:时间维模块按帧选择专家,频率维模块按 mel 频带选择专家,使专家在时频两个维度上动态分工。在 Libri2Mix 数据集上,TF-MoE 以约 4.1 GMACs/s 的推理成本,相比相近复杂度的 BSRNN 模型获得 3.8 dB SDR 提升,显示出面向边缘设备部署的潜力。
TF-MoE: Time-Frequency Mixture-of-Experts for Efficient Speech Separation
作者列表:Qinzhe Hu, Chenda Li, Wangyou Zhang, Shujie Liu, Yan Lu, Yanmin Qian
合作单位:Shanghai Jiao Tong University; Microsoft Research Asia
研究背景与动机
🔍 被忽视的算力瓶颈
语音分离(Speech Separation, SS)要做的不只是把混合语音分开,还要在手机、耳机、会议设备等现实端侧设备上稳定、低延迟地运行。随着隐私保护、低延迟交互和离线可用性成为实际部署中的硬约束,语音分离模型越来越需要适应资源受限的边缘设备。
但“模型小”并不等于“算得省”。已有高效语音分离模型可以把参数量压到千万级以下,计算开销却仍可能达到数十甚至数百 GMACs/s。对边缘设备来说,存储空间当然重要,但实时处理能力和功耗往往更先成为瓶颈。这也是 TF-MoE 关注的核心问题:如何在低计算量下保留足够的模型容量?
一个容易想到的解决方法是压缩网络隐藏维度,这确实可以降低计算量,但模型容量也会被压缩,分离质量往往随之下降。为了在“低算力”和“高容量”之间找平衡,我们引入了 Mixture-of-Experts(MoE)机制[1]:模型内部包含多个专家子网络,每次推理只激活其中一小部分。因此,模型总容量可以增加,而实际参与计算的部分仍然可控。
技术方案
🔍 从BSRNN 到 TF-Conformer
在搭建主干网络时,我们基于 BSRNN[2] 的 band-split 思路构建了 TF-Conformer。相比 BSRNN,TF-Conformer 做了两处调整:一是把人工设计的频带划分换成 mel-scale 频带划分;二是把 RNN 序列建模模块换成 Conformer[3],用于建模跨频带依赖和时间动态。
输入混合语音后,模型先在频域上把其复数谱划分为 K 个 mel 频带,并投影到统一特征空间。随后,F-module 负责频率方向的信息交互,T-module 负责时间方向的变化建模;最后模型估计复数掩码,重建分离后的语音。
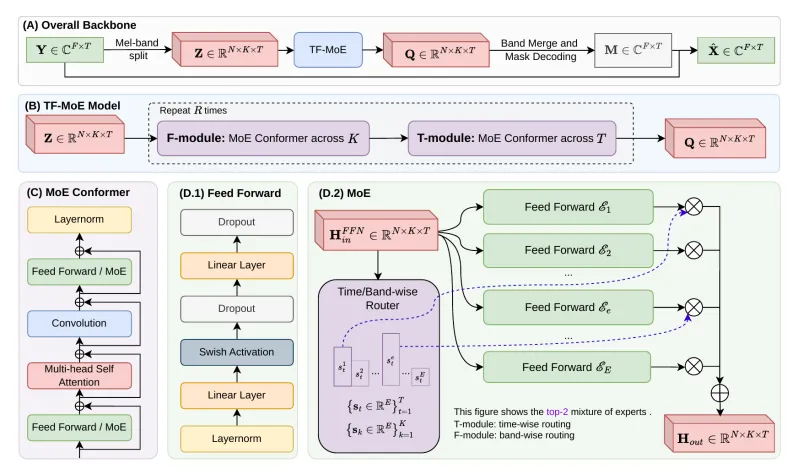
图1. TF-MoE 框架概览(论文 Figure 1)(A) TF-Conformer 主干;(B) TF-MoE 模型结构;(C) MoE Conformer block,其中标准 FFN 被 MoE FFN 替换;(D.1) 标准 FFN;(D.2) 采用 top-J 稀疏路由的 MoE FFN。
🔍 将 FFN 替换为稀疏MoE
标准 Conformer 里的 Feed-Forward Network(FFN)占据了相当一部分参数和计算。我们把这部分换成稀疏门控的 MoE FFN:每层包含多个结构相同、参数独立的专家网络,再由一个轻量路由器为当前输入选择专家。
在默认 top-1 路由下,每个输入只激活一个专家,因此专家部分的计算量接近普通 FFN。额外开销主要来自路由器。以 N=32、E=12 为例,路由只带来约4.7%的额外计算;但 FFN 不再只有一组参数,而是有多组专家参数可选。
🔍 时频双维度的专家路由
TF-MoE 没局限于只在时间维做 MoE,而是在时间和频率两个维度同时路由。在 T-module 中,路由器按时间帧选择专家,可以随有声、清音、静音或不同说话人状态切换;在 F-module 中,路由器按 mel 频带选择专家,让不同专家对应低频谐波、高频成分等频谱模式。
也就是说,专家的选择同时发生在时间帧和频带上。时间维专家更关注语音活动和说话人模式的变化,频率维专家则更稳定地对应不同频段的谱结构。
不过,MoE 训练还需要避免专家使用不均衡:如果输入长期集中到少数几个专家,其他专家几乎用不上,模型容量就没有被充分利用。为此,我们在训练中加入专家均衡损失,鼓励路由器更均匀地使用不同专家。最终目标由语音分离损失和专家均衡损失共同组成。
实验结果与分析
🔍 主实验结果:低计算量下保持高分离质量
表1. Libri2Mix 16 kHz 主实验结果(论文 Table 1)
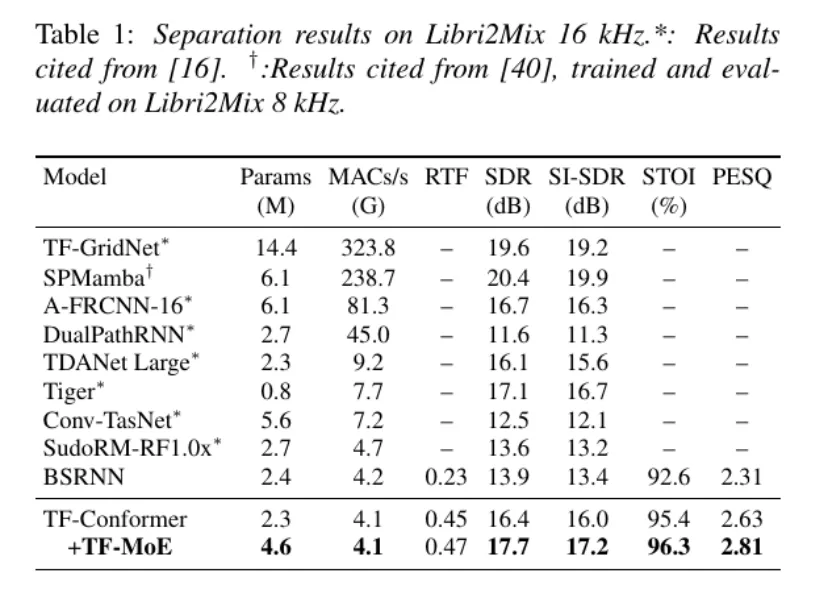
在 Libri2Mix 16 kHz 数据集上,TF-MoE 以约4.1 GMACs/s的计算量取得17.7 dB SDR和17.2 dB SI-SDR。相比 BSRNN,它在几乎相同计算开销下带来3.8 dB SDR提升;与不含MoE的TF-Conformer 主干相比,SDR进一步提升1.3 dB SDR,而 MACs/s 基本保持不变。
这说明 MoE 带来的主要变化不是让每次推理都走更重的计算路径,而是增加了模型内部可选择的专家参数。论文对比显示,TF-MoE 的 SDR 高于 A-FRCNN-16[4],而计算量仅为后者的 1/20;同时也高于 TDANet Large[5]、Tiger[6] 等模型。
🔍 消融实验:时间维和频率维都有效
表2. T/F 模块消融实验(论文 Table 2)
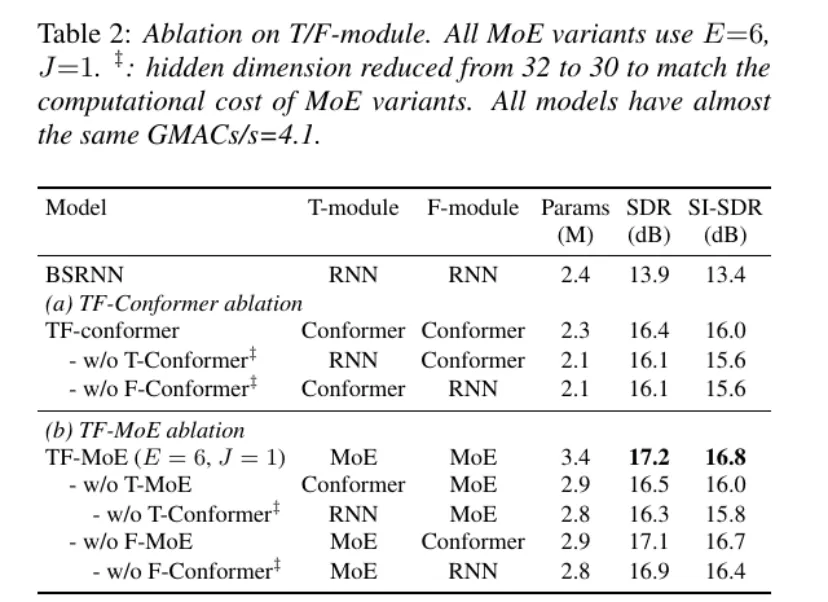
表 2 主要回答两个问题:Conformer 主干是否必要,以及时间维和频率维的 MoE 是否都有效。结果显示,单独加入 T-MoE 或 F-MoE 都能带来提升,两者结合时效果最好,说明时间维和频率维捕捉到的信息并不重复。另一方面,将时间或频率模块中的 Conformer 换成 RNN 后性能会下降,也说明 Conformer 主干本身对分离效果有贡献。
🔍 专家数量:不是越多越好
表3. 不同专家数量 E 的消融实验(论文 Table 3)
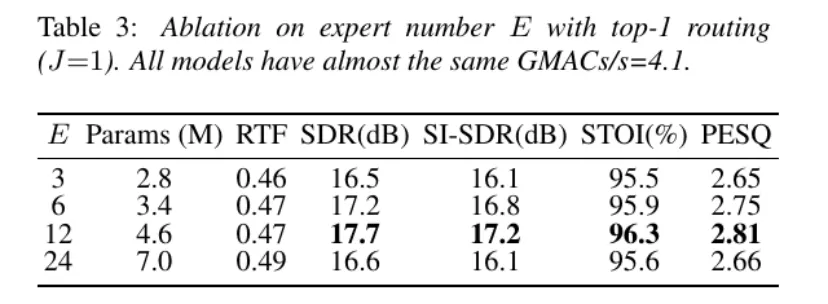
专家数量也不是越多越好。表 3 中,E 从3增加到12时,SDR 从16.5 dB提升到17.7 dB;继续增加到24时,反而降到16.6 dB。专家池过大时,路由器需要在更多候选专家之间学习分配策略,训练难度反而会增加。
🔍 路由可视化:专家真的在分工吗
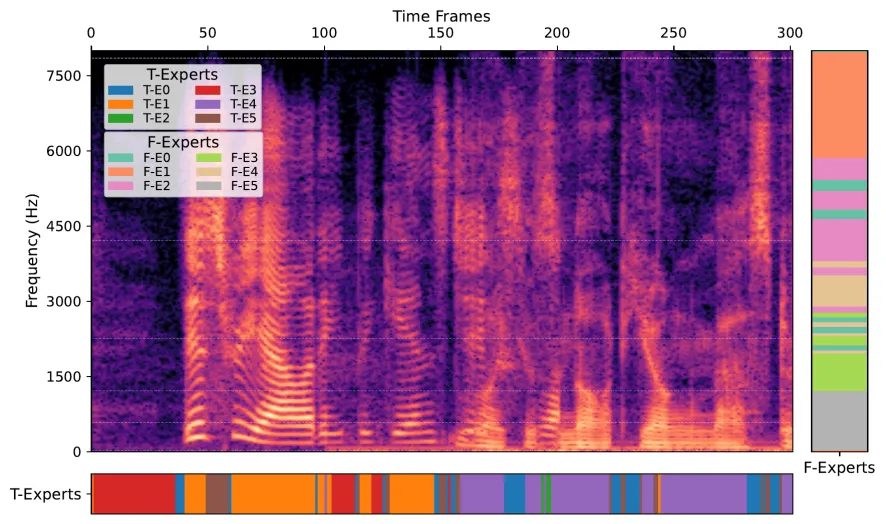
图2. 专家路由可视化(论文 Figure 2)。该图展示第 5 个 TF-MoE block 中第一个 Feed Forward module 的路由结果:上方为输入信号的时频谱图,包含女声、混合语音和男声片段;下方为 T-MoE 沿时间轴的专家选择,右侧为 F-MoE 沿 mel 频带轴的专家选择,不同颜色表示不同专家。
我们进一步可视化了 TF-MoE 的路由结果。频率维度上,不同 F-MoE 专家会稳定对应不同频率区域,形成频带专门化;时间维度上,T-MoE 专家的选择会随时间帧变化,对应女声片段、重叠语音、男声片段或静音等状态。
从图中可以看到,路由并不是随机分配。一些专家更常出现在特定频带,另一些专家会随时间和说话模式变化而切换。这也解释了为什么适中的专家数量已经足够,专家过多反而会增加路由学习难度。
本文总结
这项工作让我们看到,在算力受限的语音分离任务中,与其一味压缩小模型,不如让模型学会按需分配计算。时频双维度路由一方面控制了推理成本,另一方面让专家分工更加清晰,在控制计算量和细化专家分工之间找到了一个平衡点。
后续我们也希望继续探索这类稀疏路由机制在端侧语音分离及相关任务中的应用。如果你对这项工作感兴趣,可以点击阅读原文查看论文。
参考文献
[1] N. Shazeer, A. Mirhoseini, K. Maziarz, A. Davis, Q. Le, G. Hinton, and J. Dean, "Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer," ICLR 2017.
[2] J. Yu and Y. Luo, "Efficient Monaural Speech Enhancement with Universal Sample Rate Band-Split RNN," ICASSP 2023.
[3] A. Gulati, J. Qin, C.-C. Chiu, N. Parmar, Y. Zhang, J. Yu, W. Han, S. Wang, Z. Zhang, Y. Wu, and R. Pang, "Conformer: Convolution-augmented Transformer for Speech Recognition," Interspeech 2020.
[4] X. Hu, K. Li, W. Zhang, Y. Luo, J.-M. Lemercier, and T. Gerkmann, "Speech separation using an asynchronous fully recurrent convolutional neural network," Advances in Neural Information Processing Systems, vol. 34, pp. 22509-22522, 2021.
[5] K. Li, R. Yang, and X. Hu, "An efficient encoder-decoder architecture with top-down attention for speech separation," ICLR 2023.
[6] M. Xu, K. Li, G. Chen, and X. Hu, "TIGER: Time-frequency interleaved gain extraction and reconstruction for efficient speech separation," ICLR 2025.
供稿:胡钦哲,编辑:刘丫,审核:张王优,钱彦旻
