
 语音小管家
AudioCC交我学
今天,我们探讨一下如何让生成的声音准确地“落”在正确的方位。
过去两年,文本生成音频已经相当成熟,但绝大多数模型交付的仍是单通道音频——它解决了“发出什么声音”,却回避了“声音从哪里来”。而在 VR/AR、具身智能、影音娱乐这些场景里,方位感恰恰是沉浸感的来源。
本文梳理端到端空间音频生成方向的三项代表性工作:SpatialSonic (配套数据集 BEWO-1M)、OmniAudio (配套数据集 Sphere360 )与 ImmersiveFlow。三者的输出维度逐级抬升——从两声道,到四声道 FOA,再到十二声道的 7.1.4——恰好勾勒出这一方向的演进轨迹。
一、背景:两阶段与端到端
1. 主流做法与其代价
传统方案是两阶段的:先用生成模型或素材库拿到一段单通道音频,再通过房间冲激响应(Room Impulse Response, RIR)卷积或头相关传递函数(Head-Related Transfer Function, HRTF)滤波把它“摆”到指定方位。这条路线控制灵活、方位可实时调整,但存在两个结构性问题:一是单通道音频生成和空间冲激响应生成两个子系统各自优化,误差会逐级累积;二是它默认声源是点声源,对瀑布、海浪这类分布式声源无能为力,也无法建模“鸟叫通常来自上方”这类语义与空间的耦合关系。
端到端方案则跳过 RIR 环节,让模型直接输出多通道波形。代价是方位控制不如两阶段灵活,难以满足游戏等场景的实时调整需求;收益是空间感与音频内容强绑定,可以直接从真实录制的空间音频中学习,沉浸感更真实。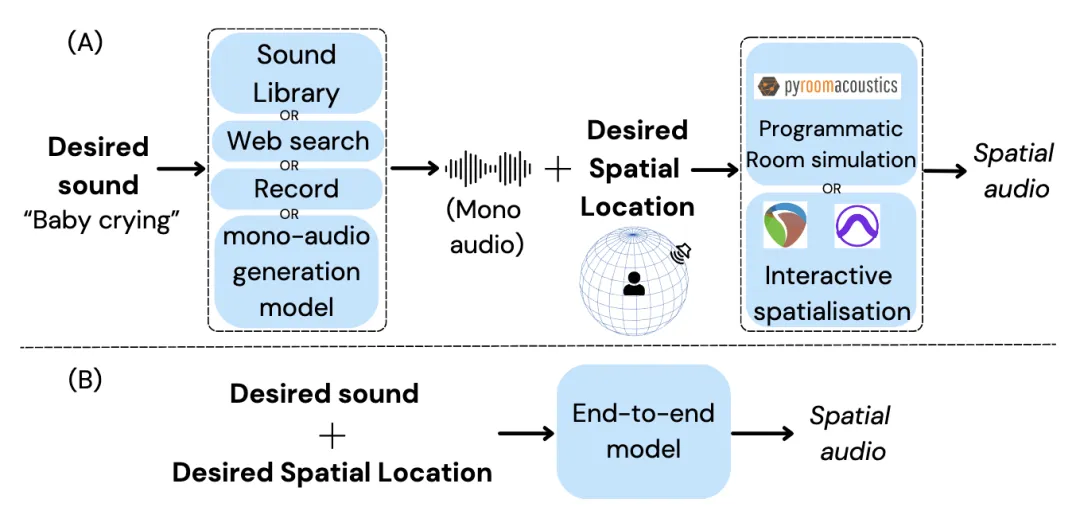 图1 两阶段方法(上)与端到端方法(下)的流程对比
2. 任务划分与评价指标
端到端空间音频生成是近几年才兴起的概念,通常按输入输出类型来定义具体任务:输入可以是文本描述、图像、视频、声音类别或坐标,输出则涵盖双耳立体声、一阶 Ambisonics(First-Order Ambisonics, FOA)、7.1.4 全景声等格式。
评价上分两个维度:
音频质量:Fréchet 距离(FD)、Fréchet 音频距离(FAD)、Inception Score(IS)、KL 散度、CLAP 分数等,衡量生成音频与真实音频在分布上是否接近、与文本是否对得上。
空间准确度:多数基于双耳时间差(Interaural Time Difference, ITD),如 GCC MSE 与 CRW MSE;FOA 格式则直接计算方位角、俯仰角与总角度误差。需要注意的是,ITD 类均方误差把整段音频取平均后再比较,遇到运动声源时“从左到右”和“从右到左”会相互抵消,分辨不出运动方向——这正是下文 FSAD 指标要解决的问题。
二、SpatialSonic:从语言到双耳立体声
ICLR 2025 的这项工作来自香港科技大学等机构,是作者所知第一个系统性解决“语言驱动空间音频生成”的尝试。
1. 问题与动机
现有路线两头不讨好:两阶段方法开销大、误差累积;一阶段方法(如 Stable Audio)虽能直接输出立体声,但方位是随机、模糊、不可控的。作者把挑战归为三点——数据规模不够、缺乏精确的空间引导、缺乏合适的评价指标。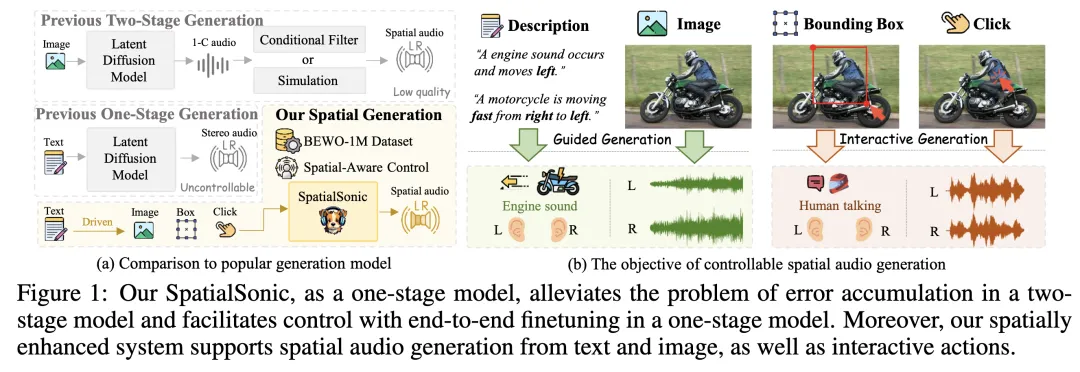 图 2 与已有生成模型的对比(左)及可控空间音频生成的目标(右)
2. BEWO-1M 数据集
给立体声标注空间描述的人力成本极高,作者因此设计了半自动流水线:先从 AudioCaps、WavCaps、VGGSound 等公开数据中筛出单一声源片段,做声音活动检测、裁成 10 秒,再用 CLAP 过滤音文不匹配的样本;然后用 GPT-4 与 GPT-4o 结合思维链提示,把“一只狗在叫”这类原始标注改写成含方位与运动的描述,同时推断出场景大小、声源位置、运动方向与速度;最后用 Pyroomacoustics 与 gpuRIR 做物理仿真生成立体声,测试集与部分训练集经人工核验。
最终得到 2.8k 小时训练音频、超过 100 万条音频-文本对,验证集约 17 小时、6.2k 对,另有 2.3k 条图像配对样本。数据覆盖单源静止(SS-set)、双源静止(DS-set)、单源运动(SD-set)、混合(M-set,1~4 个源)以及人工标注的真实录音(RW-set)五个子集。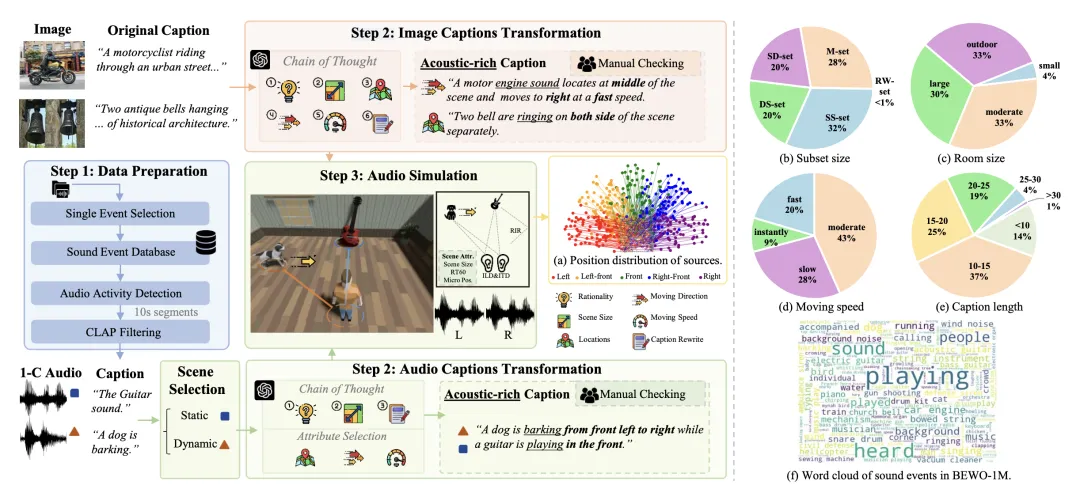 图 3 BEWO-1M 的三步数据构建流水线与数据分布统计
3. SpatialSonic 模型
模型建立在 Stable Audio Open 之上,微调其变分自编码器(VAE)并重新训练扩散 Transformer(DiT)。作者的关键发现是:仅用 BEWO-1M 微调现有模型仍做不到精确控制,因为缺少显式的空间引导。为此他们引入方位状态矩阵(azimuth state matrix):文本走 T5 编码器,图像走带区域感知的编码器,方位信息则被编码成一个随时间变化的矩阵,再通过方位融合模块(AFM)以交叉注意力与文本/图像特征融合。训练时方位由仿真已知,推理时由 GPT 从用户输入中推断。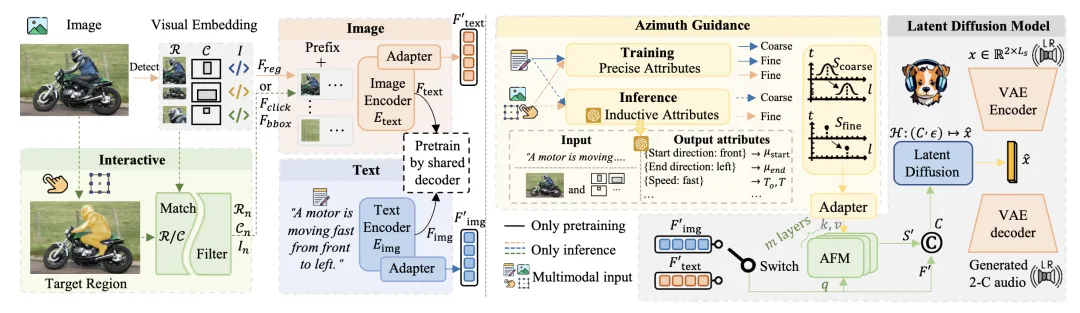 图 4 SpatialSonic 的整体流程:多模态提取、方位引导与隐空间生成
4. 粗引导与细引导
声源在时刻 t 的中心位置由起点到终点线性插值得到。基于该位置,作者设计了两种矩阵:粗引导用高斯分布描述方位,拟合人类对“左”“右”这类方向词本就模糊的感知;细引导则是离散精确的矩阵,某时刻声源就在某个确切角度。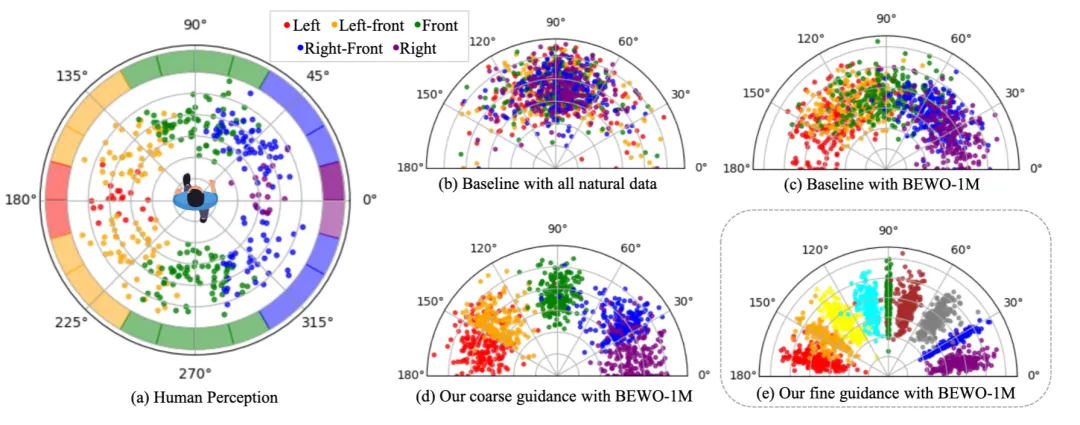 图 5 人类方位感知分布与不同引导策略下的生成方位分布
5. 实验与结果
为评测运动与多源场景,作者提出 FSAD(Fréchet Stereo Audio Distance):沿用 FAD 的思路,但把提特征的网络换成能感知空间的 StereoCRW,比较生成与真实音频在特征空间的分布距离,越低越好。模型在 8 张 RTX 4090 上训练 50 万步,主观评测邀请 15 位评测者按 1~5 分打分。
结果上,SpatialSonic 在五个子集的 FSAD 上全面领先:SS-set 从最强基线 Stable Audio Open 的 0.63 降至 0.17,M-set 从 0.53 降至 0.16;ITD 误差整体降低约 70%,主观的事件分与方向分也均为最高。同时它在单通道音质上并不输 AudioLDM 2、Tango 2 等主流模型,没有为空间感牺牲基础质量。图像生成与交互式生成(借鉴 SAM,用框选或点击指定物体)同样优于 See2Sound、Seeing-and-Hearing 等方法。消融实验显示,粗引导更适合文本输入,细引导更适合图像输入——文本方向本就模糊,用细引导过于死板;图像位置精确,细引导更合适。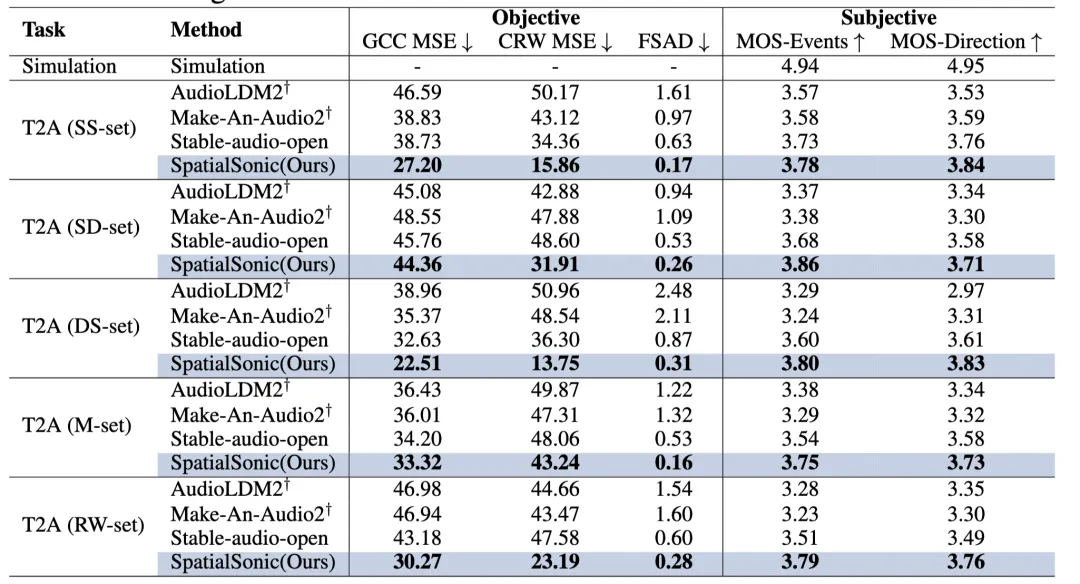 图 6 文本到空间音频在五个子集上的客观与主观对比(“†”表示对原结构做了单声道转立体声滤波的微调)
三、OmniAudio:从 360 度视频到 FOA
ICML 2025 的这项工作由香港科技大学、阿里通义实验室、浙江大学、Meta 等机构合作完成,作者团队与上一篇高度重合,任务则更进一步——直接从全景视频生成三维空间音频。
1. 问题与动机
传统“视频生成音频”有两个短板。视频端:透视视频视野有限,一列火车驶过画面后就看不见了;全景视频则能同时观察所有方向的发声物体。音频端:立体声在用户转头时声源相对位置不变,听感是错的;FOA 用 W、X、Y、Z 四个通道分别编码总声压、前后、左右、上下,转头后方向会正确跟随。据此作者提出新任务 360V2SA,并归纳出三大挑战:配对数据稀缺、整个球面的音画同步、高保真空间音频的生成难度。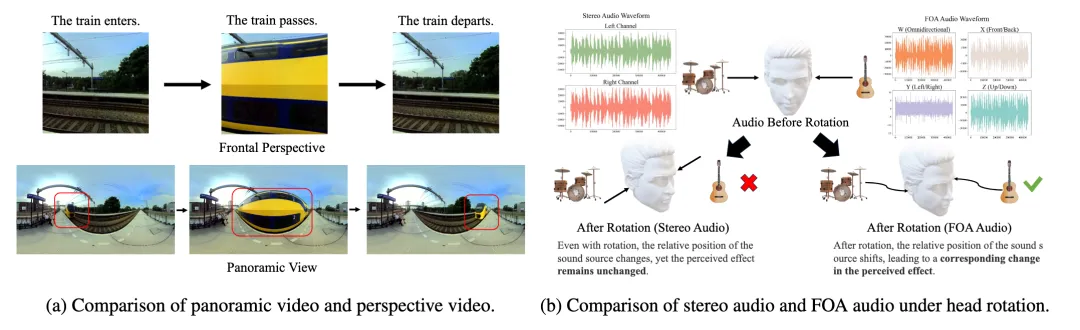 图 7 全景视频与透视视频的对比(左)、头部旋转下立体声与 FOA 的对比(右)
2. Sphere360 数据集
同时满足“全景视频”与“FOA 音频”的配对数据极度稀缺。作者在 YT-360 基础上设计半自动流水线:用“[事件标签] spatial audio 360”这类关键词在 YouTube 检索,通过 YouTube API 与 yt-dlp 确认视频既是 360 度、音频又是四声道;再分频道爬取与逐视频补充两阶段收集,全程人工复核。清洗阶段剔除四类坏数据——静止视频(帧间均方误差判定,静止帧超 85% 即删)、静音音频(滑动窗口测分贝)、人声过多(SenseVoice 检测,超过 5 个词即删)、音画不匹配(ImageBind 对齐度低于阈值即删),最后人工抽检兜底。
最终 Sphere360 包含 10.3 万个片段、288 小时、覆盖 288 类音频事件,是首个大规模、高质量、专为该任务定制的数据集。此前最大的同类数据集 YT-360 虽有 246 小时,但质量控制不足,论文提到用它训练生成模型常常只能输出噪声。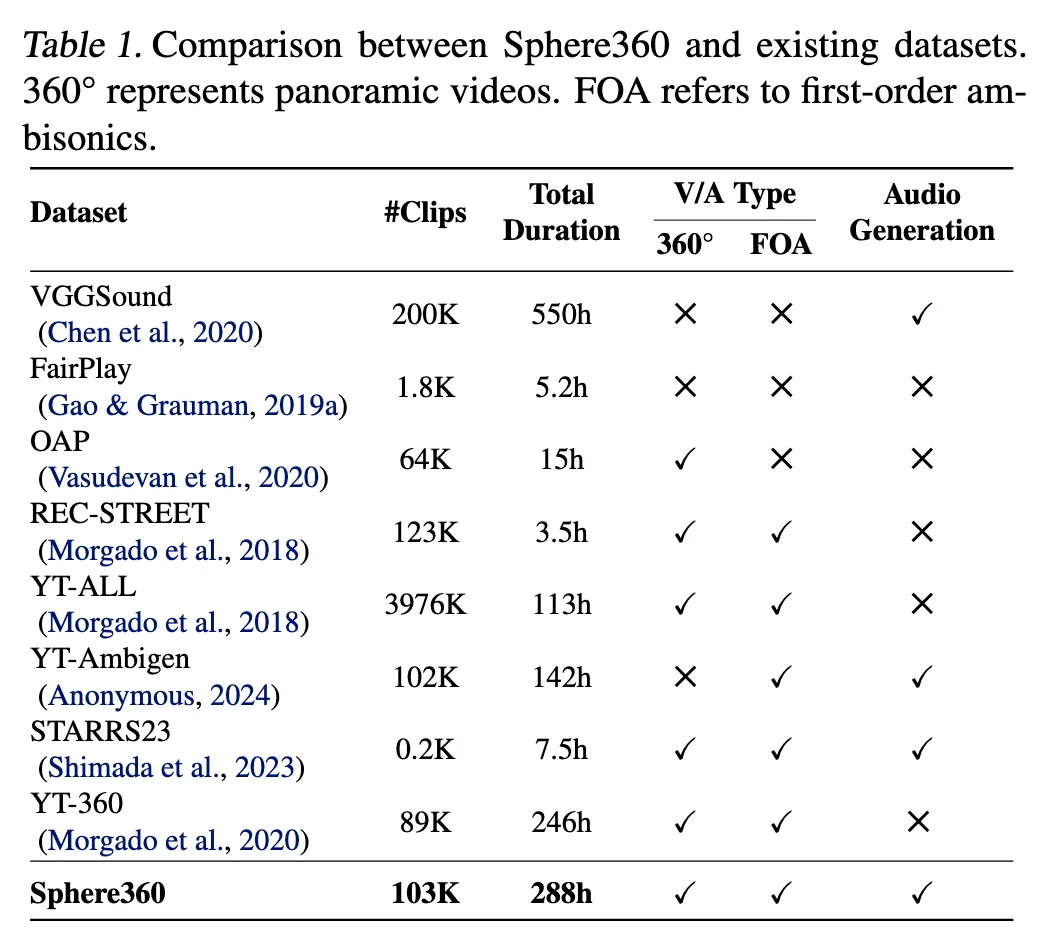 图 8 Sphere360 与已有数据集的对比
3. OmniAudio 模型
整体分两阶段。第一阶段是由粗到细的自监督预训练:配对数据稀少,但普通音频到处都是(作者用了约 200 万条 FreeSound/AudioSet/VGGSound 样本),先把它们转成 FOA 格式,用专门的空间 VAE 压成潜表示,再做掩码 token 预测;粗阶段用海量普通音频学通用规律,细阶段只用真实 FOA 音频对齐空间动态。第二阶段是视频引导微调,采用双分支视频编码:全景分支用等距柱状投影(ERP)提供全局场景上下文,透视分支裁出正前方 120 度视野捕捉局部细节,两路均由冻结的 MetaCLIP-Huge 提特征后在 DiT 中融合。生成骨干为流匹配 + DiT,共 1.22B 参数。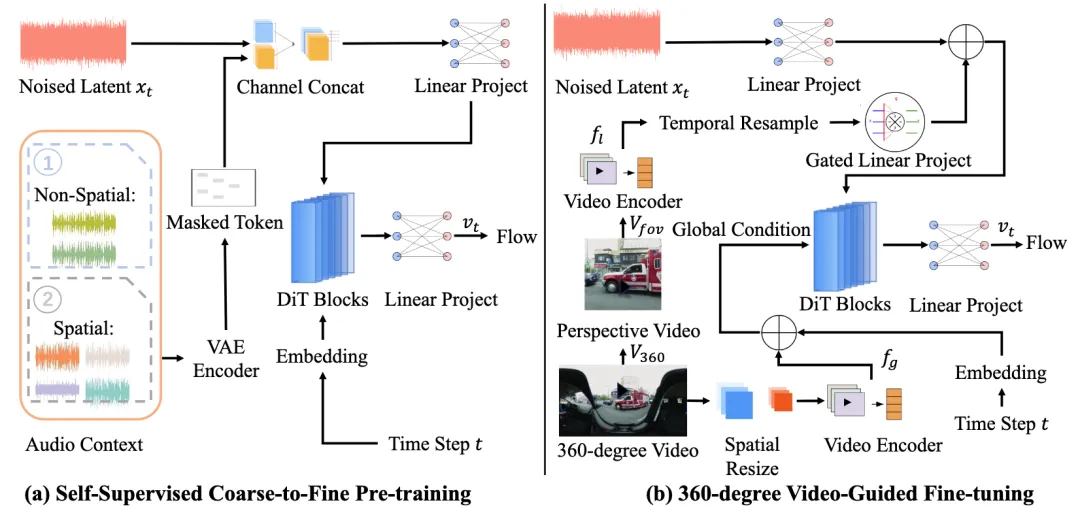 图 9 OmniAudio 的两阶段框架:自监督预训练与 360 度视频引导微调
4. 实验与结果
在 Sphere360-Bench 上,OmniAudio 的 FD 为 88.30,远优于 MMAudio + 空间化的 271.15;总角度误差 1.28,低于专门做空间音频的 ViSAGe(1.49);主观 MOS(20~100 分制,15 位线下评测者)在音质与音画对齐上分别为 84.67 与 87.23,接近真值。尤其值得注意的是推理时间:OmniAudio 只需 0.92 秒,而 ViSAGe 需要 22.37 秒,这正是流匹配骨干带来的效率优势。在分布外的 YT360 测试集上同样领先,泛化能力得到验证。
消融实验支持了两个核心设计:完整的“由粗到细”预训练 FD 为 88.30,去掉预训练后退化到 104.57;双分支(ERP + 透视)优于任何单分支,仅用 ERP 时 FD 为 97.83。定性对比中,火车驶出正面视野后 MMAudio 一类方法的声音几乎消失,而 OmniAudio 仍能正确生成来自背后的声音。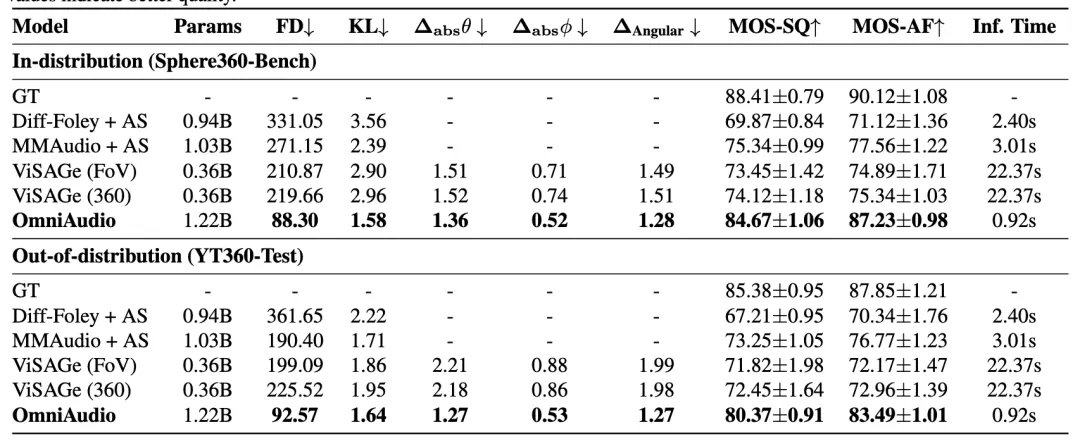 图 10 OmniAudio 与基线在分布内、分布外测试集上的对比
5.不足
当场景中发声物体非常多时模型会出错——如下图的失败案例,前方是乐团演奏、后方是观众,模型把声源误判成了背后的鼓掌声。此外,10 万量级样本对真实世界的 360V2SA 仍显不足。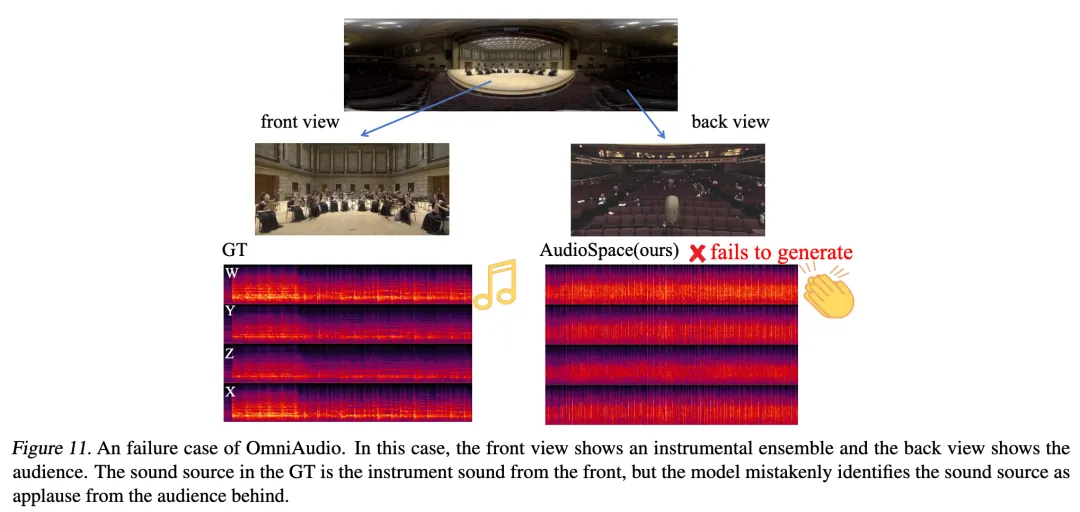 图 11 OmniAudio 的失败案例:多声源场景下的声源误判
四、ImmersiveFlow:从立体声到 7.1.4 全景声
这是 2026 年 1 月的新工作,来自香港中文大学、南京大学与字节跳动,主要面向音乐场景。7.1.4 指水平面 7 个音箱(左、右、中置、两个侧环绕、两个后环绕)、1 个超低音炮,加上头顶 4 个天空声道,共 12 个扬声器。
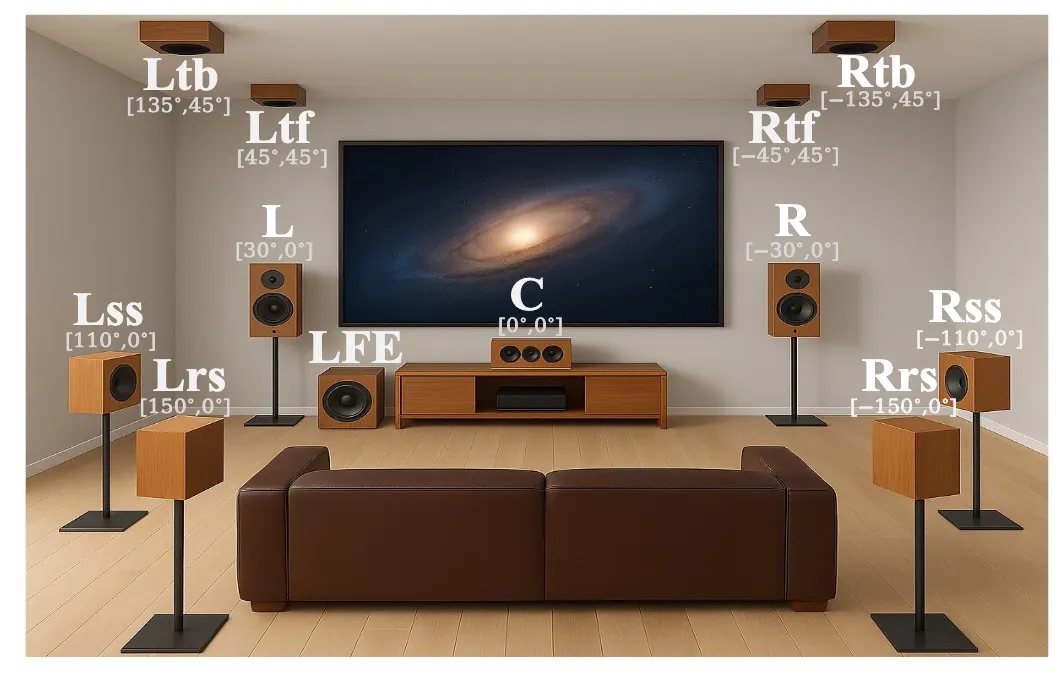 图 12 7.1.4 扬声器布局与各声道的方位角、仰角标注
1. 动机与方法
双耳音频只适用于耳机播放,FOA 则受限于空间混叠、高频分辨率不足;而现有的低声道升多声道方案大多是固定延时声像、矩阵升混等传统信号处理,计算快但缺乏真实感。作者因此提出直接用生成模型完成升混。核心思路是不在原始波形上建模——12 声道波形代价太高——而是借助预训练 VAE(取自 SongGeneration 检查点,25 帧/秒,潜维度 64)把每个声道独立压成紧凑潜表示。训练时立体声与 7.1.4 都被编码,立体声潜向量作为条件、通过 FiLM 调制注入,模型用条件流匹配(CFM)学习从噪声到目标潜向量的映射;推理时只输入立体声,用 Dormand-Prince 求解器积分后由 VAE 解码还原 12 声道波形。VAE 全程冻结,只训练 DiT(12 层、16 个注意力头、隐藏维度 1024)。
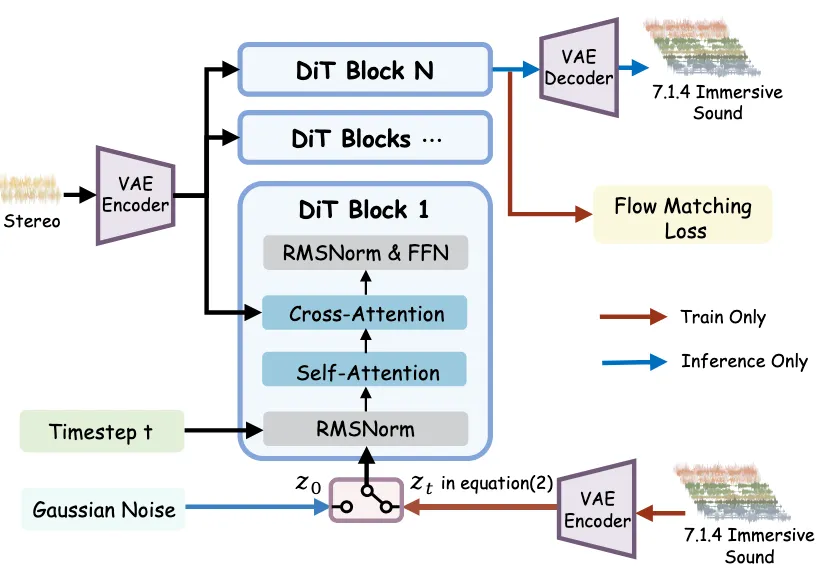 图 13 ImmersiveFlow 架构:红线为训练路径,蓝线为推理路径
2. 数据与实验设定
公开的 7.1.4 音乐数据集并不存在,作者自建了 100 首专业混音与母带处理的流行歌,每首约 3 分钟、48 kHz,涵盖人声、鼓、吉他与各类电子音效;按 AC-3 标准的固定矩阵降混得到“立体声输入—7.1.4 目标”配对,切成 10 秒片段,训练测试 9∶1。训练 20 万步、批大小 16、学习率 1e-4,单张 RTX 4090 约 17 小时即可完成,相当轻量。基线包括两款商业升混插件 Halo Upmix 与 WavDSP UpMix,以及把 VAE 换成梅尔频谱的消融版本 ImmersiveFlow-mel。
3. 结果
感知质量指标(ViSQOL、PAM)上,ImmersiveFlow 与商业插件基本持平,个别声道略低——作者诚实地归因于 VAE 压缩会丢失高频细节,且商业插件通常内置混响、空间展宽、EQ 等增强模块。生成质量指标才是关键:FAD 在 12 个声道中有 10 个取得最优,MAD 有 9 个最优,优势集中在环绕声道与天空声道(前置 L/R 两个声道仍由 mel 版本领先),说明模型确实学到了沉浸式音频的空间统计结构。主观实验邀请 14 位听众,将 7.1.4 用 KEMAR HRTF 双耳化后经耳机打分(0~100 分制):Halo 得 80.62、ImmersiveFlow 得 73.04,明显超过 mel 版本(50.56)与 WavDSP(29.02),配对 t 检验显示差异均显著。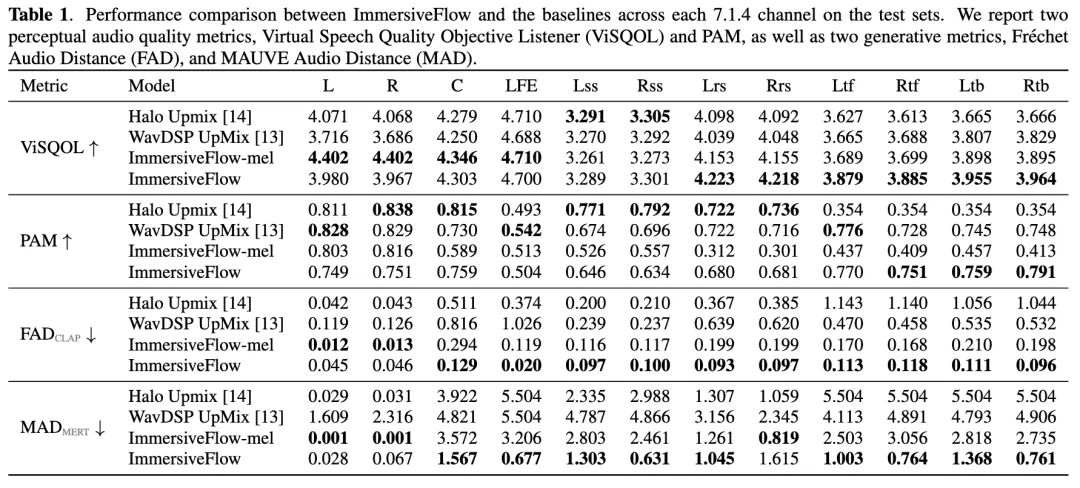 图 14 ImmersiveFlow 与基线在 7.1.4 各声道上的客观评测结果
4. 不足
论文列出四点不足::
音质尚未追上商业插件;
10 kHz 以上高频细节损失、天空声道能量偏弱;
中置声道不够稳定(训练数据中人声摆位不一致);
数据集仅 100 首歌,规模偏小。
公平地看,它是该任务的首个生成式方案,对手是打磨多年的商业产品,能在生成指标上反超、感知指标上持平,已经证明了这条路线的可行性。
五、横向对比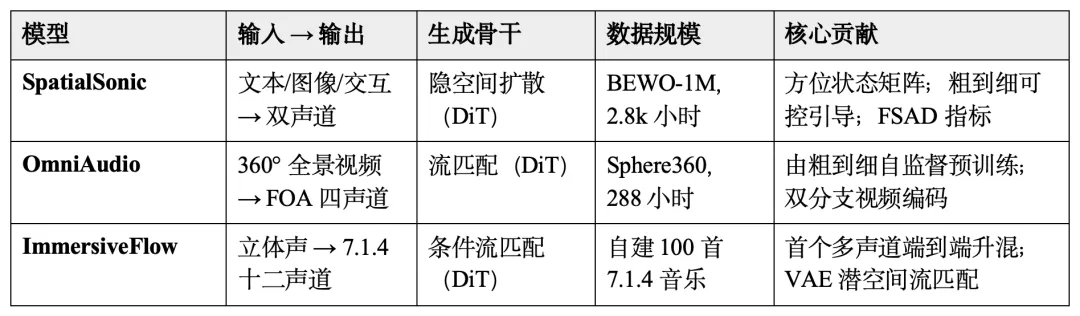 图15 模型横向对比图
六、总结:趋势与仍待解决的问题
对比这三篇工作,可以总结出以下几条趋势:
输出维度持续抬升。从两声道到 FOA 四声道,再到 7.1.4 十二声道,端到端模型正在向真正的影院级、可用于扬声器阵列的格式推进。
流匹配正在取代扩散成为默认骨干。OmniAudio 与 ImmersiveFlow 不约而同选择了流匹配,理由一致:训练更稳、推理更快——OmniAudio 相比 ViSAGe 快了二十多倍。
数据仍是最大瓶颈,且解法在分化。BEWO-1M 走仿真路线,规模大但与真实声场有差距;Sphere360 走真实数据清洗路线,质量高但只有十万量级;ImmersiveFlow 则干脆自建了 100 首专业混音。
另一方面,端到端路线的代价也值得正视。原本“单通道音频 + 卷积 RIR”的方案从信号理论出发,未必能反映真实复杂声场;但实录 RIR 困难,且与声学环境、录制设备强绑定,缺少丰富的公开数据。端到端跳过了 RIR 准备阶段,把音频生成与空间感生成强绑定,体感更真——代价是对声源位置的控制不如两阶段灵活,难以支撑游戏这类需要实时调整方位的场景。此外,实录的空间音频往往缺少声源位置标注,这也限制了模型的可控性训练。
具体到尚未解决的问题:仿真数据与真实声场的差距、开放世界与多声源场景的理解能力、仰角与前后混淆的建模、以及高频细节的保真度,都是下一步的核心课题。如何在端到端的沉浸感与两阶段的可控性之间找到平衡,或许是这一方向最值得期待的突破口。
七、参考文献
[1] SUN P, CHENG S, LI X, et al. Both Ears Wide Open: Towards Language-Driven Spatial Audio Generation[C]//ICLR 2025. http://arxiv.org/abs/2410.10676.
[2] LIU H, LUO T, LUO K, et al. OmniAudio: Generating Spatial Audio from 360-Degree Video[C]//ICML 2025. http://arxiv.org/abs/2504.14906.
[3] LIANG Z, WANG R, YE X, et al. ImmersiveFlow: Stereo-to-7.1.4 Spatial Audio Generation with Flow Matching[A]. arXiv, 2026. http://arxiv.org/abs/2601.12950.
[4] KIM J, YUN H, KIM G. ViSAGe: Video-to-Spatial Audio Generation[C]//ICLR 2025. http://arxiv.org/abs/2506.12199.
[5] KUSHWAHA S S, MA J, THOMAS M R P, et al. Diff-SAGe: End-to-End Spatial Audio Generation Using Diffusion Models[A]. ICASSP 2025. http://arxiv.org/abs/2410.11299.
[6] HEYDARI M, SOUDEN M, CONEJO B, et al. ImmerseDiffusion: A Generative Spatial Audio Latent Diffusion Model[A]. ICASSP 2025. http://arxiv.org/abs/2410.14945.
[7] DAGLI R, PRAKASH S, WU R, et al. SEE-2-SOUND: Zero-Shot Spatial Environment-to-Spatial Sound[A]. ACM SIGGRAPH 2025. http://arxiv.org/abs/2406.06612.
[8] EVANS Z, PARKER J D, CARR C J, et al. Stable Audio Open[A]. ICASSP 2025. http://arxiv.org/abs/2407.14358.
[9] ZHU Z, ZHANG Y, GUO W, et al. ASAudio: A Survey of Advanced Spatial Audio Research[C]//IJCNLP-AACL 2025. http://arxiv.org/abs/2508.10924.
[10] MORGADO P, LI Y, VASCONCELOS N. Learning Representations from Audio-Visual Spatial Alignment[C]//NeurIPS 2020. http://arxiv.org/abs/2011.01819.
供稿:刘正龙,编辑:刘怡涵,审核:张王优
