
 语音小管家
AudioCC交我学
今天我们来聊一聊,自动语音识别 (Automatic Speech Recognition, ASR) 中的强化学习是怎么做的?
近年来,大语言模型的快速发展,使得"预训练—监督微调—强化学习"逐渐成为构建智能系统的主流范式。从 ChatGPT、DeepSeek 到 Qwen 等模型,强化学习已经成为提升模型推理能力、指令遵循能力和人类偏好对齐能力的重要技术手段。
相比之下,端到端语音识别领域长期以来主要依赖监督学习进行模型训练。尤其是基于解码器架构的主流模型通常采用交叉熵损失,在教师强制策略下学习逐词预测正确文本。然而,在模型真正部署时,却需要依赖自身历史预测进行自回归解码,两者之间存在明显的训练—推理失配,容易导致误差不断累积。此外,模型训练优化的是交叉熵损失,而实际评测则采用词错误率(Word Error Rate, WER)、字符错误率(Character Error Rate, CER)等离散指标,训练目标与最终评价指标之间也存在天然的不一致。这些问题限制了传统监督学习方法中ASR性能的提升。
强化学习为解决上述问题提供了一种新的思路。与监督学习不同,强化学习能够直接以WER、CER等任务指标作为奖励信号,引导模型不断优化策略,使模型真正朝着最终应用目标进行学习。近年来,随着 SpeechLLM 的快速发展,强化学习在传统序列级优化方法的基础上得到进一步拓展,其优化目标也从单纯的词错误率逐渐扩展到语义一致性、人类偏好以及热词识别等更加复杂的任务,推动语音识别进入以大模型后训练为核心的新阶段。
本文首先介绍语音识别中经典的强化学习应用,再围绕四篇具有代表性的最新工作——ASR-TRA、CSR、GRPO-ASR 和 RLBR,介绍强化学习在自动语音识别中的最新进展,分析不同方法的核心思想、技术特点及优势,并对这一方向未来的发展趋势进行展望。
一、背景: 强化学习思想在早期 ASR 研究中的发展
1. 序列鉴别式训练: 强化学习思想的早期体现
传统自动语音识别模型通常无法直接优化词错误率、字符错误率等不可微分的序列级指标,因此训练目标与最终评价指标之间存在一定差距。
为了缩小这一差距,上世纪80年代~本世纪初,ASR 研究者提出了序列鉴别式训练 (Sequence-Discriminative Training) 方法,例如 MMI (Maximum Mutual Information)、 MPE (Minimum Phone Error)以及 sMBR (state-level Minimum Bayes Risk) 等。这类方法不再仅优化似然度、分类准确率等传统训练准则,而是直接在整个解码序列层面优化最终识别性能。
2. mWER: 现代ASR中的经典强化学习方法
随着Attention-based Encoder-Decoder、RNN-T等端到端语音识别模型的发展,Minimum Word Error Rate(mWER)训练逐渐成为最经典的序列级优化方法之一。
mWER首先利用Beam Search生成多个候选识别结果,再分别计算每个候选与参考文本之间的词错误率,最后以期望WER作为优化目标更新模型参数。由于模型输出需要经过采样或搜索后才能计算奖励,因此mWER本质上可以看作一种基于Policy Gradient思想的强化学习方法。
相比传统交叉熵训练,mWER能够直接优化最终评价指标,因此已广泛应用于Google、Microsoft等工业级语音识别系统,也是当前端到端ASR后训练的重要组成部分。
3. 从mWER到SpeechLLM强化学习
近年来,随着SpeechLLM的发展,强化学习开始突破传统mWER框架,其奖励信号也从单一的WER逐渐扩展到语义一致性、人类偏好、上下文信息以及热词识别等更加复杂的目标。同时,GRPO (Group Relative Policy Optimization)、DPO (Direct Preference Optimization) 等大语言模型中的后训练算法也开始被引入语音识别领域,使强化学习能够进一步提升模型的泛化能力和任务适应能力。
本文介绍的ASR-TRA、CSR、GRPO-ASR和BLBR四项工作,正是在这一背景下展开的最新探索,它们分别从测试时自适应、LLM奖励建模、强化学习训练策略以及热词增强等不同角度,展示了强化学习在现代语音识别中的发展趋势。
二、ASR-TRA: 强化学习驱动的测试时自适应
ASR-TRA(Test-timeReinforcementAdaptation)的核心思想是将自动语音识别中的测试时自适应(Test-Time Adaptation,TTA)问题建模为强化学习任务。在实际部署过程中,ASR模型经常面临训练集与测试集分布不一致的问题,例如环境噪声、口音变化、录音设备差异以及领域迁移等都会导致模型识别性能明显下降。传统测试时自适应方法通常依赖伪标签进行自训练,但当模型初始预测错误时,错误标签会不断累积,进一步降低模型性能。ASR-TRA则希望借助强化学习,在无需真实标注的情况下完成测试阶段的在线自适应。
1. 方法概述: 可学习Prompt + 外部奖励模型
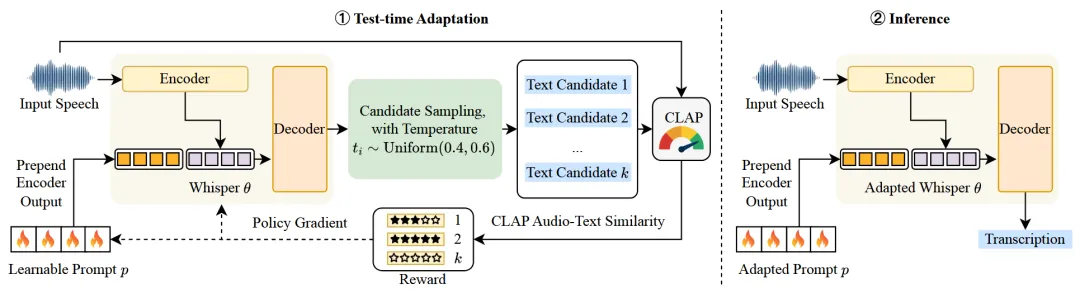
图1 ASR-TRA模型结构图
ASR-TRA建立在Whisper Encoder-Decoder架构之上,其最大的创新是在Decoder前引入了一组可学习的Prompt向量 (Learnable Decoder Prompt)。与传统微调整个模型参数不同,该方法仅优化这一小部分Prompt参数,因此测试时计算开销较低,也避免了频繁更新大规模模型参数带来的额外成本。
为了避免伪标签带来的确认偏差(Confirmation Bias),ASR-TRA没有直接利用模型自身预测结果作为监督,而是引入外部语义奖励模型对生成结果进行评价。具体而言,模型首先采用Greedy Decoding生成一个基准结果,随后通过不同温度采样生成多个候选识别结果,再利用CLAP计算候选文本与输入语音之间的语义一致性,并将该一致性作为强化学习奖励。整个优化过程采用经典的REINFORCE算法,根据奖励更新Prompt参数,从而实现针对当前测试样本的快速自适应。
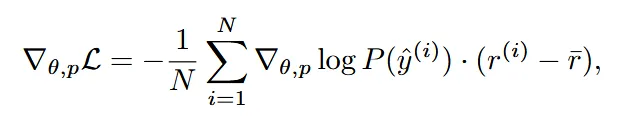
图2 经典REINFORCE算法
值得注意的是,为避免模型持续更新导致灾难性遗忘,论文在每条语音测试结束后都会恢复模型参数,仅保留当前样本的适应过程,因此整个测试时自适应实际上是在单条语音级别完成的在线优化。
2. 实验结果
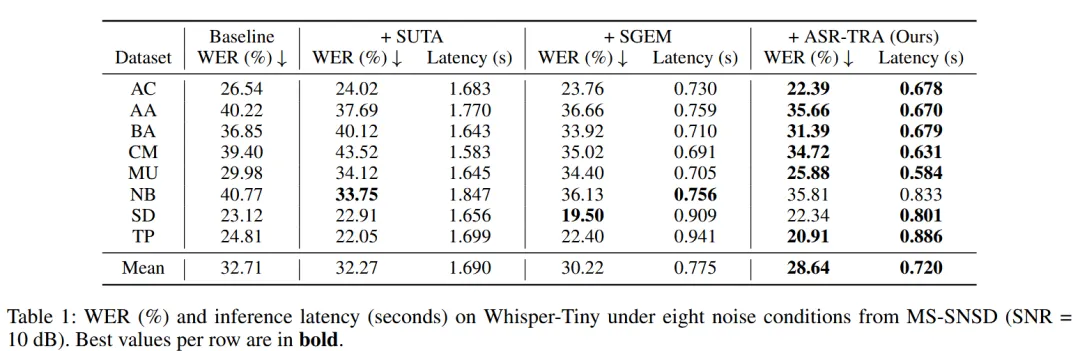
图3 ASR-TRA 实验结果
论文分别在噪声干扰、口音变化以及领域迁移等多种 Out-of-Distribution 场景下进行了实验,并与Self-training Unsupervised Test-time Adaptation(SUTA)、Softmax Greedy Entropy Minimization(SGEM)等主流测试时自适应方法进行了比较。
实验结果表明,ASR-TRA在多个测试集上均取得了更好的识别性能,同时由于每条语音仅需生成少量候选结果,因此整体推理速度也优于需要多轮迭代更新的SUTA方法。此外,作者还尝试使用大语言模型作为奖励模型进行实验,虽然能够进一步提升识别效果,但推理延迟显著增加,因此综合考虑效率与性能后,最终选择CLAP作为默认奖励模型。
3. 方法特点
ASR-TRA首次将强化学习系统性地引入ASR测试时自适应任务,通过"可学习Prompt + 外部奖励模型"的设计,在无需真实标签的情况下实现了稳定、高效的在线模型更新,为强化学习在自动语音识别领域的应用提供了一种新的思路。
不过,该方法仍存在一定局限性。目前奖励模型主要依赖CLAP,其跨语言泛化能力有限;同时整个方法仅针对单条语音进行自适应,尚未充分利用连续语音流中的上下文信息,这也是未来测试时自适应研究值得进一步探索的方向。
三、CSR: 利用 LLM 实现 ASR 后训练强化学习
CSR (CustomizingSpeechRecognition Model with LargeLanguage Model Feedback) 聚焦于语音识别模型的后训练阶段,探索如何利用大语言模型强大的语义理解能力,为自动语音识别提供更加可靠的奖励信号。传统ASR模型通常采用两阶段训练策略:首先利用模型生成伪标签,再将伪标签作为监督信号继续训练。然而,当模型初始预测存在错误时,伪标签质量难以保证,容易导致模型不断学习错误信息。CSR则希望利用LLM对识别结果进行评价,通过强化学习直接优化模型输出,而不是依赖固定的伪标签。
1. 方法概述:LLM作为奖励模型
CSR首先针对每条输入语音生成多个候选识别结果,以保证候选文本具有一定的多样性。随后,结合输入语音对应的上下文信息,将所有候选结果输入大语言模型,由LLM根据语义正确性、上下文一致性以及任务要求对每个候选结果进行评分,并将评分转换为强化学习中的奖励值。
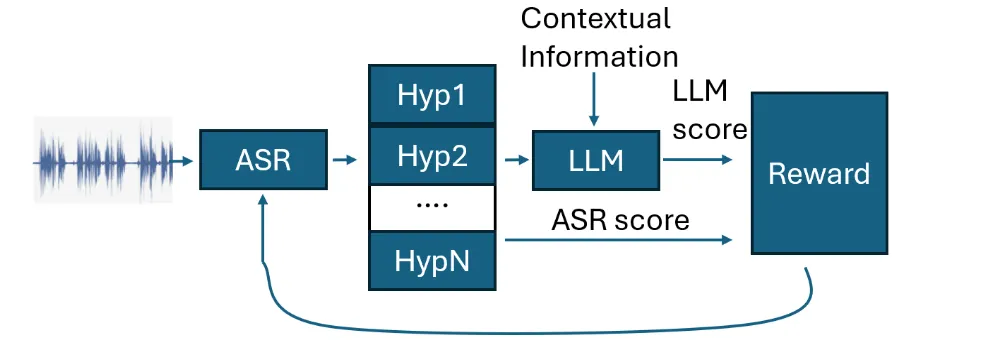
图4 CSR模型结构图
基于LLM提供的奖励,论文分别探索了三种不同的后训练策略:
RAFT (Rejection Sampling Fine-Tuning)
保留奖励最高的候选结果,将其作为新的监督标签继续进行监督微调。
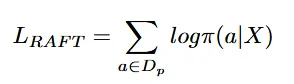
图5 RAFT算法
DPO (Direct Preference Optimization)
将高分结果作为优胜样本,低分结果作为失败样本,直接优化模型更倾向于生成高质量文本。与传统DPO不同,CSR采用在线采样方式,每轮训练都会重新生成候选结果,提高了训练的动态性。
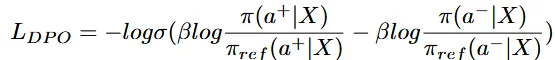
图6 DPO算法
GRPO (Group Relative Policy Optimization)
进一步利用组内奖励信息完成策略优化,通过优势函数更新模型参数,实现更加稳定的强化学习训练。
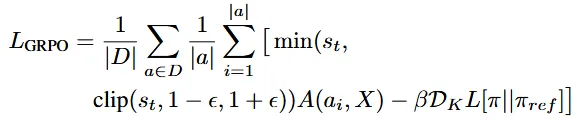
图7 GRPO算法
相比传统依赖固定标签的训练方式,CSR充分利用了LLM的语义理解能力,使模型能够学习到更加符合真实语言表达的识别结果,尤其适用于实体名称、长尾词汇以及上下文相关识别任务。
2. 实验结果
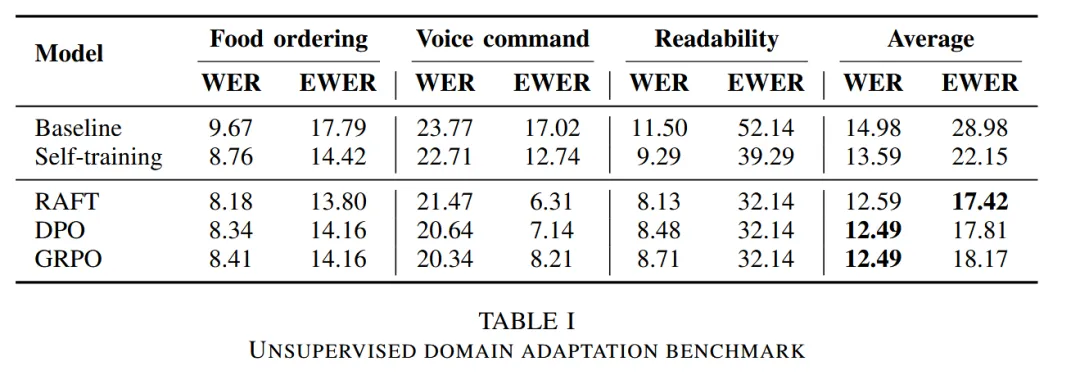
图8 CSR实验结果
论文分别比较了RAFT、DPO和GRPO三种训练策略,并在多个上下文语音识别数据集上进行了实验。实验结果表明,三种方法均能够提升模型识别性能,但整体性能差异并不显著。其中,RAFT凭借实现简单、训练稳定等优势,已经能够获得接近强化学习方法的效果;而DPO和GRPO虽然进一步引入偏好优化和策略优化机制,但带来的性能提升相对有限。
此外,作者还分析了不同上下文利用方式的影响。实验发现,仅利用上下文进行重打分(Rescoring)即可获得一定性能提升,而进一步借助LLM对识别结果进行重写能够更好地恢复实体名称和语义信息,在复杂上下文场景下具有更大的优势。
3. 方法特点
CSR将近年来广泛应用于大语言模型训练的偏好学习思想引入自动语音识别领域,通过利用LLM自动评价候选识别结果,实现了无需人工标注即可完成模型后训练。这一框架不仅验证了强化学习在Speech-LLM后训练中的可行性,也为后续奖励模型设计和偏好优化提供了新的研究思路。
不过,论文实验也表明,对于自动语音识别这一相对确定性的生成任务,不同强化学习算法之间的性能差距并不明显,说明奖励设计可能比具体优化算法更加重要。同时,由于LLM推理成本较高,如何降低奖励计算开销、提升训练效率,也是未来值得进一步研究的问题。
四、GRPO-ASR: 面向SpeechLLM的GRPO强化学习训练
GRPO-ASR (GroupRelativePolicyOptimization for Speech Recognition) 聚焦于强化学习在语音识别中的实际应用,系统研究了近年来广泛应用于大语言模型后训练的 GRPO 算法在 SpeechLLM 中的表现。随着Qwen-Audio、SALMONN等语音大模型的发展,越来越多ASR系统开始采用"监督微调(SFT)+强化学习(RL)"的训练范式。然而,目前针对ASR任务如何设计奖励函数、如何选择强化学习算法以及如何优化训练流程仍缺乏系统研究。GRPO-ASR正是围绕这些问题展开探索,为SpeechLLM强化学习训练提供了一套较为完整的实践方案。
1. 方法概述: GRPO训练框架
GRPO-ASR以监督微调后的SpeechLLM作为初始策略模型。对于每条输入语音,模型首先采样生成多个候选识别结果,并根据奖励函数计算每个候选结果的质量,再利用组内奖励计算优势值,最终采用GRPO算法更新模型参数。
相比传统PPO(Proximal Policy Optimization),GRPO最大的特点是不再训练额外的价值网络,而是直接利用同一组候选结果之间的相对奖励估计优势函数,从而显著降低了训练复杂度,提高了训练稳定性。这种设计也使GRPO更加适合参数规模较大的SpeechLLM训练。
为了进一步提升训练效果,论文还比较了多种GRPO改进版本。其中,DAPO (Decoupled Clip and Dynamic Sampling Policy Optimization) 采用Token级优化目标,并移除了KL散度约束,使模型具有更强的探索能力;Dr.GRPO则重新设计了优势函数计算方式,取消传统GRPO中的优势标准化,同时调整长度归一化策略,以缓解模型生成过长文本的问题。通过这些改进,作者系统分析了不同GRPO变体在ASR任务中的训练特点。
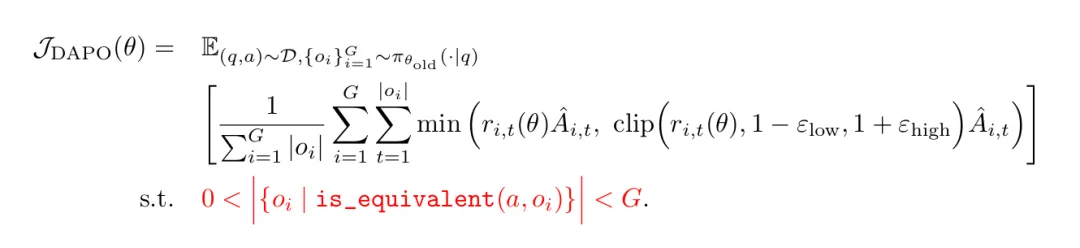
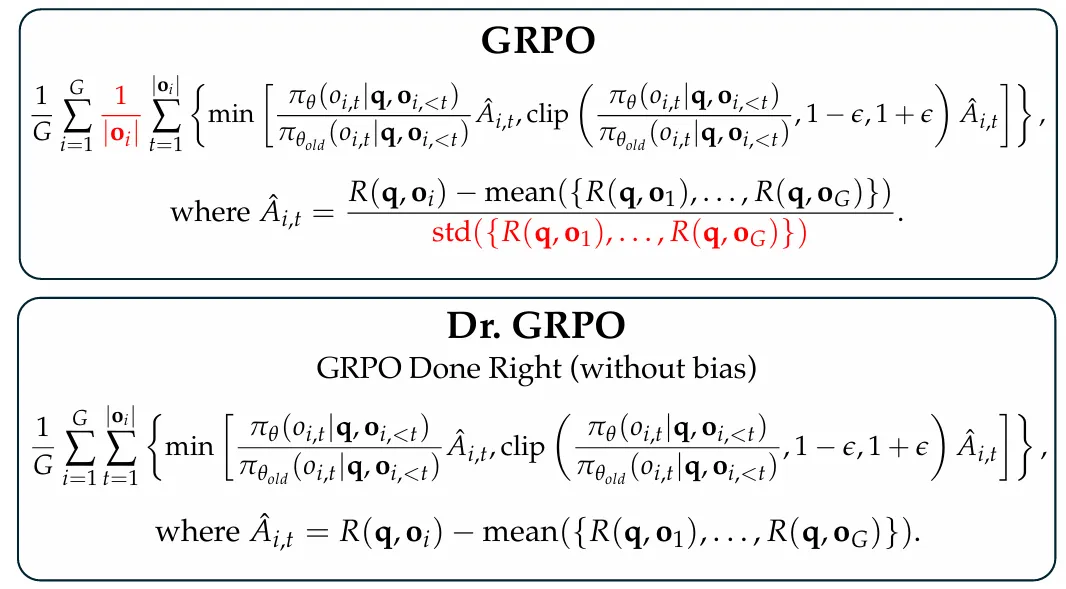
图9 DAPO, Dr. GRPO, GRPO三种算法对比
2. 实验结果
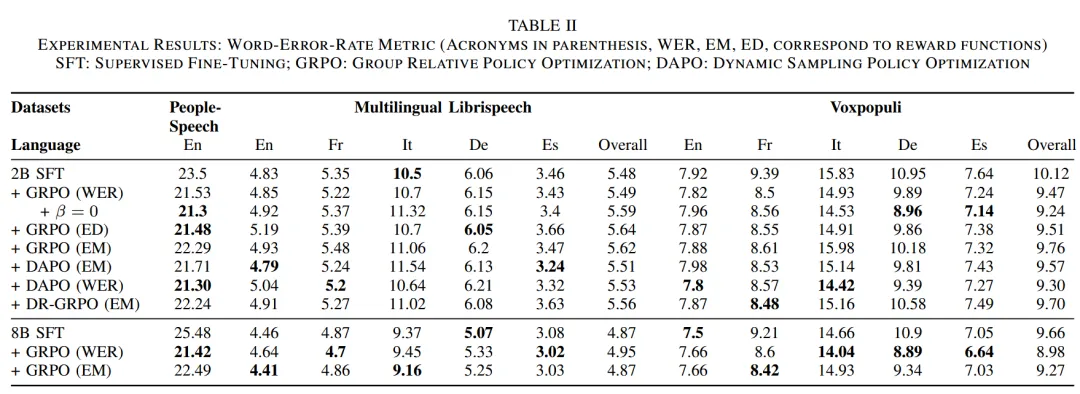
图10 GRPO 实验结果
论文首先比较了不同奖励函数的影响,包括直接采用词错误率作为奖励,以及结合语义信息构建复合奖励等多种方案。实验结果表明,对于自动语音识别任务而言,直接使用WER奖励即可取得稳定且优异的训练效果,而复杂语义奖励带来的提升相对有限。此外,作者发现,在GRPO训练过程中,传统强化学习中常用的KL约束并不是影响性能的关键因素,适当减弱甚至移除KL约束反而能够提高模型探索能力。
论文还进一步研究了不同解码策略对强化学习训练的影响。实验发现,高质量语音数据采用随机采样能够获得更丰富的候选结果,有利于强化学习训练;而对于低质量语音或噪声较大的场景,Beam Search生成结果更加稳定,能够减少错误样本带来的干扰。此外,实验还比较了不同采样数量、不同温度参数等设置,发现候选数量增加到一定程度后性能提升趋于饱和,为后续SpeechLLM强化学习训练提供了重要参考。
3. 方法特点
GRPO-ASR并没有提出新的语音识别模型,而是从强化学习训练策略的角度,对SpeechLLM后训练进行了较为全面的分析。论文不仅验证了GRPO在ASR任务中的有效性,还系统比较了不同奖励函数、算法变体以及采样策略,为后续强化学习在语音识别中的应用提供了丰富的实验经验。
总体来看,GRPO-ASR进一步证明了强化学习能够有效提升SpeechLLM的识别性能,同时也指出,对于ASR这一目标明确的生成任务而言,奖励函数设计和数据采样策略往往比具体优化算法更加重要。这些经验对于后续构建更加稳定、高效的ASR强化学习框架具有重要的参考价值。
五、RLBR: 强化学习驱动的热词增强语音识别
RLBR (ReinforcementLearning withBiasingRewards for Contextual Speech Large Language Models)聚焦于自动语音识别中的热词识别(Hotword Biasing)任务。近年来,随着SpeechLLM的发展,越来越多语音识别系统通过Prompt输入热词列表,引导模型优先识别用户关注的人名、地名、机构名等关键词。然而,在实际应用中,热词数量往往较多,且存在大量发音相近、语义相似的干扰词,仅依赖监督学习训练,模型仍容易出现热词遗漏、误识别或混淆等问题。RLBR希望利用强化学习进一步提升模型对目标热词的关注能力,使模型不仅能够正确识别普通文本,还能够更加准确地识别用户指定的热词。
1. 方法概述: 面向热词识别的奖励设计
RLBR整体采用"监督微调(SFT)+强化学习(RL)"两阶段训练框架。首先,利用包含热词信息的数据对SpeechLLM进行监督微调,使模型初步具备热词识别能力;随后,在强化学习阶段,模型针对每条输入语音采样生成多个候选识别结果,并根据设计的奖励函数计算每个候选结果的质量,再利用GRPO算法完成策略优化。
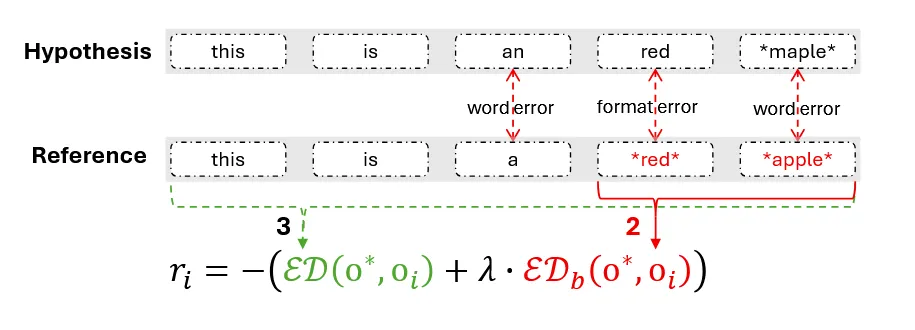
图11 Reward设计
与传统强化学习直接采用WER作为奖励不同,RLBR专门针对热词识别设计了Bias Reward。该奖励不仅考虑整体识别正确率,还重点关注目标热词是否被正确识别。当模型成功识别目标热词时,将获得更高奖励;若热词缺失、替换或识别错误,则给予相应惩罚,从而引导模型在优化整体识别性能的同时,更加关注热词内容。
为了进一步提高奖励的稳定性,论文提出了Reference-aware Reward机制。在计算奖励时,同时利用参考文本与热词列表共同评价模型输出,而不是仅依据最终识别结果进行打分。这种设计能够有效减少奖励波动,提高强化学习训练的稳定性,使模型能够更加准确地区分真正的热词错误与普通识别错误。
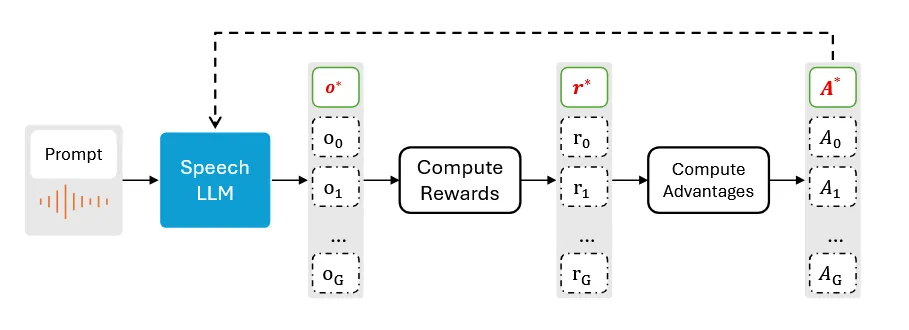
图12 RLBR模型结构
此外,为增强模型在复杂场景下的泛化能力,RLBR还构建了包含目标热词和大量干扰热词的数据,通过引入发音相近、拼写相似或语义相关的候选词,模拟真实应用中的热词检索场景,进一步提升模型对目标热词的辨别能力。
2. 实验结果
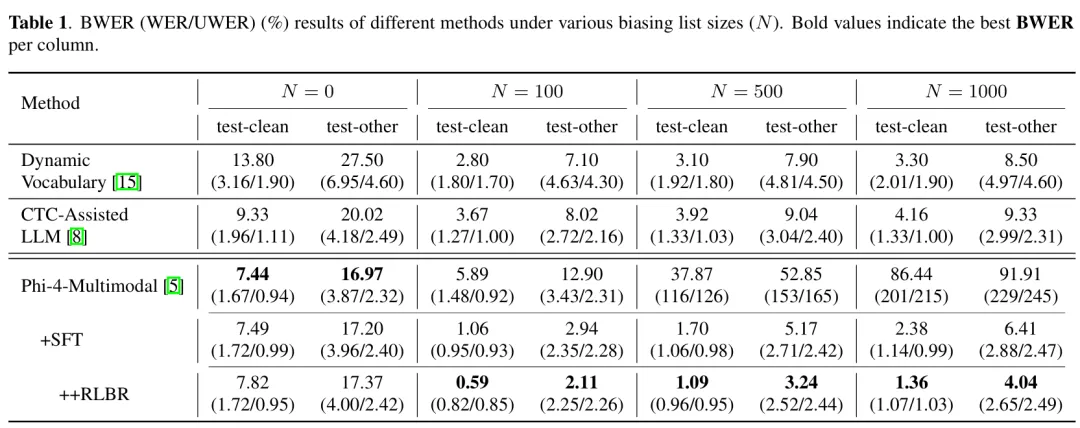
图13 RLBR实验结果
论文分别在多个热词语音识别数据集上验证了RLBR的有效性,并与传统监督学习方法进行了比较。实验结果表明,在引入强化学习后,模型不仅整体识别性能得到进一步提升,更重要的是热词召回率(Hotword Recall)和热词识别准确率均有明显改善。尤其是在热词数量较多、干扰词复杂的场景下,RLBR能够更加稳定地识别目标热词,减少遗漏和误识别现象。
消融实验进一步证明,Bias Reward是性能提升的关键因素,而Reference-aware Reward则显著提高了训练稳定性,两者结合能够取得最佳识别效果。此外,论文还分析了不同热词数量、不同奖励权重等因素对模型性能的影响,为后续热词增强模型设计提供了参考。
3. 方法特点
RLBR针对自动语音识别中的热词增强任务,提出了一套更加符合实际应用需求的强化学习训练框架。通过设计专门面向热词识别的奖励函数,模型能够直接优化用户真正关注的识别目标,而不仅仅关注整体WER指标。这一思想进一步拓展了强化学习在ASR中的应用场景,也说明针对具体任务设计奖励函数,比单纯更换强化学习算法更能带来性能提升。
不过,论文也指出,随着热词规模不断扩大,SpeechLLM 如何在上千甚至上万个候选热词中快速完成隐式检索仍然是一个具有挑战性的问题。未来,如何结合检索增强和强化学习进一步提升大规模热词识别能力,将成为该方向的重要研究课题。
六、结 语
从测试时自适应到SpeechLLM后训练,再到热词增强,强化学习正在逐渐成为自动语音识别的重要优化手段。ASR-TRA探索了强化学习在测试时自适应中的应用,CSR利用大语言模型构建奖励信号指导模型优化,GRPO-ASR系统分析了GRPO在SpeechLLM后训练中的实践经验,而RLBR则针对热词识别设计了更符合任务需求的奖励机制。四项工作从不同角度展示了强化学习在提升模型泛化能力、优化生成质量以及增强特定任务性能方面的潜力。
尽管目前强化学习在ASR领域仍面临奖励设计、训练效率和复杂场景泛化等挑战,但随着SpeechLLM和强化学习算法的不断发展,二者的结合有望进一步推动语音识别技术向更加智能、更加鲁棒的方向发展,为未来智能语音交互系统提供新的技术支撑。
七、参考文献
[1] Fang, L., Xie, T., & Liu, L. (2026). Boosting ASR Robustness via Test-Time Reinforcement Learning with Audio-Text Semantic Rewards. Proceedings of the AAAI Conference on Artificial Intelligence, 40(36),30673–30681. https://doi.org/10.1609/aaai.v40i36.40323
[2] Ling, S., & Ye, G. (2025). Customizing Speech Recognition Model with Large Language Model Feedback. arXiv [Cs.CL]. Retrieved from http://arxiv.org/abs/2506.11091
[3] Shivakumar, P. G., Gu, Y., Gandhe, A., & Bulyko, I. (2025). Group Relative Policy Optimization for Speech Recognition.2025 IEEE Automatic Speech Recognition and Understanding Workshop (ASRU), 1–7. doi:10.1109/ASRU65441.2025.11434657
[4] Ren, B., Fan, R., Shen, Y., Chen, W., & Li, J. (2026). RLBR: Reinforcement Learning with Biasing Rewards for Contextual Speech Large Language Models. ICASSP 2026 - 2026 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), 17637–17641. doi:10.1109/ICASSP55912.2026.11464286
[5] Yu, Q., Zhang, Z., Zhu, R., Yuan, Y., Zuo, X., Yue, Y., … Wang, M. (2025). DAPO: An Open-Source LLM Reinforcement Learning System at Scale. arXiv [Cs.LG]. Retrieved from http://arxiv.org/abs/2503.14476
[6] Liu, Z., Chen, C., Li, W., Qi, P., Pang, T., Du, C., … Lin, M. (2025). Understanding r1-zero-like training: A critical perspective. Conference on Language Modeling (COLM).
供稿:何宇轩,编辑:刘怡涵,审核:张王优
