
 语音小管家
下面是我们整理的Daniel Povey在第二届SH语音技术研讨会和第七届Kaldi技术交流会的报告内容,因为是翻译整理,如果有误,欢迎指正。
讲者:Daniel Povey
编辑:徐天翼、郭泓霄
新一代kaldi将焦点从CTC +注意力解码转移到Transducer(如 RNN-T)上因为这样对于基于服务器的解码更实用(每个流的占用内存更少),WER和训练速度的大量改进;
同时也为模型部署创建了一个C++框架“Sherpa”,它支持在CPU或GPU上并行解码多个流也支持批处理或流式传输模式;
总体目标是适合产品部署的快速、准确的ASR。
继续改进模型部署/Sherpa;
提高我们的情境化/个性化ASR和跨域ASR能力; 继续改进我们的模型; 我们的目标是易于用于产品的实用ASR,即: 最好的WER; 合理的训练时间; 良好的推理性能; 易于语境化/个性化(例如新词)。 我们已经拥有良好的WER和训练速度,但需要在情境化方面下功夫。
批处理模式解码中Encoder是经过修改的Conformer或Zipformer。稍后会描述;
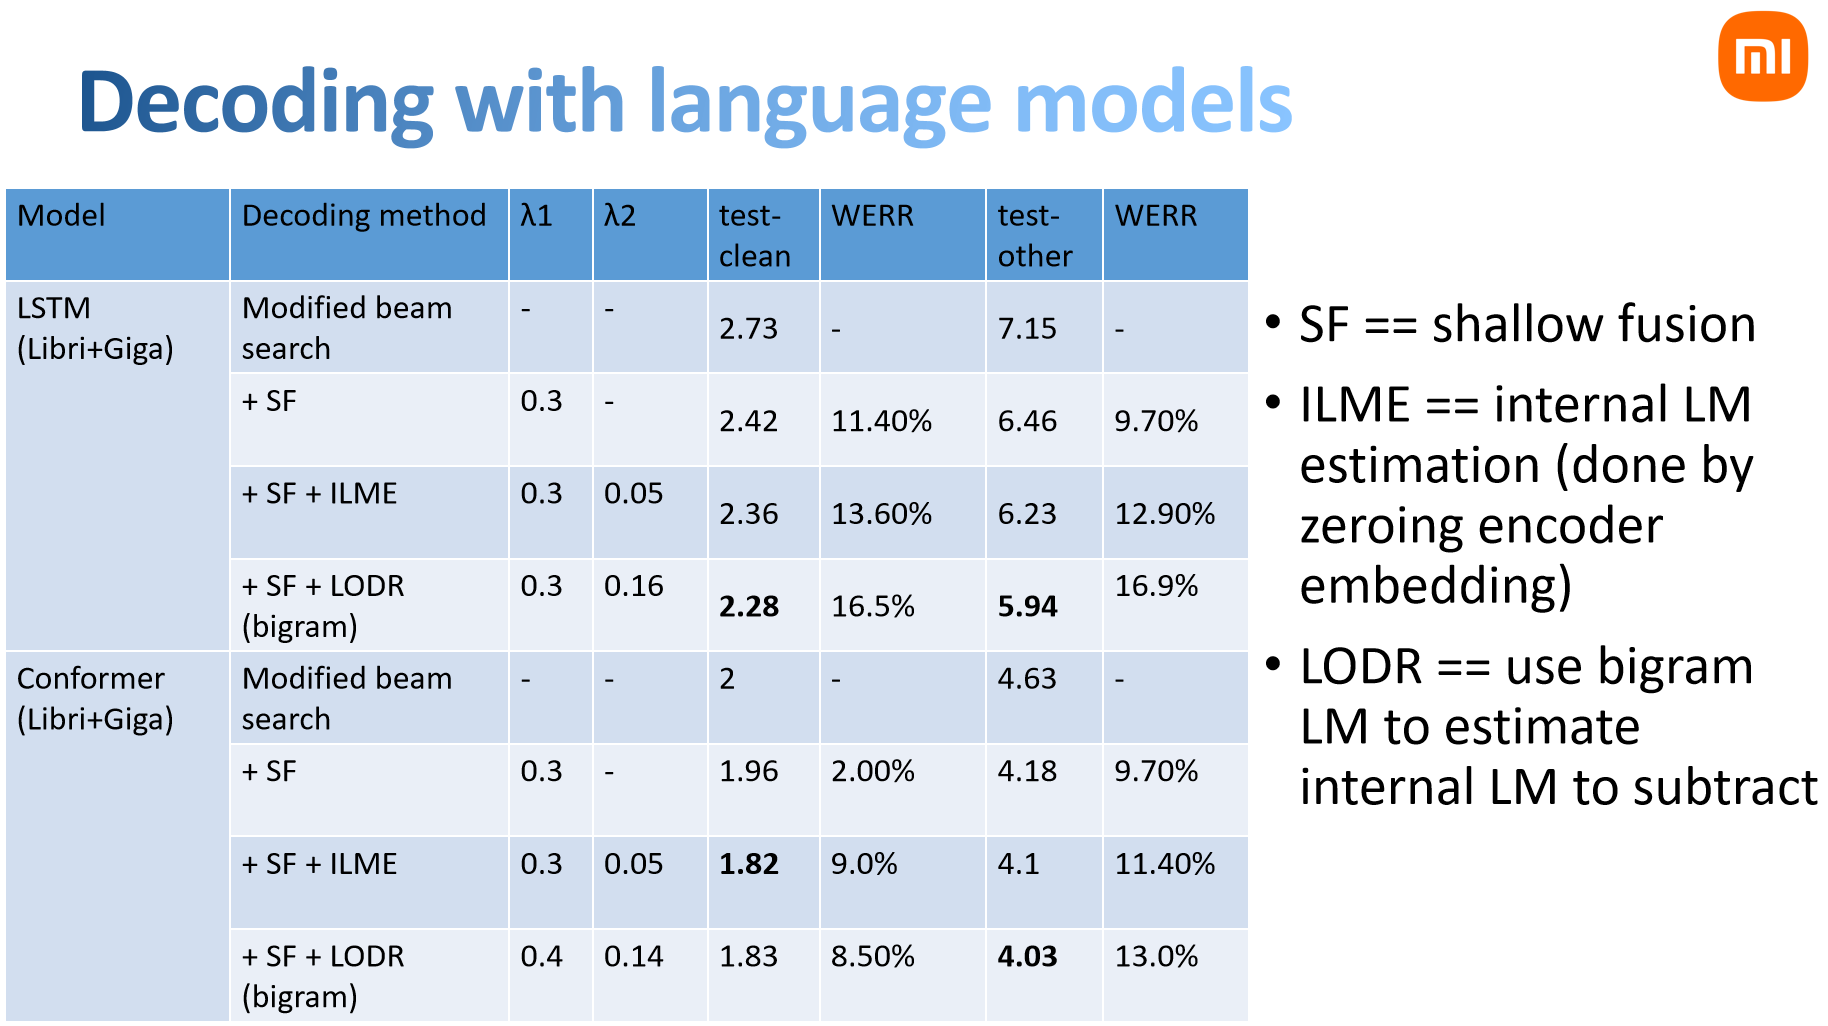
Decoder是一个Transducer(如 RNN-T); 它是非循环的,因为我们使用“stateless RNN-T”:解码器只能看到 2 个历史符号。 通常不使用LM进行解码,因为在不使用LM的情况下我们的模型效果已经足够好。 但由于实际应用经常涉及domain-mismatch,我们的新一代Kaldi工具支持使用各种类型的LM(例如 FSA 或神经网络 LM)进行解码和重新评分。
流式解码模式
“Streaming”Conformer使用类似WeNet带有块式注意掩码; 使用了Emformer。它的WER比Conformer稍差,而且训练速度较慢,但在推理时使用比Cnformer更少的内存; 长短期记忆网络。 LSTM在推理时使用的内存非常少; 它在有限的训练数据上泛化得更差,但在大约1万小时时它和我们的 Conformer一样好。
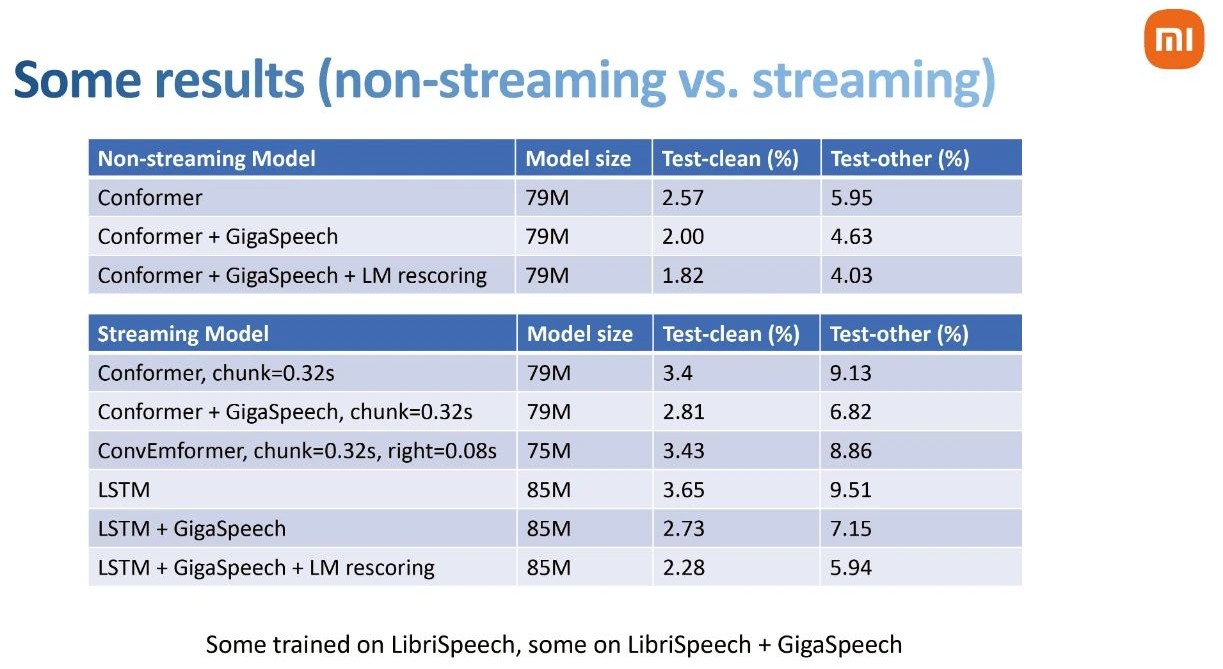
结合语言模型的解码
在匹配的测试数据上,不使用LM的Transducers模型的表现非常好(LM-Free); 模型“学习”了语言模型,但更多的是编码器学习的(解码器只能看到2个历史符号); 使用语言模型确实使模型性能得到提升。
Pruned Transducer Training
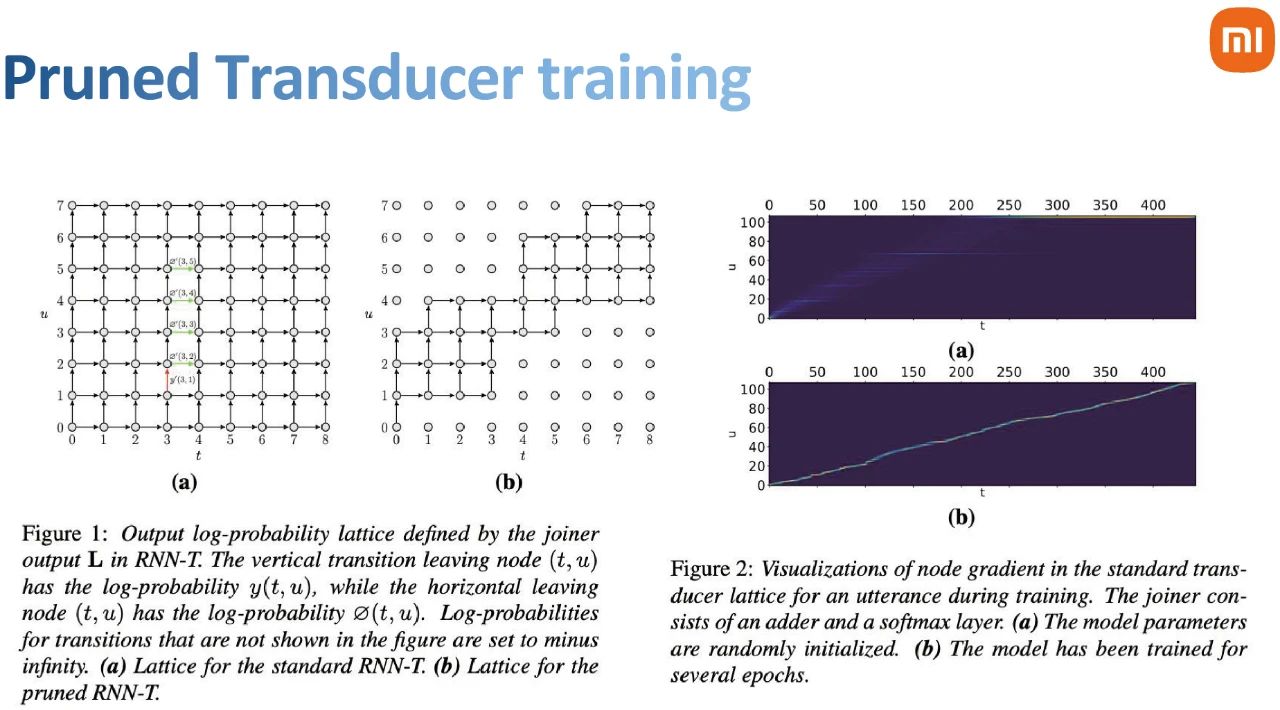
减少了Transducer loss计算时对内存和时间的需求; 在loss计算决定了训练过程时间和内存需求的场景下有重大意义; 比如:在文本长度(U)较大的情况下,普通RNN-T Loss计算会消耗许多内存。
Delay-penalized Transducer延迟惩罚
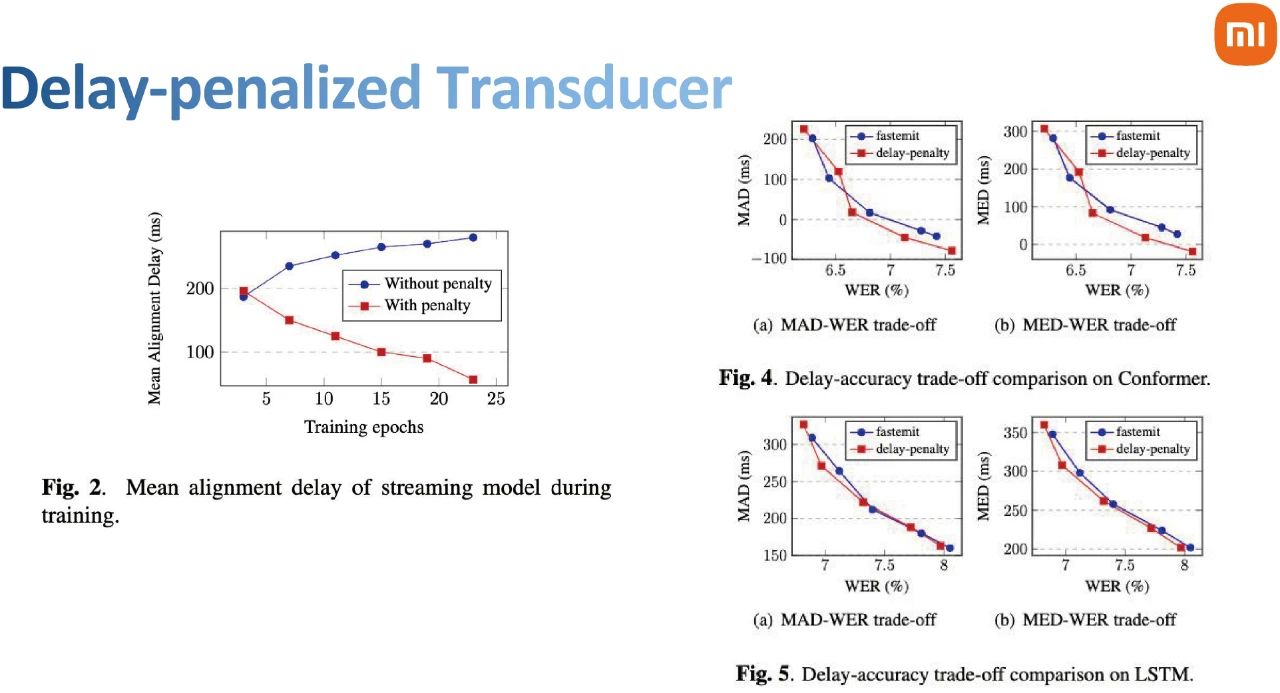
在 RNN-T 损失的输入中,对所有非blank的概率加一个常数乘上帧索引; Delay/WER trade-off 比谷歌的“ FastEmit ”方法略好; 而且提出的这个惩罚项的来由也比FastEmit更具理论优势(以Dan的原话less ad-hoc),因此这个方法应该有效。
通过预测多码本量化索引进行知识蒸馏
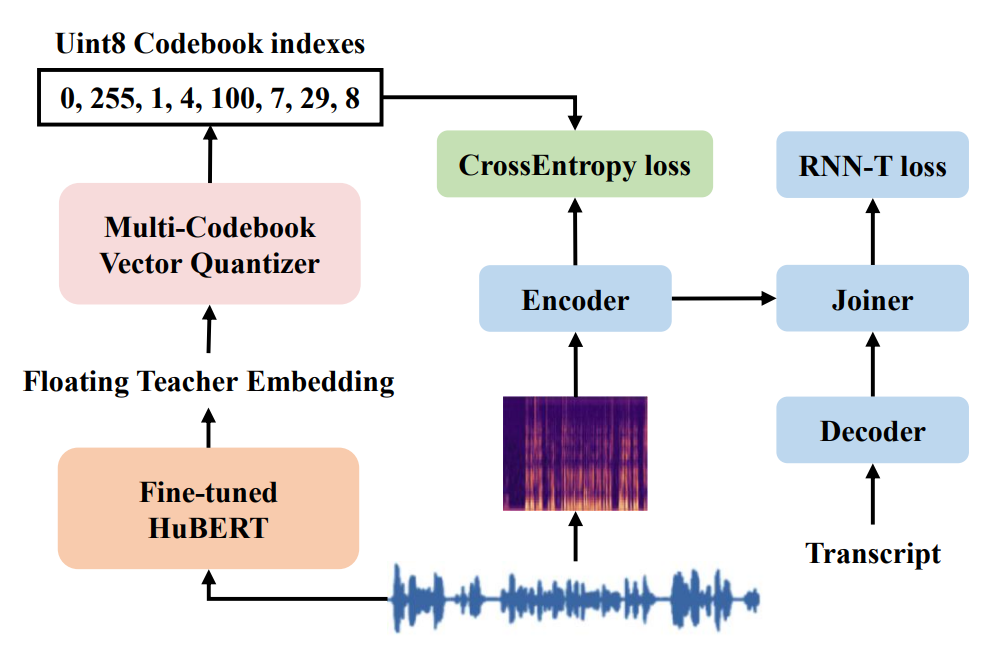
预测多码本量化索引进行知识蒸馏,是一种用于从HuBERT等大型模型中提取知识的方法。将大型模型的特征进行量化,使用(预测码本条目)作为辅助损失函数;
虽然与通过 l1 或 l2 预测Hubert embedding的性能相似,但这种方法效率更高:无需在每个批次上推断HuBERT模型,或从磁盘加载非常大的嵌入向量。在实现256倍存储空间压缩率(相较于l1和l2)的同时,性能没有明显损失。
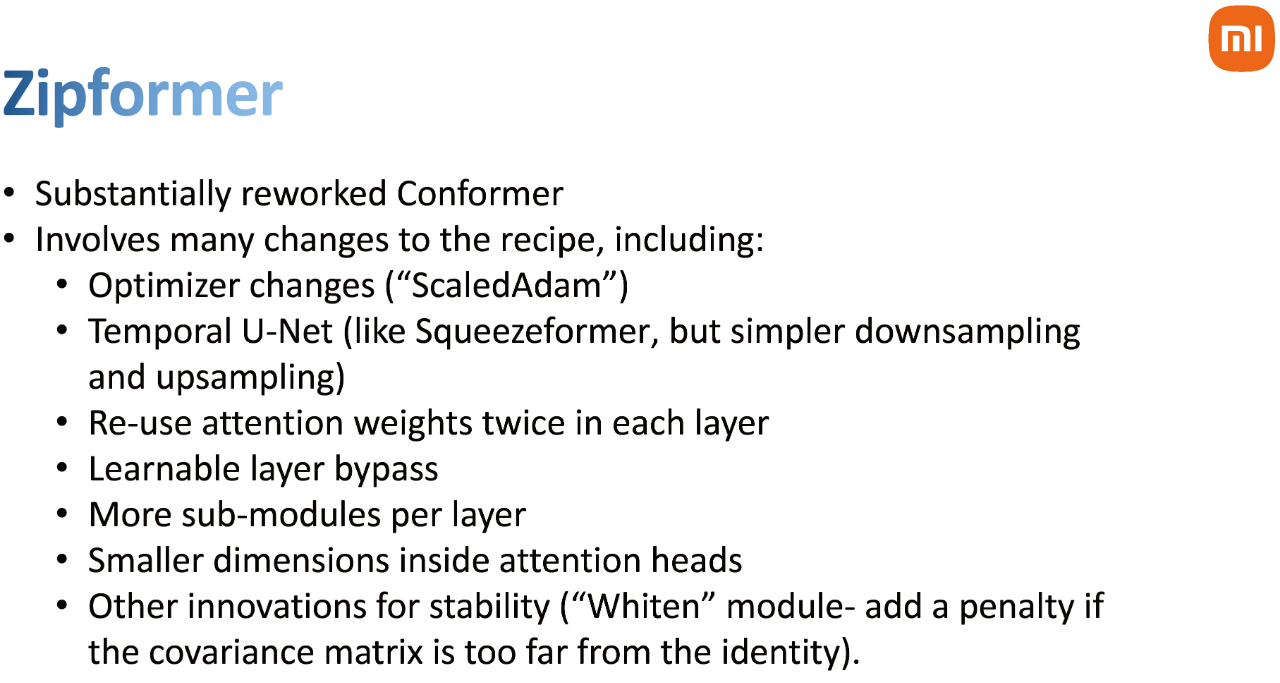
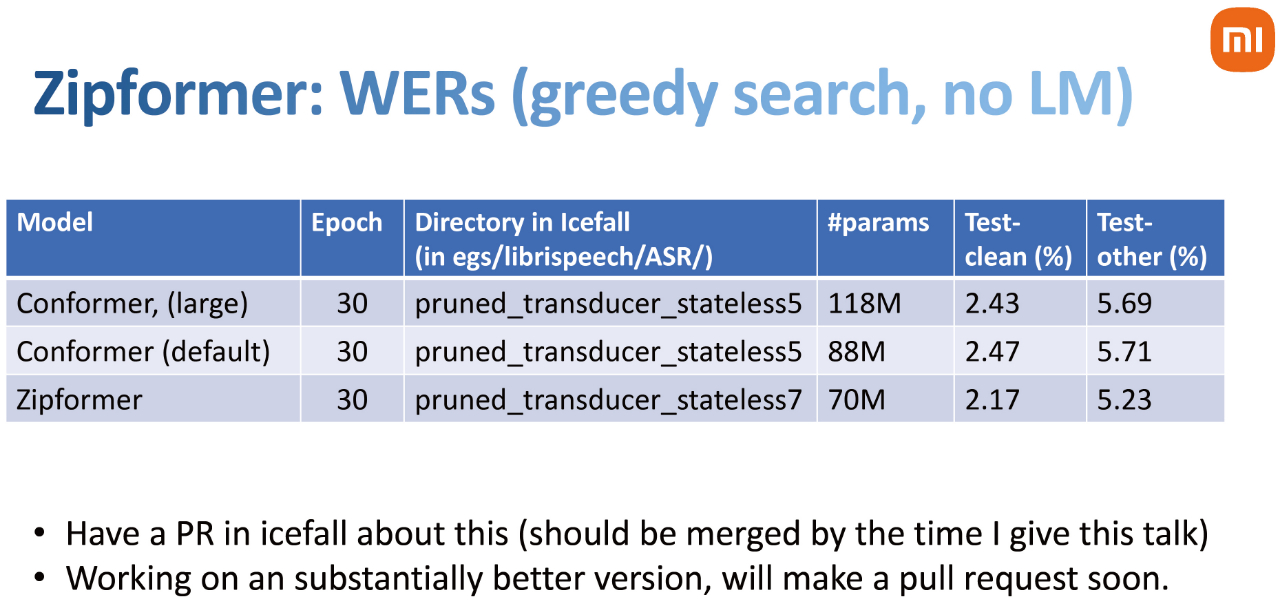
优化器更改(“ ScaledAdam ”); 时间U-Net(类似于Squeezeformer ,但更简单的下采样和上采样); 每一层包含两个注意力模块,第二个复用第一个的注意力权重; 可学习层旁路; 每层更多子模块; 注意头内部的尺寸更小; 稳定性的其他创新(“Whiten”模块 - 如果协方差矩阵与恒等式太远,则增加惩罚)。
Sherpa未来发展
支持批处理及流式ASR;
GPU或者CPU解码;
多重解码流可以并行处理;
Transducer或基于CTC的声学模型;
支持icefall中所有的解码方式:Greedy search、为Transducer提供Fast beam search、图解码(例如LG graph);
端点检测。
