语音识别与交互相关学习
唤醒 熟悉Kaldi ,并且搞清当中做语音唤醒的功能 一个不错的github 资https://github.com/zycv/awesome-keyword-spotting#opensource-code https://papersw…
171 0 0

唤醒 熟悉Kaldi ,并且搞清当中做语音唤醒的功能 一个不错的github 资https://github.com/zycv/awesome-keyword-spotting#opensource-code https://papersw…

续上一篇文章说话人识别中PLDA的背景与训练,在这里,我进一步把PLDA的打分过程进行推演。说实话,two-covariance PLDA打分的数学部分,比训练模型部分还要复杂和困难;这部分也鲜有博客或文章去分析,但能理解一次,对于提升ba…

我们常见的PLDA,是出自《Probabilistic Linear Discriminant Analysis for Inferences About Identity》,由Simon J.D. Prince和James H. Elde…

近日,由腾讯音乐娱乐集团(TME)主办的音乐娱乐技术盛会“TechME技术周”在深圳成功举办。本次会议以“Rock N Code,让技术发声”为主题。 会议中由TME技术领域专家、音乐行业优秀技术团队和语音界大咖对技术成果进行了分享,同时共…

2021年10月15日至18日,第十六届全国人机语音通讯学术会议(NCMMSC2021)在江苏省徐州市举行。作为国内语音领域广大专家、学者和科研工作者交流最新研究成果的重要平台,NCMMSC 受到了国内语音领域的广泛关注。 会议网址:htt…

第十六届全国人机语音通讯学术会议(NCMMSC 2021)公布“长短视频多语种多模态识别挑战赛”(Video Keyword Wakeup Competition)-— 汉语长短视频直播语音关键词(VKW)任务最终成绩。 历时4个月的征集与…
伴随着视频技术的进步和标准的迭代,视频产业从模拟进入到数字时代,完成了从电影电视到互联网的媒介转换,并且衍生出了超高清、3D、AR/VR 等多种创新形态。特别是在后疫情的当下,我们可以看到音视频技术领域的诸多新变化,云与端的协同互动、算法创…

前沿 本文大家一个完整的中文语音识别系统,包括声学模型和语言模型,能够将输入的音频信号识别为汉子 该系统实现了基于深度框架的语音识别中的声学模型和语言模型建模,其中声学模型包括CNN-CTC、GRU-CTC、CNN-RNN-CTC,语言模型…
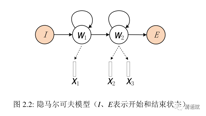
语音识别的全程是自动语音识别(Automatic Speech Recognition,ASR),说得多了,就把“自动”省去了,认为“自动”是理所当然的了。语音识别属于序列转换技术,它将语音序列转换为文本序列。大体来说,这是一次搬运,是吧一…

在过去的一年中,我们可以看到多媒体特别是音视频技术的能力在严峻的挑战下,为各行各业带来了巨大的变化。疫情过后,又会有哪些多媒体新技术、新实践呈现在大众的视野当中?为行业的发展与应用带来哪些新的趋势与机会? 10 月 29 日 - 30 日,…