LLM进入「拖拽时代」!只靠Prompt,几秒定制一个大模型,效率飙升12000倍

来源丨新智元 最近,来自NUS、UT Austin等机构的研究人员创新性地提出了一种「拖拽式大语言模型」(DnD),它可以基于提示词快速生成模型参数,无需微调就能适应任务。不仅效率最高提升12000倍,而且具备出色的零样本泛化能力。 现在的…
17 1 0

来源丨新智元 最近,来自NUS、UT Austin等机构的研究人员创新性地提出了一种「拖拽式大语言模型」(DnD),它可以基于提示词快速生成模型参数,无需微调就能适应任务。不仅效率最高提升12000倍,而且具备出色的零样本泛化能力。 现在的…
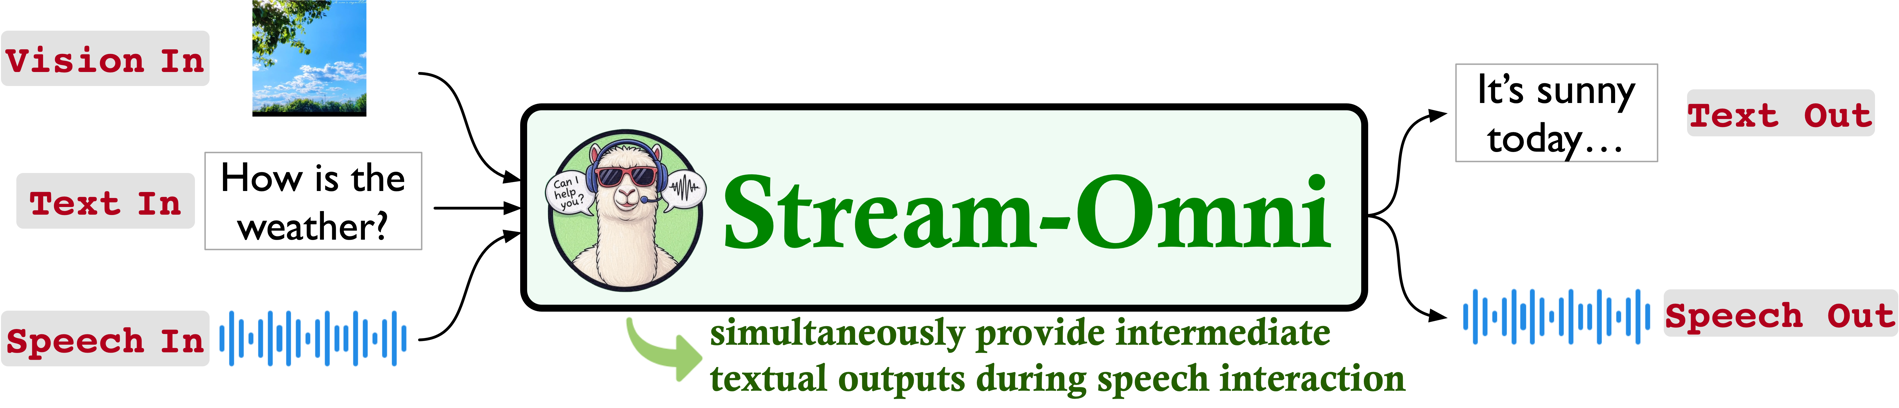
Stream-Omni是由中国科学院计算技术研究所智能信息处理重点实验室、中科院人工智能安全重点实验室及中国科学院大学联合推出的大型多模态语言模型。该模型对标GPT-4o,实现了文本、视觉、语音三种模态的无缝融合交互。 GitHub仓库:h…
来源丨机器之心 6 月 16 日,腾讯 AI Lab 推出并开源 SongGeneration 音乐生成大模型。 SongGeneration主要解决音乐 AIGC 中音质、音乐性与生成速度这三大共性难题,基于 LLM-DiT 的融合架构,…
GUIRoboTron-Speech团队投稿, 来源丨量子位 由美团和浙江大学联合推出的GUIRoboTron-Speech——让用户解放双手,直接对计算机“发号施令”。 这是首个能够直接利用语音指令和设备屏幕截图进行端到端(End-to-…
当前全球现存超 7000 种语言,学术界和工业界对多语种语音识别(Multilingual Automatic Speech Recognition)的研究热度持续攀升,核心目标在于扩大语种覆盖范围并提升跨语言识别性能[1][2]。然而,基…
本文介绍清华大学人机语音交互实验室(THUHCSI)在ICLR 2025发表的论文:RFWave:基于多频带Rectified Flow的高效音频波形重建。 本文由来自传音控股TEX AI的刘朋、独立研究员代东洋以及清华大学深圳国际研究生院…
大规模训练语料库极大地提高了语音识别(ASR)模型的性能。然而由于数据相对匮乏,口音和方言仍然是大多数ASR模型面临的挑战。自监督学习的最新进展表明,其与大型语言模型(LLM)相结合,可以有效提高低资源场景下的 ASR 性能。 近期,西工大…
来源丨电影声音网 在上周四发布的官方声明中,MPSE(电影声音剪辑师协会) 正式发布 2025 年度奖项将不受理任何使用生成式人工智能制作声音的成品作品,此举划定了奥斯卡、艾美奖及其他主要机构尚未实施的界限。 金卷轴奖主要表彰电影、电视和游…
在真实对话里,插话、停顿、甚至讲话重叠都很常见。如果语音 AI 的回应太早、太晚、或者干脆没有回应,整个用户体验就会变得很“出戏”。对话中的“怎么说”往往比“说了什么”更重要。一段停顿可能代表犹豫、礼貌、自信等不同含义。为了让语音 AI 真…
