
声浪

ICASSP 2025 | 基于元数据增强的语音情感识别

语音情感识别(Speech Emotion Recognition, SER)通过分析语音信号来判断说话者的情绪状态,其中充分利用音频信息至关重要。近期,清华大学语音与音频技术实验室(SATLab)提出了一种基于增强残差集成与协同注意力两阶…
14 0 0
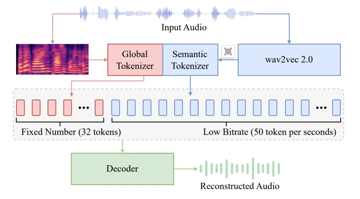
从SparkTTS看Decoder-Only方向:语音合成新范式探析
在语音合成(Text-to-Speech, TTS)领域,传统的 TTS 系统主要包括自回归(Autoregressive, AR)模型、非自回归(Non-Autoregressive, NAR)模型以及结合两者优点的混合范式(AR+NAR…
25 0 0
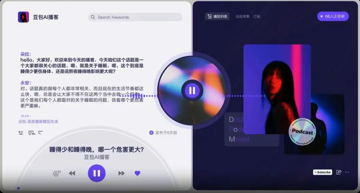
字节发布AI豆包 · 语音播客模型!
昨天,火山引擎旗下豆包团队推出的豆包·语音播客模型,以三大核心技术突破重塑播客内容生产逻辑。这一模型基于流式技术实现文本到双人对话式播客的即时转换,生成的自然语音在流畅度、情感表现和语义连贯性上均达到专业录制水准,甚至能通过深度搜索功能在5…
20 0 0
从“无差别降噪”到“精准语音保留”:非因果优化技术为助听设备和耳机降噪注入新活力
在复杂环境中保持清晰语音感知一直是助听设备与消费级耳机的核心挑战。传统主动降噪(ANC)技术虽能抑制环境噪声,但会无差别削弱所有声音,导致用户难以听清目标方向的语音(如对话者)。近年来,开放式耳机因佩戴舒适、减少耳道堵塞效应等优势备受关注,…
27 0 0
议程发布丨IEEE国际声学语音与信号处理会议(ICASSP 2025)苏州卫星会议
2025年IEEE国际声学语音与信号处理会议(International Conference on Acoustics, Speech, and Signal Processing,ICASSP 2025)苏州卫星会议即将于5月23日-2…
13 0 0
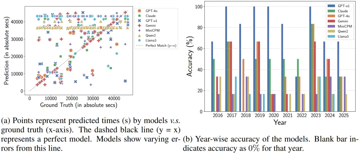
LLM又曝致命缺陷:根本不会看时钟!博士惊呆,准确率不及50%
来源丨新智元 AI能写论文、画图、考高分,但连「看表读时间」「今天是星期几」都错得离谱?最新研究揭示了背后惊人的认知缺陷,提醒我们:AI很强大,但精确推理还离不开人类。 有些任务对人类来说轻而易举,但AI频频出错。比如,单词「strawbe…
14 0 0