OpenAI再次发布自动语音识别和语音合成大模型(替换Whisper系列)

2025年3月20日,OpenAI推出了三款新模型——gpt-4o-transcribe、gpt-4o-mini-transcribe 和 gpt-4o-mini-tts。前面2个是自动语音识别模型(ASR),最后一个是语音合成模型(TTS…
21 0 0

2025年3月20日,OpenAI推出了三款新模型——gpt-4o-transcribe、gpt-4o-mini-transcribe 和 gpt-4o-mini-tts。前面2个是自动语音识别模型(ASR),最后一个是语音合成模型(TTS…

分享3篇IMU语音理解与生成实验室被中科院一区Top期刊Information Fusion 录用的论文,内容涵盖对话语音合成、视听语音识别生成式纠错、语音鉴伪等。 《Information Fusion》在中科院分区中为计算机科学大类一区…
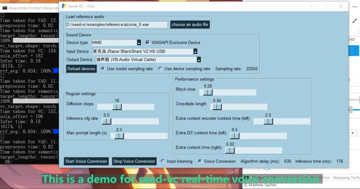
Seed-VC 是由开发者 Plachtaa 在 GitHub 上开源的项目,其灵感来源于字节跳动的 SEED-TTS 架构,是一款超强大的开源语音转换和歌曲转换工具。 项目地址:https://github.com/Plachtaa/se…


近期上海交通大学听觉认知与计算声学实验室,联合美国卡内基梅隆大学CMU和日本电报电话公司NTT,合作的论文“Module-Based End-to-End Distant Speech Processing: A Case Study of…

北美计算语言学协会年会(The North American Chapter of the Association for Computational Linguistics,NAACL)成立于1998年,每年举办一届,是自然语言处理和计算…

在 NLP 领域,大模型(LLMs)凭借其强大的理解和推理能力,正在重塑行业格局。另一方面,多模态大模型,尤其是以语音交互为核心的模型也开始崛起,技术发展迅猛,前景广阔。以 GPT-4o 为例,语音与大模型的端到端结合展示出了高实时性与强表…


