Easy Turn:全双工口语对话系统中融合声学与语言模态的鲁棒轮次转换检测

在自然人机交互中,实现如同人类般“边听边说”的全双工语音对话(Full-duplex Spoken Dialogue)一直是语音交互系统的终极目标。与传统的半双工系统不同,全双工系统要求模型能够在用户发言过程中,实时判断是否需要继续倾听、生…
34 0 0

在自然人机交互中,实现如同人类般“边听边说”的全双工语音对话(Full-duplex Spoken Dialogue)一直是语音交互系统的终极目标。与传统的半双工系统不同,全双工系统要求模型能够在用户发言过程中,实时判断是否需要继续倾听、生…
分享一款开源 TTS 模型:NeuTTS Air,它是一款免费、开源、轻量级的超逼真语音合成模型。 仅 0.5B 参数,但实际体验几乎媲美市面上许多商用 TTS 引擎。更关键的是,它能在手机、笔记本甚至树莓派这样的低功耗设备上流畅运行,真正…
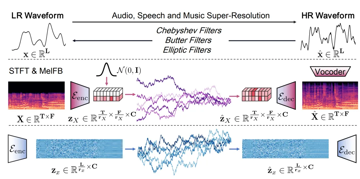
音频超分辨率(Audio Super-Resolution, Audio SR),即从低采样率音频恢复出高采样率版本,是提升语音清晰度、音乐细节与沉浸式音频体验的关键技术。无论是在老旧录音修复、语音通信增强,还是音乐制作与多模态生成中,高分…
主流自动语音识别(ASR)系统在转写词汇内容上表现优异,但普遍忽略了语音中蕴含的叹气、笑声等非语言发声(Nonverbal Vocalizations, NVs)。这一能力缺失限制了系统对人类交流意图与情感的全面理解,使得NV感知ASR(N…
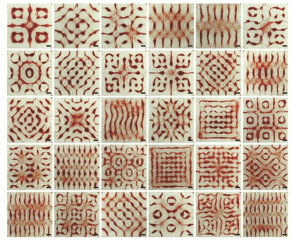
自从两百多年前第一支听诊器问世以来,从那时起到引力波那一瞬间短暂的“啾啾”声,声音在科技与科学发展的历史中始终回荡不息。 如今,声音在科学中的角色早已超越了人类可听的范围:超声波以及其他“无声”的声波,正被研究人员广泛应用,帮助他们突破传统…