声浪

腾讯推出Covo-Audio:7B 参数打通听 - 说 - 思,全双工对话 + 情感共情拉满

论文标题:Covo-Audio Technical Report 论文链接:https://arxiv.org/pdf/2602.09823v1 当语音助手能听懂指令、生成语音时,却常陷入 “逻辑脱节、交互僵硬、音色难定制” 的困境,要么只…
41 0 0
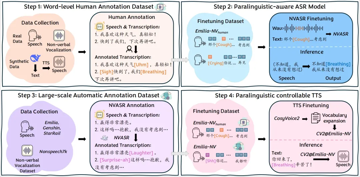
Emilia-NV:让ASR/TTS有“人味儿”的秘诀 | ICASSP2026
我们平时说话,信息不只在“字面内容”里,还藏在各种副语言声音里:笑、喘气、叹气、咳嗽,以及“嗯/啊/哦”这类带态度的语气词。它们在真实对话里承担了大量功能: 表达情绪与态度:开心的笑、无奈的叹气、不耐烦的“哼” 组织对话节奏:思考时的“呃/…
36 0 0
【交我学-27】多语种 ASR 技术2025 顶会论文汇总
AudioCC交我学 在全球化浪潮下,多语种语音识别(Multilingual ASR)技术成为打破语言壁垒的关键支撑。从低资源语种适配到零资源场景突破,从模型效率优化到实际场景落地,近期 Interspeech、ICASSP 等顶会涌现出…
37 0 0