语音/音频处理学术速递[3.16]

今日论文合集:cs.SD语音48篇,eess.AS音频处理51篇。 cs.SD语音 【1】 A Study on Bias and Fairness In Deep Speaker Recognition标题:深度说话人识别中的偏差和公平性…
294 0 0

今日论文合集:cs.SD语音48篇,eess.AS音频处理51篇。 cs.SD语音 【1】 A Study on Bias and Fairness In Deep Speaker Recognition标题:深度说话人识别中的偏差和公平性…

资深音频开发工程师 工作职责 1.负责RTC SDK里音频引擎的相关功能开发,以及线上音频质量问题的排查解决。 2.负责Android端音频设备ADM的相关研发工作,提高音频通话的体验和稳定性。 任职要求 1.本科及以上学历,信号处理、软件…

老铁们,好久不见,我是JayJay。 就在刚刚,北京时间3月15日凌晨,GPT-4问世。 现在,ChatGPT-Plus已经可以访问GPT-4: GPT-4是OpenAI在深度学习领域深耕的最新里程碑。GPT-4是一个大型多模态模型,接受图…

今日论文合集:cs.SD语音7篇,eess.AS音频处理19篇。 cs.SD语音 【1】 A two-stage speaker extraction algorithm under adverse acoustic conditions…

招聘岗位 语音算法工程师 (工作地点:上海) 工作职责 1.与阿里巴巴达摩院自然交互(NUI)领域技术研究团队一起合作,将业界先进水平的声学前端、语音唤醒、语音识别、语音合成、声纹识别技术落地车场景,打造车行业领先的语音能力。 2.针对TO…

招聘岗位 AI算法实习生 (地点:北京) 工作职责 1.负责自然语言处理、语音新技术的研究和探索工作,包括但不限于词法分析、自动对话、语义挖掘、语言逻辑、语音识别/合成/说话人识别等。 2.负责相关方向前沿技术的调研、实现,负责专利撰写、实…

GPT-4真的要来了!发布时间已确定: 就在下周。而且还是多模态,可支持视频。 听到这个消息,网友们直接炸了锅:大家都准备好了吗? 毕竟在一部分人眼中,ChatGPT都已经如此惊艳,那GPT-4不得是这样的? (不过100万亿参数是谣言)…
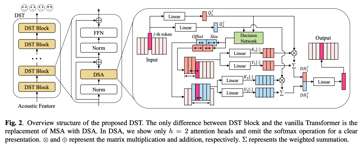
文章来源于智能语音新青年,作者ttslr 本次分享华南理工大学、优必选研究院等合作在ICASSP2023会议发表的论文《DST: Deformable Speech Transformer for Emotion Recognition》。…

今日论文合集:cs.SD语音7篇,eess.AS音频处理9篇。 cs.SD语音 【1】 Robust Knowledge Distillation from RNN-T Models With Noisy Training Labels U…

WeSpeaker正式更新C++部署链路,推理引擎使用OnnxRuntime,支持从语音中提取Speaker Embedding信息,代码详见WeSpeaker/runtime[1]。