
声浪

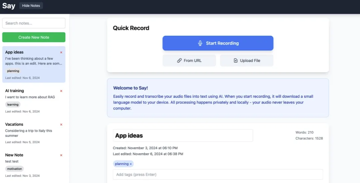
开源语音转文字神器!浏览器本地运行,无需上传,Whisper驱动,隐私+实时两不误!

语音转文字(STT)常需云端处理或复杂软件安装,隐私和便利性难以兼得。 Say是一款基于Whisper和Transformers.js的开源浏览器内语音转文字工具,完全本地运行,保护隐私,同时提供实时转录和富文本编辑。 其核心特点包括 •浏…
13 0 0
INTERSPEECH2025|Delayed-KD:面向流式语音识别的延迟知识蒸馏CTC方法
流式语音识别(streaming ASR)因其低延迟、高效率的特点,适用在诸多“快速出字”的应用中。当前主流的端到端模型包括 CTC、RNN-T 和基于注意力的编码器-解码器(AED)。其中 CTC 凭借结构简单,在流式场景中被广泛采用。为…
31 1 0
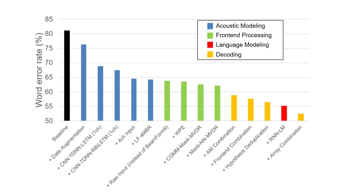
语音识别中有用的前端算法
嘈杂环境下的语音识别一直是该领域的一个较为困难的问题,虽然降噪算法可以提升语音质量,但是降噪后的语音对于语音识别的提升并不明显,甚至有可能起到相反的作用。因此在语音识别领域,更多的研究关注在如何让声学模型具有更好的噪声鲁棒性,比如在训练过程…
44 2 0
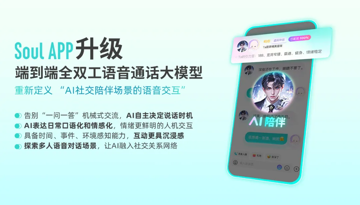
中文语音领域超强 “活人感” 模型来了,Soul App 升级自研端到端全双工语音通话大模型
近日,社交平台Soul App正式升级自研端到端全双工语音通话大模型,发布SoulX-DuoVoice。新模型摒弃了传统语音交互中依赖的 VAD(话音激活检测)机制与延迟控制逻辑,打破行业中普遍存在的“轮次对话”模式,赋予 AI 自主决策对…
26 0 0
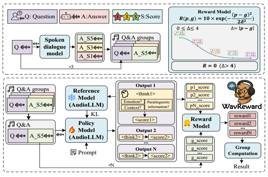
语音对话领域的首个强化学习奖励模型WavReward, 可以同时针对文本和语音信息进行反馈
近期,浙江大学联合阿里巴巴通义实验室发表了一篇题为“WavReward: Spoken Dialogue Models With Generalist Reward Evaluators”的论文。该论文提出了一种基于音频理解大模型Qwen2…
29 0 0
Interspeech 2025丨上交大跨媒体语言智能实验室6篇录用论文分享
分享上海交通大学 X-LANCE 跨媒体语言智能实验室6篇被interspeech2025录用论文。 01、LSCodec: Low-Bitrate and Speaker-Decoupled Discrete Speech Codec
24 0 0