
声浪

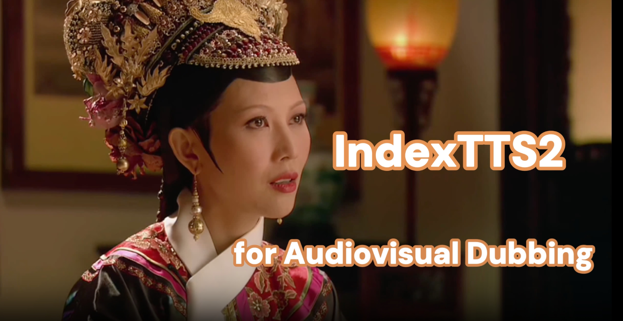
全球首创!B站推出影视级TTS语音模型,支持零样本语音+情绪双克隆,精准时长控制!

近年来,文本转语音(TTS)技术在影视配音、虚拟助手等领域需求激增,而高自然度和控制能力成为关键。而能将 TTS 技术做到“影视级”水准的,即使在全球范围内也是屈指可数。 但近日,B站语音团队推出了全新一代语音合成模型:IndexTTS2,…
21 0 0
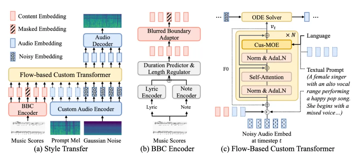
ACL 2025丨TCSinger2:高度可定制化的多语言零样本歌声合成
零样本歌声合成(SVS)旨在基于音频或文本提示,生成具有未见过的多级别风格的高质量歌声。该领域在专业音乐创作和短视频配音方面具有广泛的潜在应用。尽管传统的歌声合成任务已经取得了显著进展,但人们对更具定制化的体验需求日益增长。这不仅包括通过音…
16 0 0
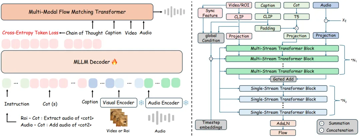
阿里通义开源首个CoT音频模型,比MMAudio更强视频配音!
近日,阿里通义实验室开源了旗下首个音频生成模型ThinkSound,该模型首次将CoT(Chain-of-Thought,思维链)应用到音频生成领域,让AI可以像专业音效师一样逐步思考,捕捉视觉细节,生成与画面同步的高保真音频。 目前,Th…
16 0 0
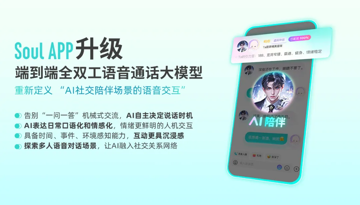
中文语音领域超强 “活人感” 模型来了,Soul App 升级自研端到端全双工语音通话大模型
近日,社交平台Soul App正式升级自研端到端全双工语音通话大模型,发布SoulX-DuoVoice。新模型摒弃了传统语音交互中依赖的 VAD(话音激活检测)机制与延迟控制逻辑,打破行业中普遍存在的“轮次对话”模式,赋予 AI 自主决策对…
27 0 0