
声浪

SongEval 驱动歌曲生成优化:DiffRhythm 1.2 正式发布

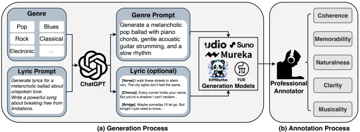
近年来,AI 作曲与歌声合成技术突飞猛进,但如何像人类一样评价一首“AI 歌曲”的美感始终是一大难题。现有客观指标往往忽视旋律记忆点、情感连贯性等主观维度,导致模型优化方向失焦。 为此,西工大音频语音与语言处理研究组(ASLP@NPU)与上…
51 0 0
ACL 2025 | 高感情语音技术:小语种TTS的破局之道
语音合成(TTS)技术近十年来突飞猛进,从早期的拼接式合成和统计参数模型,发展到如今的深度神经网络与扩散、GAN等先进架构,实现了接近真人的自然度与情感表达,广泛赋能智能助手、无障碍阅读、沉浸式娱乐等场景。 然而,这一繁荣几乎局限于英语、普…
39 0 0
从SparkTTS看Decoder-Only方向:语音合成新范式探析
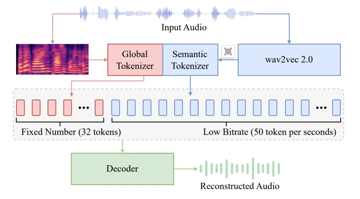
在语音合成(Text-to-Speech, TTS)领域,传统的 TTS 系统主要包括自回归(Autoregressive, AR)模型、非自回归(Non-Autoregressive, NAR)模型以及结合两者优点的混合范式(AR+NAR…
23 0 0