声加科技 | 招聘高级算法工程师(北京)

声加科技 北京声加科技有限公司成立于2018年1月,专注于通信声学核心技术,已先后通过中关村高新技术企业认证和北京市高新技术企业认证。为B端客户提供复杂场景下的近场、中场、远场语音交互技术方案,以及从芯片、模组、PCBA到工业设计的一站式产…
29 0 0

声加科技 北京声加科技有限公司成立于2018年1月,专注于通信声学核心技术,已先后通过中关村高新技术企业认证和北京市高新技术企业认证。为B端客户提供复杂场景下的近场、中场、远场语音交互技术方案,以及从芯片、模组、PCBA到工业设计的一站式产…
大象声科 大象声科(深圳)科技有限公司,简称Elevoc,于2017年在深圳成立,是全球领先的机器听觉人工智能公司之一,致力于提供尖端的智能语音增强和语音交互解决方案,打造更自然的人机交互体验。大象声科云集了一批来自世界顶尖机器听觉科学家和…
合成媒体初创公司Stability AI发布了其文本转音乐模型的升级版本。新的Stable Audio 2能够根据书面提示生成长达三分钟的音乐曲目,并且该工具还包含其他新功能。 Stable Audio 2增强了9月份发布的原始Stable…
语音增强 (Speech Enhancement) 旨在从噪声和混响等多种干扰中恢复并提升语音的质量及可懂度,以提升人耳听感和语音识别率。在深度学习的推动下,基于神经网络的语音增强技术取得了巨大的进展,在诸多数据集上都取得了卓越的性能。近期…
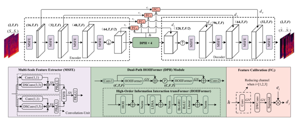
期刊介绍:IEEE Signal Processing Letters (影响因子: 3.9) 是一本旨在快速传播原创的、前沿的思想和及时的重要贡献的期刊,涵盖了信号处理、图像处理、语音处理、语言处理和音频处理等领域。 论文题目:IIFC-…
西工大音频语音与语言处理研究组(ASLP@NPU)在本届会议将携合作伙伴宣读论文10篇,涉及智能语音处理领域的众多研究方向,包括语音识别、语音合成与转换、语音增强等。论文的合作单位包括理想汽车、网易、喜马拉雅、字节跳动、马上金融、出门问问、…
作者:琚雨恺 个性化语音增强(personalized speech enhancement, PSE)也称为目标说话人提取(target speaker extraction,TSE),其主要目的是通过目标说话人的注册语音从复杂的受干扰的…
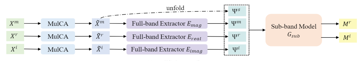
本文由清华大学与广州虎牙信息科技有限公司、香港中文大学合作,提出了一种新型的基于通道注意力机制的复数谱单通道语音增强网络 FullSubNet+,在低信噪比(SNR) 的条件下于抑制噪声恢复语音信号任务上取得了良好的效果,超越了现有的最好的…
个性化语音增强(personalized speech enhancement, PSE)也称为目标说话人提取(target speaker extraction,TSE),其主要目的是通过目标说话人的注册语音从复杂的受干扰的语音(如带噪、…