LLM进入「拖拽时代」!只靠Prompt,几秒定制一个大模型,效率飙升12000倍

来源丨新智元 最近,来自NUS、UT Austin等机构的研究人员创新性地提出了一种「拖拽式大语言模型」(DnD),它可以基于提示词快速生成模型参数,无需微调就能适应任务。不仅效率最高提升12000倍,而且具备出色的零样本泛化能力。 现在的…
12 1 0

来源丨新智元 最近,来自NUS、UT Austin等机构的研究人员创新性地提出了一种「拖拽式大语言模型」(DnD),它可以基于提示词快速生成模型参数,无需微调就能适应任务。不仅效率最高提升12000倍,而且具备出色的零样本泛化能力。 现在的…
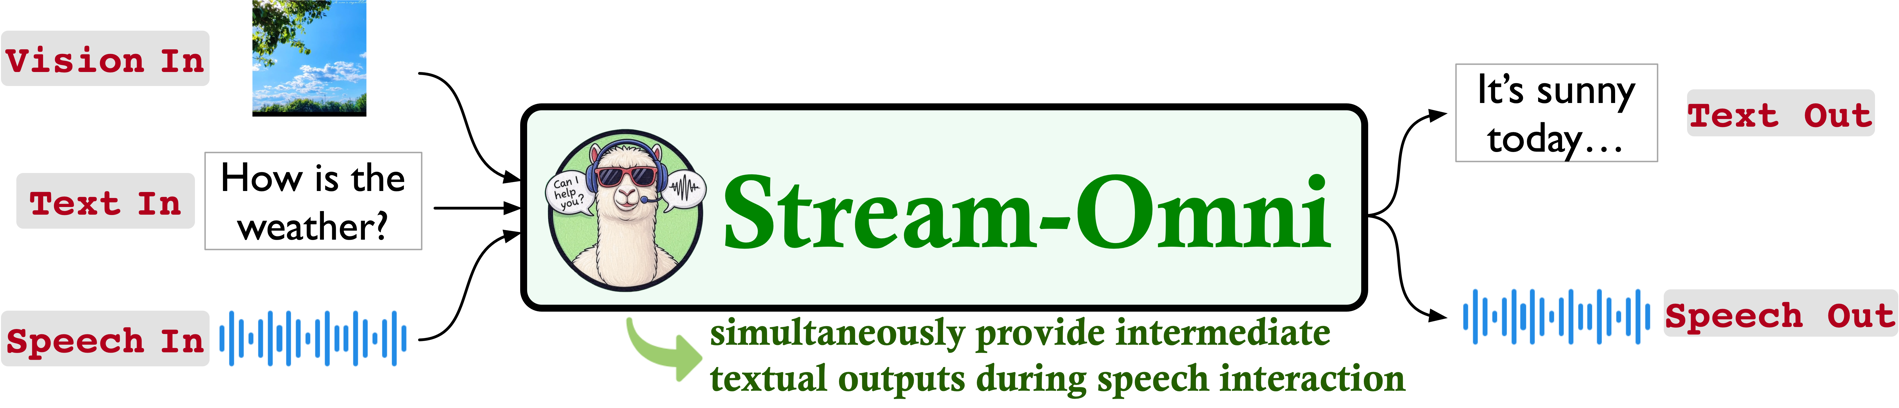
Stream-Omni是由中国科学院计算技术研究所智能信息处理重点实验室、中科院人工智能安全重点实验室及中国科学院大学联合推出的大型多模态语言模型。该模型对标GPT-4o,实现了文本、视觉、语音三种模态的无缝融合交互。 GitHub仓库:h…
本文介绍清华大学人机语音交互实验室(THUHCSI)在ICLR 2025发表的论文:RFWave:基于多频带Rectified Flow的高效音频波形重建。 本文由来自传音控股TEX AI的刘朋、独立研究员代东洋以及清华大学深圳国际研究生院…
在真实对话里,插话、停顿、甚至讲话重叠都很常见。如果语音 AI 的回应太早、太晚、或者干脆没有回应,整个用户体验就会变得很“出戏”。对话中的“怎么说”往往比“说了什么”更重要。一段停顿可能代表犹豫、礼貌、自信等不同含义。为了让语音 AI 真…
在 AI 语音模型领域,不论开源还是闭源模型,能在全球排上前十的屈指可数,而 FishAudio 团队语音模型就在其列,每每有新模型上线,总能排进TTS-Arena TOP3之内。 近期,Fish Audio 推出了新一代的 TTS 语音模…
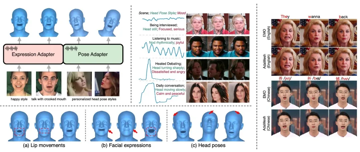
语音驱动的三维人脸动画旨在根据输入语音生成同步的面部运动,这项技术近年来受到了广泛关注。然而,现有方法普遍忽略了说话者的个性化风格,例如独特的面部表情和头部姿态,导致生成的人脸动画缺乏真实感和个性表达。部分工作尝试通过微调模型来建模不同人物…
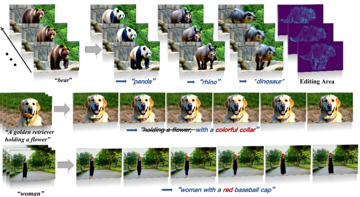
FlowDirector团队投稿 量子位 | 来源 AI的视频编辑方法总是存在一些问题:例如视频运动不连贯、编辑后的视频产生意外变化等……经过分析,这些问题的产生最终大都指向同一原因——反演-编辑范式。 因此,西湖大学AGILab提出了一种…
来源丨机器之心 清华大学交叉信息院和蚂蚁技术研究院的联合团队开源全异步强化学习训练系统 —— AReaL-boba² (AReaL v0.3)。 作为 AReaL 里程碑版本 AReaL-boba 的重磅升级,AReaL-boba² (正式…
来源丨新智元 智源研究院发布开源模型Video-XL-2,显著提升长视频理解能力。该模型在效果、处理长度与速度上全面优化,支持单卡处理万帧视频,编码2048帧仅需12秒。 长视频理解是多模态大模型关键能力之一。尽管OpenAI GPT-4o…
阿里开源 QwenLong-L1 长文本推理模型,其 32B 参数版本在七个长上下文文档问答基准测试中表现优异,相较于 DeepSeek-R1-Distill-Qwen-32B 平均提升 7.8%,超过 OpenAI-o3-mini、Qwe…