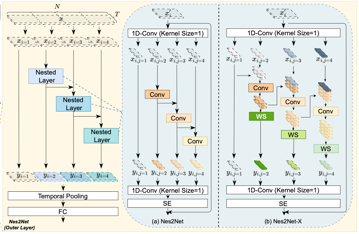
Nes2Net:轻量级嵌套架构,驱动基于语音大模型的深度伪造检测

随着语音领域生成式人工智能与音频伪造技术的迅猛发展,语音深度伪造(Deepfake),也称为语音反欺骗(Anti-spoofing),已成为信息安全领域的重要挑战。与此同时,基于语音大模型(如wav2vec 2.0 [1]、WavLM [2…
18 0 0

随着语音领域生成式人工智能与音频伪造技术的迅猛发展,语音深度伪造(Deepfake),也称为语音反欺骗(Anti-spoofing),已成为信息安全领域的重要挑战。与此同时,基于语音大模型(如wav2vec 2.0 [1]、WavLM [2…
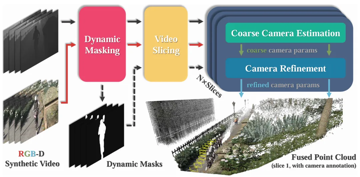
近日,上海人工智能实验室(上海 AI 实验室)开源了生成式世界模型 AETHER。该模型全部由合成数据训练而成,不仅在传统重建与生成任务中表现领先,更首次赋予大模型在真实世界中的 3D 空间决策与规划能力,可助力机器人完成目标导向的视觉规划…
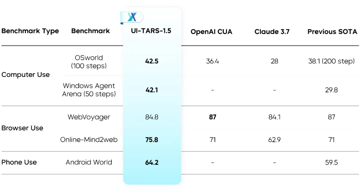
昨天字节开源多模态智能体 UI-TARS-1.5,这是一款基于视觉-语言模型构建的开源多模态智能体,能够在虚拟世界中高效执行各类任务。 GitHub:https://github.com/bytedance/UI-TARS Website:…
量子位 | 公众号 QbitAI 神奇!人类和海豚真的能实现跨物种交流了?当地时间4月14日(也是世界海豚日),谷歌CEO皮猜激动官宣: 隆重推出DolphinGemma,基于多年积累的海豚声音数据训练而成,有助于实现跨物种交流。 划重点,…
虽然扩散模型在视频生成领域展现出了卓越的性能,但是视频扩散模型通常需要大量的推理步骤对高斯噪声进行去噪才能生成一个视频。这个过程既耗时又耗计算资源。例如,HunyuanVideo [1] 需要3234 秒才能在单张 A100 上生成 5 秒…
字节跳动豆包团队今天发布了自家新推理模型Seed-Thinking-v1.5的技术报告。从报告中可以看到,这是一个拥有 200B 总参数的 MoE 模型,每次工作时会激活其中 20B 参数。其表现非常惊艳,在各个领域的基准上都超过了拥有 6…
来源丨AIGC开放 社今日,AI界突现开源重磅——Together AI与Agentica全面开源DeepCoder-14B-Preview,不仅开放模型权重,更罕见公开了完整训练数据、方法及优化细节。 开源地址:https://huggi…
来源丨新智元 近日,关于Meta Llama 4的「训练作弊」爆料搞得沸沸扬扬。Meta迅速反击,Licheng Yu、Di Jin及GenAI负责人Ahmad Al-Dahle接连辟谣,首席AI科学家Yann LeCun也亲自下场力挺。与…
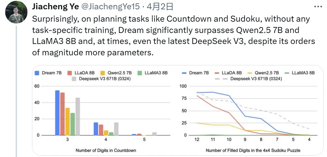
语言是离散的,所以适合用自回归模型来生成;而图像是连续的,所以适合用扩散模型来生成。在生成模型发展早期,这种刻板印象广泛存在于很多研究者的脑海中。 👆扩散语言模型展示👆 但最近,这种印象正被打破。更多的研究者开始探索在图像生成中引入自回…
在当今数字化时代,语音识别技术已成为人机交互的关键桥梁,广泛应用于智能客服、语音助手、会议转录等众多领域。然而,对于东方语言的识别如越南语、缅甸语等,现有模型往往表现不佳,难以满足用户的需求。为解决这一难题,海天瑞声携手清华大学电子工程系语…