蚂蚁集团提出基于音频贡献的后训练数据分配范式,突破音频-语言大模型性能瓶颈,数据集已开源

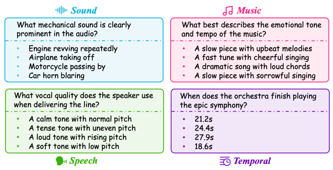
近日,蚂蚁集团AI身份智能团队在音频-语言大模型的后训练研究上取得重要突破。团队联合香港中文大学、上海交通大学、华南理工大学、萨里大学等国内外知名学府,提出了迄今为止规模最大、质量最高的音频理解选择题数据集AudioMCQ,并基于Audio…
18 0 0

近日,蚂蚁集团AI身份智能团队在音频-语言大模型的后训练研究上取得重要突破。团队联合香港中文大学、上海交通大学、华南理工大学、萨里大学等国内外知名学府,提出了迄今为止规模最大、质量最高的音频理解选择题数据集AudioMCQ,并基于Audio…