CVPR 2024|基于运动解耦扩散模型的语音驱动共语手势视频生成
CVPR 2024 基于运动解耦扩散模型的语音驱动共语手势视频生成 本文由清华大学与华为云计算公司、华为诺亚实验室、香港中文大学合作,研究虚拟数字人共语手势(co-speech gestures)视频的自动生成。现有共语手势生成工作大多停留…
75 0 0


CVPR 2024 基于运动解耦扩散模型的语音驱动共语手势视频生成 本文由清华大学与华为云计算公司、华为诺亚实验室、香港中文大学合作,研究虚拟数字人共语手势(co-speech gestures)视频的自动生成。现有共语手势生成工作大多停留…

人类对自身的研究和模仿由来已久,在我国2000多年前的《列子·汤问》里就描述了有能工巧匠制作出会说话会舞动的类人机器人的故事。声音包含丰富的个体特征及情感情绪信息,对话作为人类最常使用亲切自然的交互模式,是连接人与智能世界至关重要的环节。…


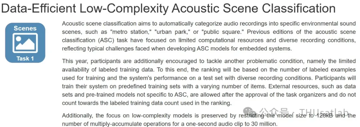
在刚刚结束的2024年DCASE(Detection and Classification of Acoustic Scenes and Events)挑战赛中,由华控智加、清华大学电子工程系、上海交通大学计算机科学与工程系、华北电力大学组…


启英泰伦 成都启英泰伦科技有限公司(以下简称“启英泰伦”)于2015年11月在成都高新区注册成立,是集语音芯片、语音算法、应用方案、开发平台于一体的行业领导型语音解决方案供应商。公司致力于为用户提供更自然、更简单、更智能的人机交互体验,让“…

冠旭电子 深圳市冠旭电子股份有限公司于1997年成立于中国深圳,总部位于深圳龙岗坪地国际低碳城中心区。 公司主要从事专业音频、智能耳机及智能音箱等智能终端产品的研发、制造及品牌营销。凭借全方位、多领域的核心技术体系及精益化生产管理能力等综合…

与爱为舞 北京与爱为舞科技有限公司站在教育革新的最前沿,利用尖端的人工智能技术为教育事业注入新的活力。全面提升人才培养的素质,同时显著降低人才培养成本,共同开创教育领域的新篇章。公司总部在北京,截至2024年5月,3个中心分布在石家庄、郑州…