声纹识别算法、资源与应用(一)
一、算法 Speaker recognition以2012年为分水岭,由statistics-based machine learning,跨到了以deep learning为主线的算法。随后,bottleneck feature、d-ve…
179 0 0


一、算法 Speaker recognition以2012年为分水岭,由statistics-based machine learning,跨到了以deep learning为主线的算法。随后,bottleneck feature、d-ve…
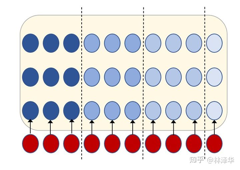
流式语音识别模型(Streaming ASR Model)是指可以在处理音频流的过程中,支持实时返回识别结果的一类 ASR 模型。与之相对的是非流式模型,它必须在处理完整句音频后才能返回结果。流式 ASR 可以更好地用于需要实时获取识别结果…

由CCF语音对话与听觉专委会 、中国人工智能产业发展联盟(AIIA)评估组 、语音之家(北京)科技有限公司、北京希尔贝壳科技有限公司共同主办的【语音之家】AI产业沙龙-智能对话平台,将于2021年11月8日14:20通过语音之家微信视频号直…

音频的模式识别包括了几个主干任务如音频标注(audio tagging)、声学场景分类(acoustic scene classification)、和声音事件检测(sound event detection)。本文主要通过几篇论文的研究[…

Leaderboard 项目新增基于 WenetSpeech 数据集的 WeNet 预训练模型,识别准确率如下: 具体数字如下: 该模型可与公众号之前发布的开源测试集配合使用,进行本地复现和验证,模型的下载命令为: ops/pull mod…

唤醒 熟悉Kaldi ,并且搞清当中做语音唤醒的功能 一个不错的github 资https://github.com/zycv/awesome-keyword-spotting#opensource-code https://papersw…

续上一篇文章说话人识别中PLDA的背景与训练,在这里,我进一步把PLDA的打分过程进行推演。说实话,two-covariance PLDA打分的数学部分,比训练模型部分还要复杂和困难;这部分也鲜有博客或文章去分析,但能理解一次,对于提升ba…

我们常见的PLDA,是出自《Probabilistic Linear Discriminant Analysis for Inferences About Identity》,由Simon J.D. Prince和James H. Elde…

近日,由腾讯音乐娱乐集团(TME)主办的音乐娱乐技术盛会“TechME技术周”在深圳成功举办。本次会议以“Rock N Code,让技术发声”为主题。 会议中由TME技术领域专家、音乐行业优秀技术团队和语音界大咖对技术成果进行了分享,同时共…

2021年10月15日至18日,第十六届全国人机语音通讯学术会议(NCMMSC2021)在江苏省徐州市举行。作为国内语音领域广大专家、学者和科研工作者交流最新研究成果的重要平台,NCMMSC 受到了国内语音领域的广泛关注。 会议网址:htt…