
 语音小管家
大家好,欢迎来到「AudioCC交我学」专栏!
作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术创新与应用实践的最新动态。我们将用通俗易懂的语言拆解复杂理论,用数据与实验结果验证技术价值,带你快速了解最新、最有趣的学术论文,打破学术与大众之间的壁垒,让你在碎片化的时间里也能 get 到前沿知识!
引言
近年来,随着语音合成与转换技术的快速发展,音频伪造(Audio Deepfake)攻击的复杂度持续上升,给语音验证、内容安全和人机交互系统带来了严峻挑战。尽管检测模型的性能不断提升,但一个根本性的问题依然存在:
这些模型到底是“怎么识别”出伪造语音的?
在真实世界中部署这些模型,需要的不只是准确率,更需要可解释性——即理解模型“关注了什么”“依赖了什么信息”以及“做出判断的依据是什么”。否则,即便检测结果正确,我们也无法信任或调优模型,更难应对新型攻击。
针对这一问题,近年的研究发展出三种主要的解释路径,分别从不同角度尝试“读懂”检测模型的决策机制:
从模型“学到了什么”来解释:通过分析模型的特征表示,揭示其如何编码伪造相关的信息。
从“改动输入”来解释:通过保留或删除某些输入部分,观察性能变化,反推模型依赖的关键信息。
从“模型看哪里”来解释:使用可解释AI方法(如SHAP、Grad-CAM),可视化模型判别时的关注区域。
本文将围绕这三种解释路径,结合最新论文与方法,带你系统了解音频伪造检测中的解释性探索。
一、从模型“学到了什么”来解释:表征分析法
当我们训练一个语音伪造检测模型时,它其实是在将音频信号编码成某种向量表示(embedding),然后基于这个表示做出真假判断。那么这些表示中,究竟包含了哪些信息?它到底是凭什么判别出“这段语音是伪造的”?这一类方法的目标,就是打开模型的“黑箱”表示空间,去分析它究竟学到了什么样的特征信息。
代表方法一:探针任务 (ICASSP 2025)
这项工作使用探针任务(probing task)来分析两类模型生成的嵌入向量,一类用于说话人识别(ASV embedding),一类用于检测伪造(CM embedding)。通过训练轻量的多层感知机(MLP),探测这些向量中是否保留了以下信息:
说话人特征:性别、年龄、口音
攻击信息:伪造方法(TTS、VC)
音频特征:音高(F0)、语速、信噪比等
结果发现,说话人模型的向量主要保留了说话人特征;而检测伪造的模型刻意弱化了说话人信息,只保留与攻击相关的声学特征,尤其是攻击类型和F0结构。这表明模型在“主动学习”伪造特征,而不是单纯依赖说话人差异。
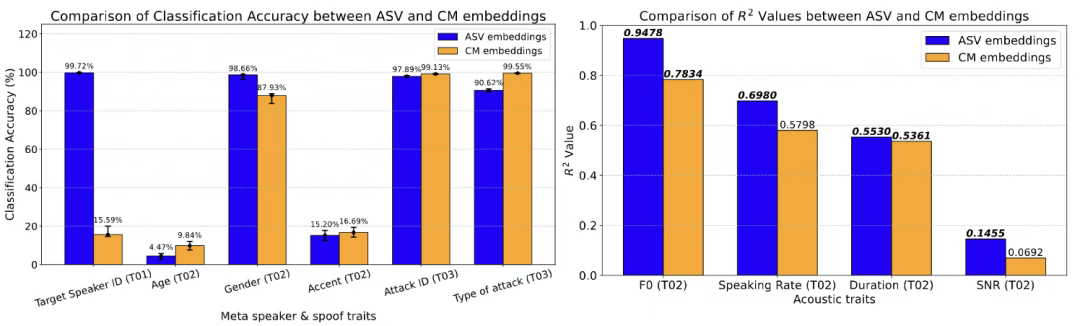
图 1: ASV 与 CM 嵌入在不同属性上的分类准确率(左)与回归效果(右)
代表方法二:概率属性向量(ICASSP 2025)
这项工作将模型提取的高维嵌入向量通过浅层MLP,通过浅层 MLP 映射到一个低维、具备语义的属性空间。每一维表示一个伪造相关的技术属性(如 声码器(vocoder)类型、声学建模、时长模型等),构成概率属性向量。通过对这些向量进行决策树分析和 Shapley 归因,可以量化每个属性在检测任务和攻击归因中的作用。
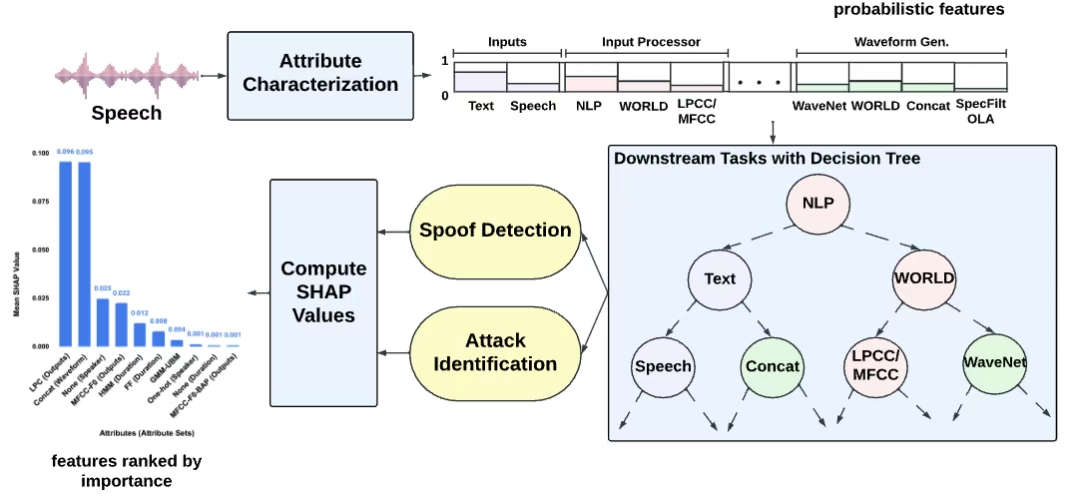
图2 概率属性向量提取示意图
结果发现,嵌入向量中自然编码了多种关键的伪造属性,模型在做出真假判断时更依赖声码器、声学建模等特征;而在进行攻击来源归因时,时长模型和输入类型等属性则体现出更强的区分能力。这表明,即便是黑盒模型,其嵌入表示中也蕴含着丰富的可解释结构。
二、从输入改动来解释:操控实验
如果我们无法直接理解模型内部在做什么,那是否可以通过“扰动输入”来观察它的反应?这一类方法就是基于这样的思路:通过选择性地保留、移除或替换输入的某些部分,来评估这些区域对模型判别结果的影响,从而推断出模型“依赖了哪些信息”。相比于分析模型结构或嵌入表示,这类方法更关注模型的输入敏感性,是判断特征重要性的一种“行为层面”解释手段。
代表方法一:openSMILE声学特征(ICASSP 2025)
这项工作采用传统的 openSMILE 工具包提取 88 维可解释声学特征(如音高、抖动、响度等),使用简单的线性分类器(如 logistic regression)在 ASVspoof 5 数据集上进行伪造检测。
结果显示,即便只使用单一特征,也能在部分攻击场景中取得极低的 EER(最低可达 0.8%)。而对比不同攻击类型时,模型所依赖的关键特征也发生变化,揭示了不同 TTS 系统的“指纹效应”。
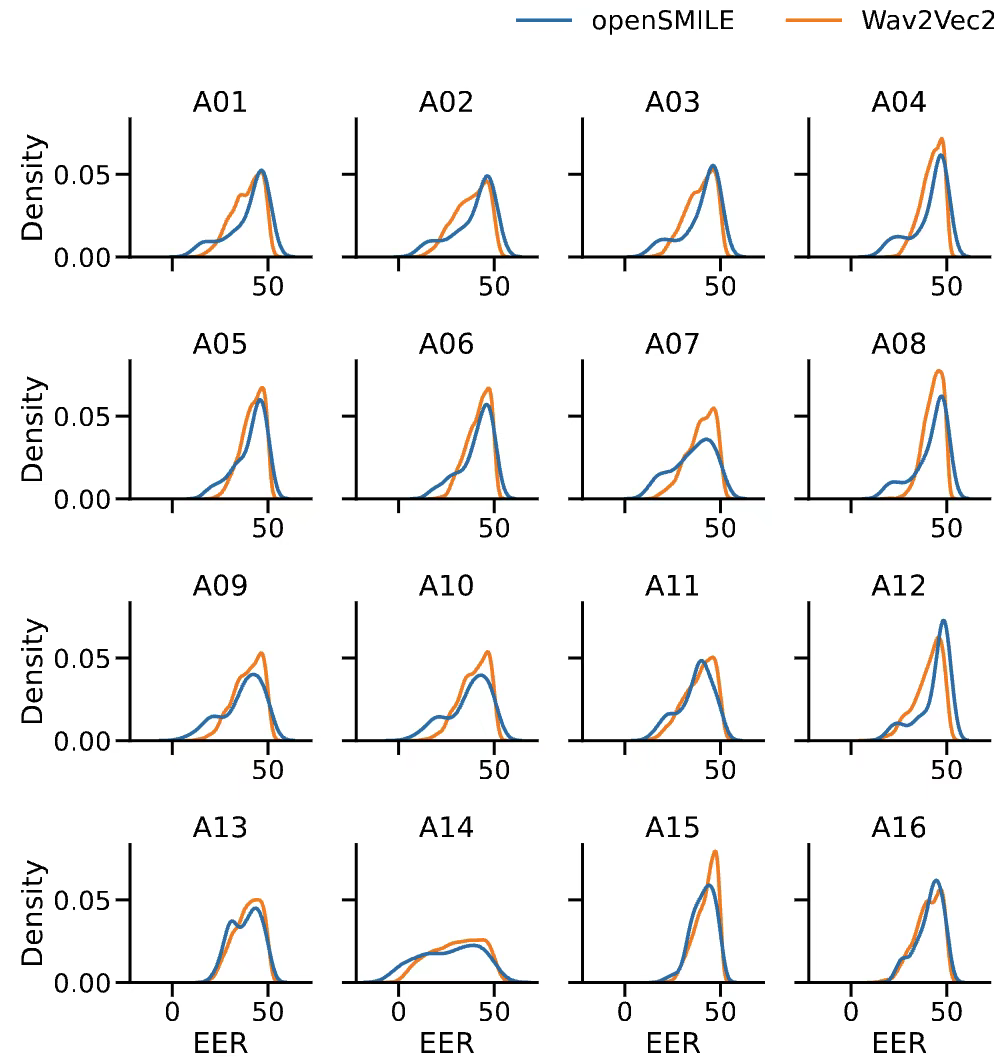
图3 openSMILE与 Wav2Vec2特征在多种攻击下的 EER 分布对比
代表方法二:清音与浊音区域(ICASSP 2025)
这项工作从语音信号本身的构成出发,将音频划分为“浊音”(带声带振动, voiced)和“清音”(无声带振动, unvoiced)区域,分别分段提取这两类区域,并独立输入伪造检测模型进行评估,从而观察它们对判别性能的影响。
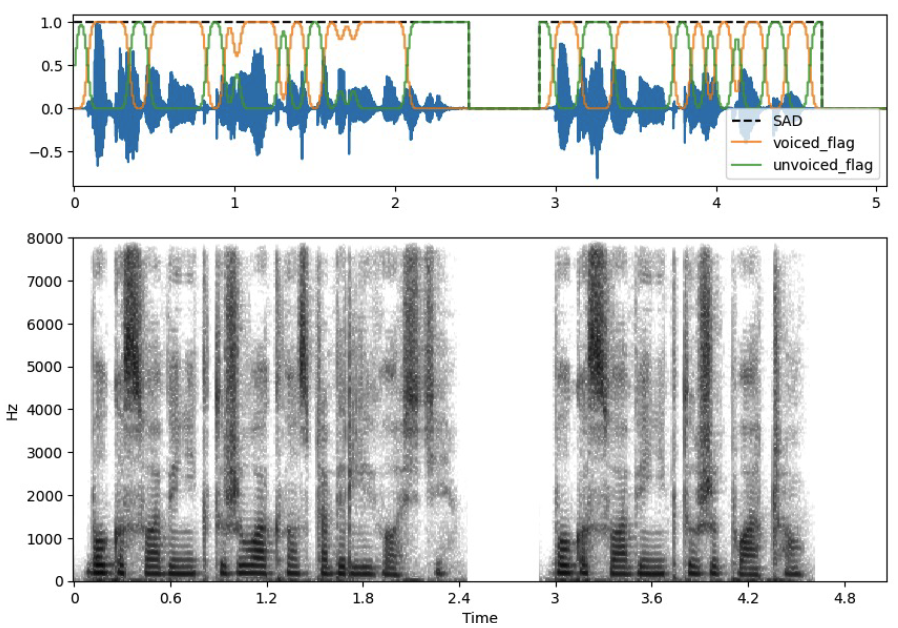
图4 浊音和清音区域示意图
在实验中发现,清音区域虽然在整段语音中占比不高,持续时间短,但却包含了丰富的伪造辨别信号,尤其在一些伪造攻击中,这些部分更容易暴露不自然的拼接或缺失特征。此外,将清音与浊音区域的得分进行融合,还能进一步提升整体检测效果。
三、从模型“看哪里”来解释:可视归因
即使我们无法深入模型结构,也可以“观察”模型做出判断时关注了哪些输入区域。这类方法依赖于可解释人工智能(XAI)技术,通过分析梯度、注意力或特征贡献度,为输入的每一帧或时间段分配“相关性权重”,从而生成可视化热图或时间轴归因图。与第二类操控方法不同,这类技术不需要修改输入或模型结构,而是借助外部分析框架,揭示模型内部的“关注模式”。
代表方法一:SHAP分析(Interspeech 2022)
这项工作引入 SHAP(SHapley Additive Explanations)这一经典的模型无关可解释性框架,分析音频伪造检测模型在不同输入区域的“归因强度”。研究中,作者将 SHAP 分别应用于以波形或频谱图为输入的神经网络模型,通过与一组参考样本的比较,计算出每一帧(或每一频点)对最终判断结果的正负影响程度。最终输出是一张带有时频分布的归因热图,可以直观展现模型关注的区域与方向。
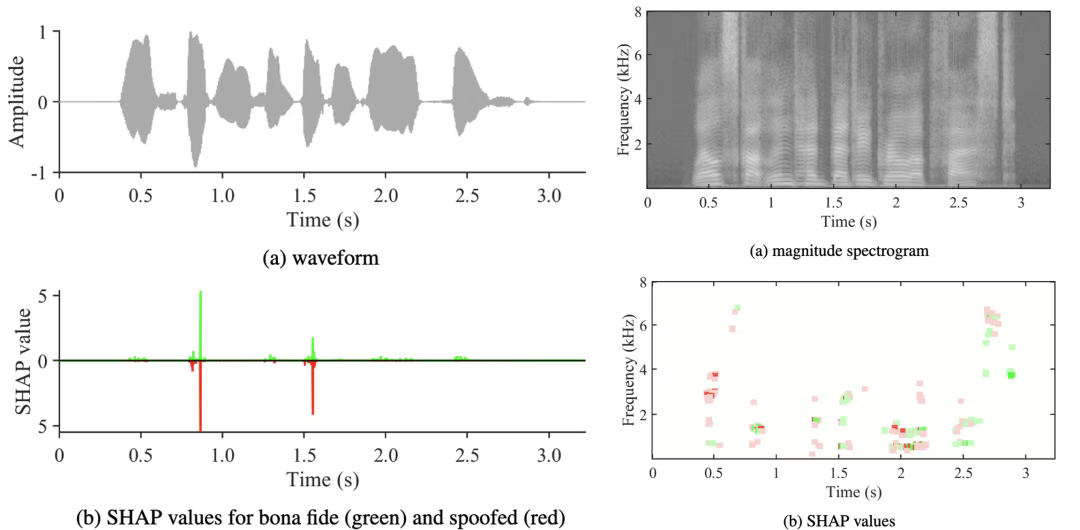
图5 真实(绿)或伪造(红)音频波形图和频谱图上的SHAP值
研究表明,不同类型的伪造攻击在 SHAP 热图中呈现出显著不同的“关注模式”。例如,基于 TTS 的伪造语音在模型眼中通常在音频起始段或边界区域暴露出异常贡献度,而 VC 类攻击则更容易在连续元音或频率突变段留下痕迹。这表明检测模型实际上已经捕捉到了一些攻击算法固有的特征缺陷。此外,模型在处理自然语音时的归因分布通常更为平滑,而面对伪造音频时,SHAP 显示的高贡献区域更集中、更具局部性,反映出模型对“非自然构造痕迹”的敏感性。
代表方法二:GATR分析(ICASSP 2025)
这项工作针对当前主流的 Transformer 架构伪造检测模型,提出了一种专门适配时间域解释的可视化方法——GATR(Gradient Average Transformer Relevancy)。传统的可解释方法(如 Grad-CAM、SHAP)主要针对卷积结构或频谱图像设计,难以直接用于时间域输入的 Transformer。GATR 的核心思路是:在模型多个注意力层中,提取注意力权重与梯度信息,通过加权平均的方式,计算每一帧语音在输出判别中的整体“相关性得分”,进而生成稳定的帧级热图
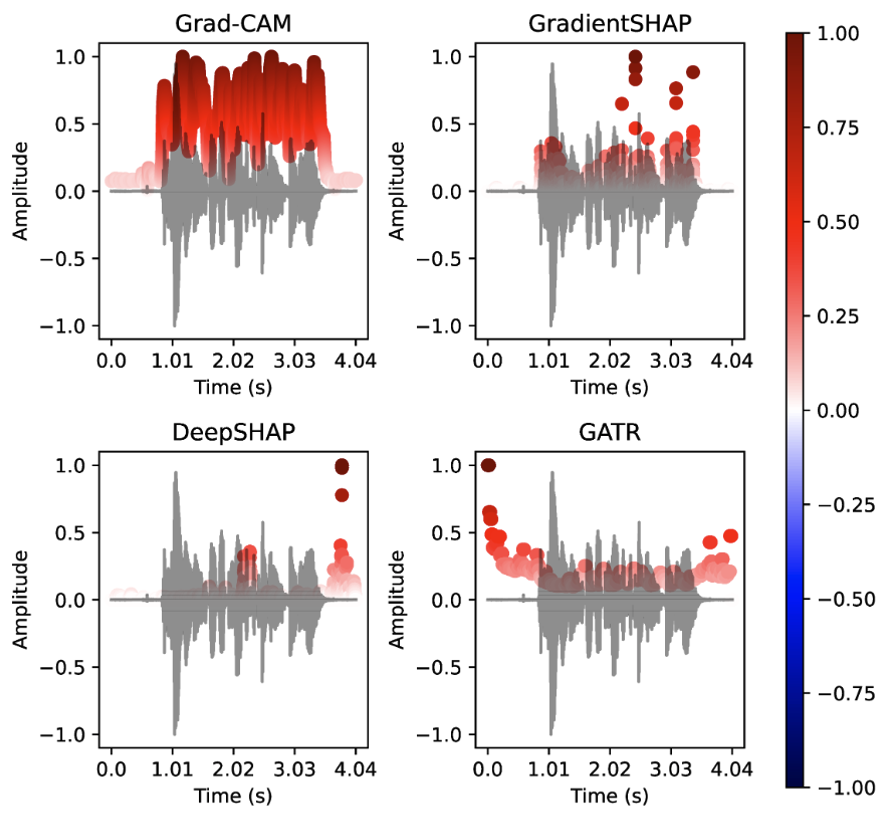
图6 不同XAI方法在同一条音频上的可视化结果
作者在 ASVspoof 数据集上,对多个伪造检测模型应用 GATR 分析,并进行系统性比较。结果显示,模型在伪造音频中的关注点显著偏向于静音段、语音片段边界、语速突变处等非主干内容区域。这些区域往往在合成或转换中更容易出现失真或异常,因此成为模型判别时重点“审视”的位置。此外,GATR 热图还揭示出模型在处理不同攻击类型时注意力模式会随之变化:如面向 TTS 的检测模型更关注语音的起始突发段,而应对 VC 的模型则倾向于检测持续语音段中的不一致性。
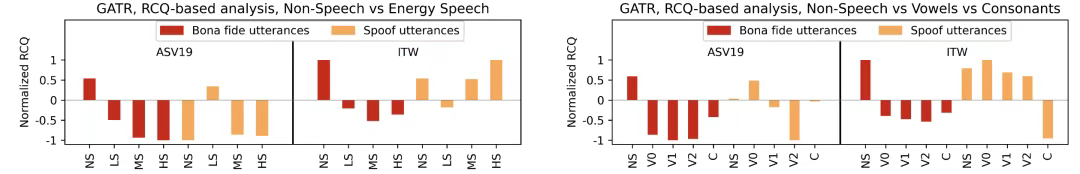
图7 真实或伪造音频通过GATR计算得到的RCQ分数
四、总结
音频伪造检测模型的“可解释性”正在成为研究与应用中的关键议题。通过梳理当前主流方法,我们可以看到三种具有代表性的解释路径正在形成:
从模型内部表示出发,揭示其编码了哪些说话人属性与伪造特征;
通过输入操控实验,评估模型究竟依赖了语音的哪些区域或信息维度;
借助可视归因技术,在时域或频域上呈现模型的“关注焦点”。
这些方法从不同层面回答了同一个问题:模型到底是如何识别出伪造语音的? 它们不仅提升了我们对检测机制的理解,也为模型调试、攻击归因、系统增强等任务提供了新的工具与思路。
五、思考与讨论
在你所在的工作场景或研究中,是否也面临过模型不可解释、结果难以信任的问题?你更倾向于使用哪类解释方式?
欢迎交流你的看法或经验!
