
 语音小管家
大家好,欢迎来到「AudioCC交我学」专栏!
作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术创新与应用实践的最新动态。我们将用通俗易懂的语言拆解复杂理论,用数据与实验结果验证技术价值,带你快速了解最新、最有趣的学术论文,打破学术与大众之间的壁垒,让你在碎片化的时间里也能 get 到前沿知识!
一、任务介绍
想象在嘈杂的酒吧里,你虽然听不清朋友说什么,却能通过 TA 的唇形读懂意思 —— 这就是人类的 “视听协同” 能力。而视听语音识别(AVSR)正是让机器拥有这种能力的技术:它结合音频信号与视觉信息(如唇部运动),实现更鲁棒的语音识别。
传统语音识别(ASR)在噪声环境中易失效,而 AVSR 通过视觉模态提供的 “抗噪线索”(如唇部开合、舌位变化),能显著提升识别准确率。例如,当音频模糊时,“ba” 的声音搭配 “ga” 的口型,AVSR 可识别为 “da”,这就是视听协同效应的魅力。
尽管潜力巨大,AVSR 的发展仍面临三大核心难题:
计算成本高昂:随着模型复杂度提升(如基于大语言模型 LLM 的 AVSR),计算资源需求激增,阻碍了实时部署。
模态融合低效:音频与视觉信息的互补优势未被充分发挥,如何高效融合两种模态仍是关键瓶颈。
数据集稀缺:现有视听数据集难以兼顾数据量、场景多样性和规范实验设置,非英语数据集尤其匮乏,限制了多语言应用。
下面我们分别介绍现有的研究如何克服这些难题。
二、计算成本优化
MMS-LLaMA:用 “查询分配” 减负
论文标题:MMS-LLaMA: Efficient LLM-based Audio-Visual Speech Recognition with Minimal Multimodal Speech Tokens
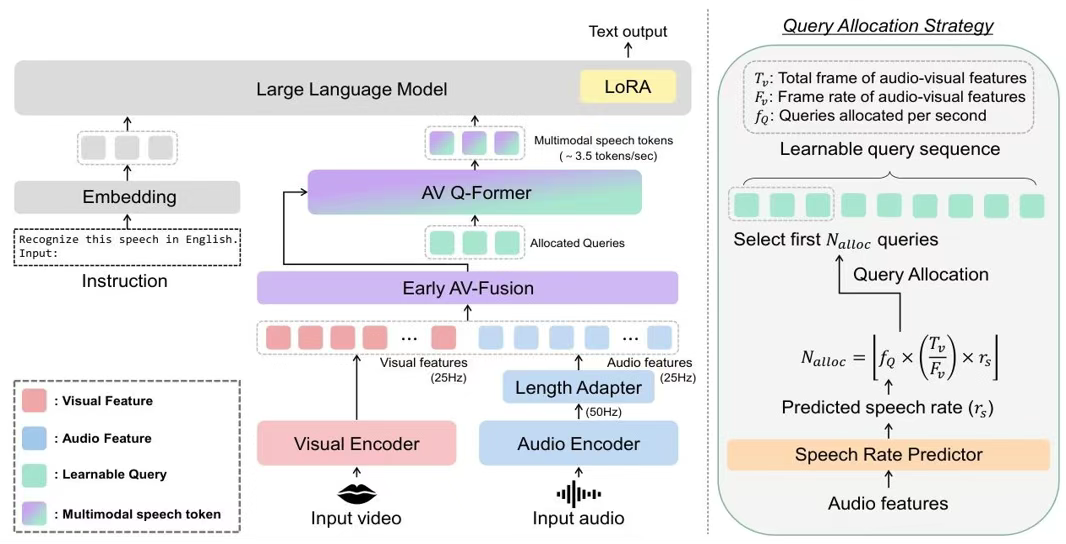
基于 LLM 的 AVSR 需处理高分辨率的视听特征,导致自注意力机制计算量爆炸,为了弥合输入视听语音和输出文本在 Token 数量方面的差距,文章提出了三点创新:
早期融合(Early AV-Fusion):在输入 LLM 前融合音频与视觉特征,直接将序列长度减半;
动态查询分配(AV Q-Former):根据输入时长动态分配 “Query Token”,避免冗余计算;
语速预测器(Speech Rate Predictor):根据说话速度调整 Token 数量,平衡效率与精度。
文章实验表明,MMS-LLaMA 在 LRS3 数据集上的词错误率(WER)相较之前模型实现了最低的 0.72%,FLOPs却低于传统 LLM 模型。
MoHAVE:“专家”控制模型激活
论文标题:MoHAVE: Mixture of Hierarchical Audio-Visual Experts for Robust Speech Recognition
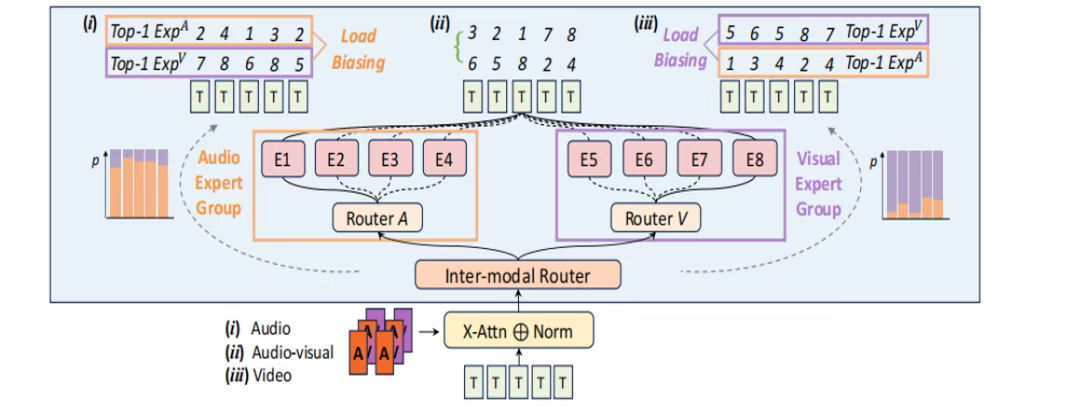
MoHAVE采用稀疏专家混合(MoE)架构,通过 “分层门控” 动态分配计算资源:
层间路由器:根据场景(如高噪声时)调整音频与视觉专家组的权重,优先激活更相关的模态;
层内路由器:在每个专家组中选择最优 “专家模块” 处理输入,避免全模型激活。
文章实验表明,MoHAVE在不产生显著计算成本的情况下,有效降低了AVSR模型的 WER, 相较之前算法取得了最好的改进,证明了算法的可行性。
三、 模态融合突破:VHASR 的 “视觉热词” 新思路
论文标题:VHASR: A Multimodal Speech Recognition System With Vision Hotwords
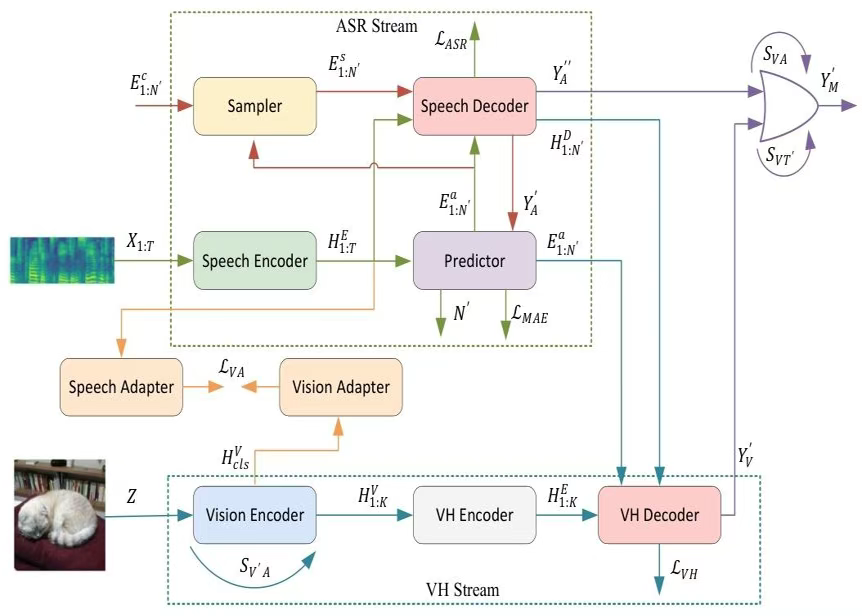
VHASR受 “文本热词” 启发,提出视觉热词流概念,让图像信息精准辅助语音识别:
将图像分割为多个 “视觉热词”(如唇部区域补丁),每个补丁作为独立特征;
计算视觉热词与音频特征的相似度,动态调整权重(如唇部补丁权重升高,背景补丁权重降低;
通过双流架构融合 ASR 结果(ASR Stream)与视觉热词信息(VH Stream),针对性纠正错误。
下图可以看出,使用该算法进行检测时,通过引入视觉热词信息,将识别文本中的"sitting"修正为了“sleeping”。
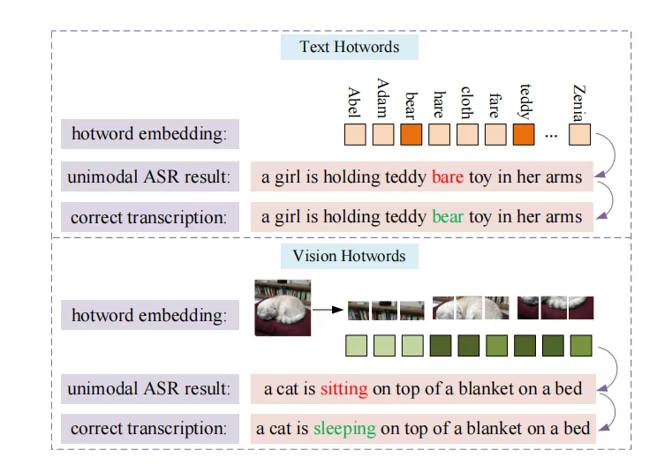
文章实验表明,VHASR 在噪声数据集上相比过往算法实现了最低的WER,证明了将视觉信息作为热词输入这一想法的有效性。
四、数据集建设:ViCocktail 填补非英语空白
论文标题:ViCocktail: Automated Multi-Modal Data Collection forVietnamese Audio-Visual Speech Recognition
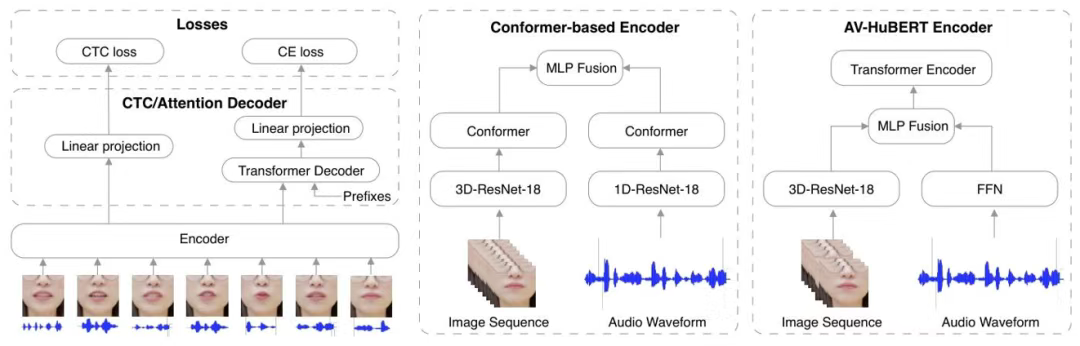
针对越南语等小语种缺乏 AVSR 数据的问题,ViCocktail提出了一种全自动数据处理管道:
视频预处理:用 S3FD 人脸检测器定位说话人,通过 IOU 算法跟踪人脸,确保目标稳定;
音画同步:结合主动说话人检测(ASD)和 SyncNet 技术,消除唇动与音频的延迟;
特征提取:使用Dlib库的人脸检测功能,提取唇部区域(面部关键点 48-67)并归一化,同时用 ASR 生成文本标签(测试集手动校对)。
文章实验表明,通过这个数据集训练之后,模型在噪声环境下的性能超越ASR的basline,证明了数据集的有效性。
五、总结
AVSR 通过 “视听协同” 突破了传统语音识别的局限,正在向更鲁棒、更高效、更多语言的方向迈进。相信未来越来越多的研究会克服AVSR 当前计算成本高,模态融合低效,数据集稀缺等关键问题,让人工智能更接近人类 “听其言、观其行” 的理解能力。
未来,随着多模态大模型的发展和全球数据集的丰富,AVSR 有望在智能客服、视频会议、助听设备等场景中广泛应用,真正实现 “嘈杂世界中的清晰沟通”。
