
 语音小管家
大家好,欢迎来到「AudioCC交我学」专栏!
作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术创新与应用实践的最新动态。我们将用通俗易懂的语言拆解复杂理论,用数据与实验结果验证技术价值,带你快速了解最新、最有趣的学术论文,打破学术与大众之间的壁垒,让你在碎片化的时间里也能 get 到前沿知识!
一、任务介绍
什么是「Separation Task」——让 AI 在“人声鼎沸”里听清每一个声音
声音分离(Separation Task)是指在没有先验信息的情况下,将混合音频中的不同声音成分自动分离出来。设想你身处一场鸡尾酒会:玻璃杯碰撞、爵士乐队、数人同时交谈的声波、以及这些声音经墙壁和室内的物体反射所产生的反射声,在空气中交织成一条混合音轨。声音分离技术的目标就是让机器能够从这些混合的声音中,将每一个独立的声音源分离出来,恢复它们原本干净的波形。
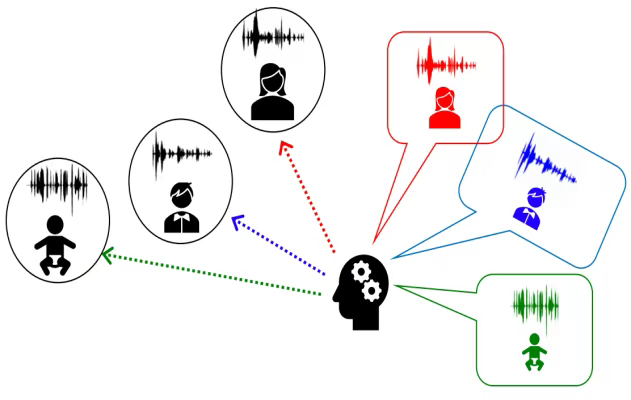
图1.声音分离示意图[1]
什么是「Extraction Task」——在嘈杂中按图索骥,只把你想要的那把声音“拎”出来。
而声音提取(Extraction Task)则是在有先验线索的情况下,从混合音频中提取出特定的声音。同一场鸡尾酒会,人声、爵士、杯盏交错混作一团。现在给你一条文字提示——“请提取那位穿红裙女士的声音”。目标声音提取即利用类别标签、参考音频片段或自然语言描述等先验知识我们称之为线索,从混合信号中精准分离并保留指定声源,时抑制其他干扰声音。
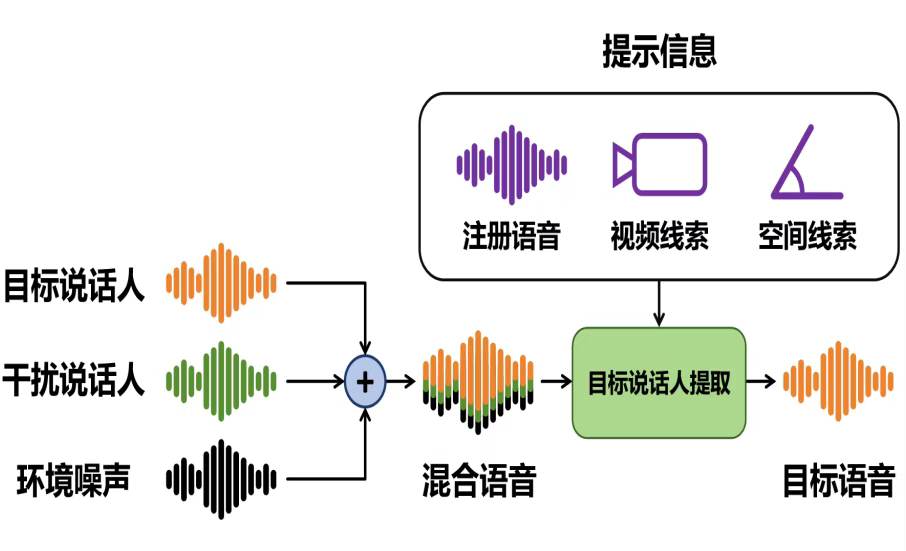
图2.目标声音提取示意图
二、一些挑战
1)分离任务往往需要提前预知混合音频中声源的数量:真实场景中,我们无法预知当前会有几类声音同时出现,因此现有模型往往需要预定义声源的数量。
2)提取任务依赖于高质量的线索来提取目标声音:当线索缺失或者线索质量低下时,执行提取任务提取到的音频质量不佳
3)标签置换问题:混合音频中每个独立单一的成分我们称作源,执行分离任务输出的多个单一音频无法与干净的源一一匹配上。
4)针对通用声音的分离效果不佳:目前的模型往往只能特定场景下的语音/声音分离,无法在通用场景下达到较好的泛化性。
三、评估指标
如何评估声音分离的好坏?评估方法有很多种我们主要介绍以下3种。
第一个是:SNR(信噪比),SNR评估方法通过比较模型输出与真实标签来计算。如图3所示,X^ 为ground truth 声音向量,X*为模型输出声音向量,E为二者之差。那么照这样来看,二者越相似,则SNR数值越大。该方法以真实值的平方为分子,误差的平方为分母,取对数后的结果越大越好。然而,SNR存在局限性:当模型输出与真实值方向平行但幅度不同时,误差可能被高估;若模型仅放大声音的响度以减少误差,即使方向不一致,SNR也可能显示良好性能,这并不合理。
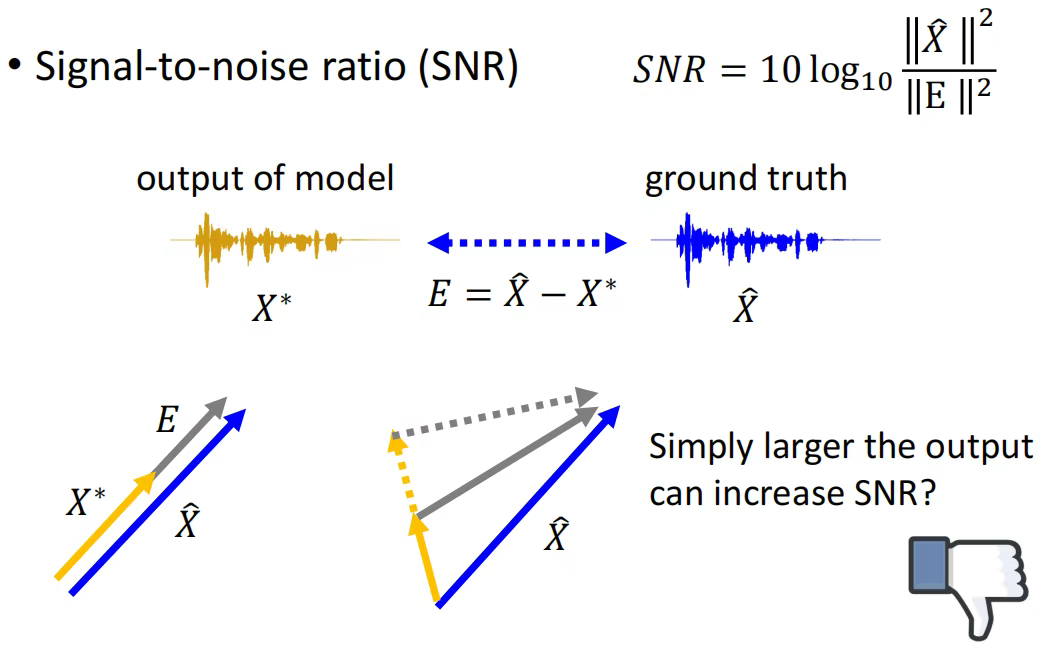
图3.信噪比计算流程[1]
第二个是:SI-SDR(尺度不变信噪比)是一种改进的评估指标,用于解决SNR评估中的问题。它通过计算模型输出X^在真实值X∗上的投影XT,以及在垂直方向的投影XE,来衡量模型。
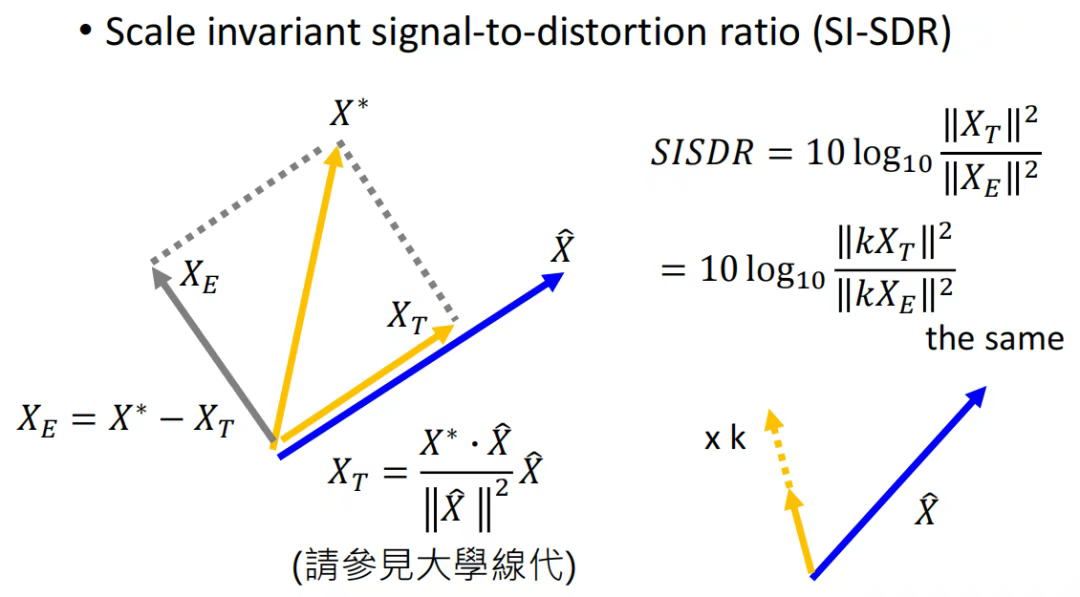
图4.尺度不变信噪比计算流程[1]
第三个是: SI-SDRi(尺度不变信噪比提升),为了防止本来输入的声音信号就接近分离的情况,于是做出了改善,它的计算不同在,它是算分开结果的 SI-SDR 减去 正确输出与未分开结果的 SI-SDR。有可能红色声音部分本来就很小。SI-SDR1 算出来就会很大。所以我们希望看它在分离之后的变化改善,而不是看它的绝对值。
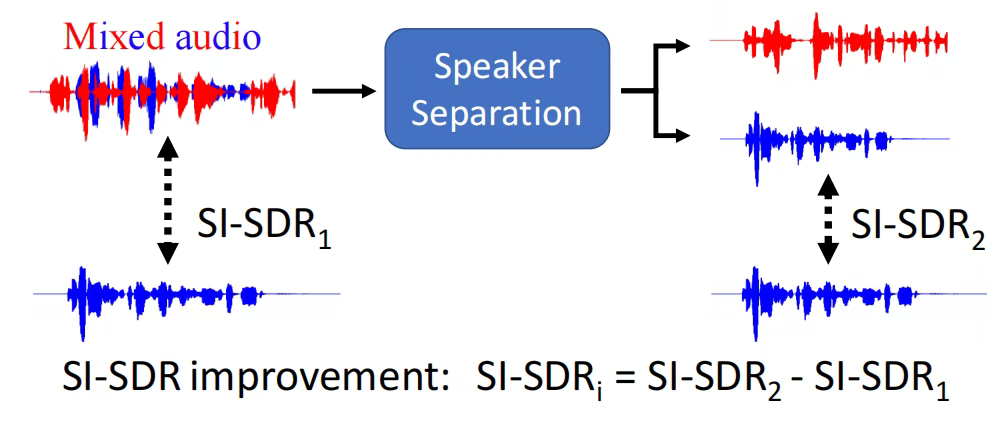
图5.尺度不变信噪比提升计算流程[1]
但是存在一个疑问:分离任务的输出与源信号的对应关系我们是不知道的,那我们在分别执行分离任务与提取任务时,我们应该如何评估输出的多路信号与源信号呢?
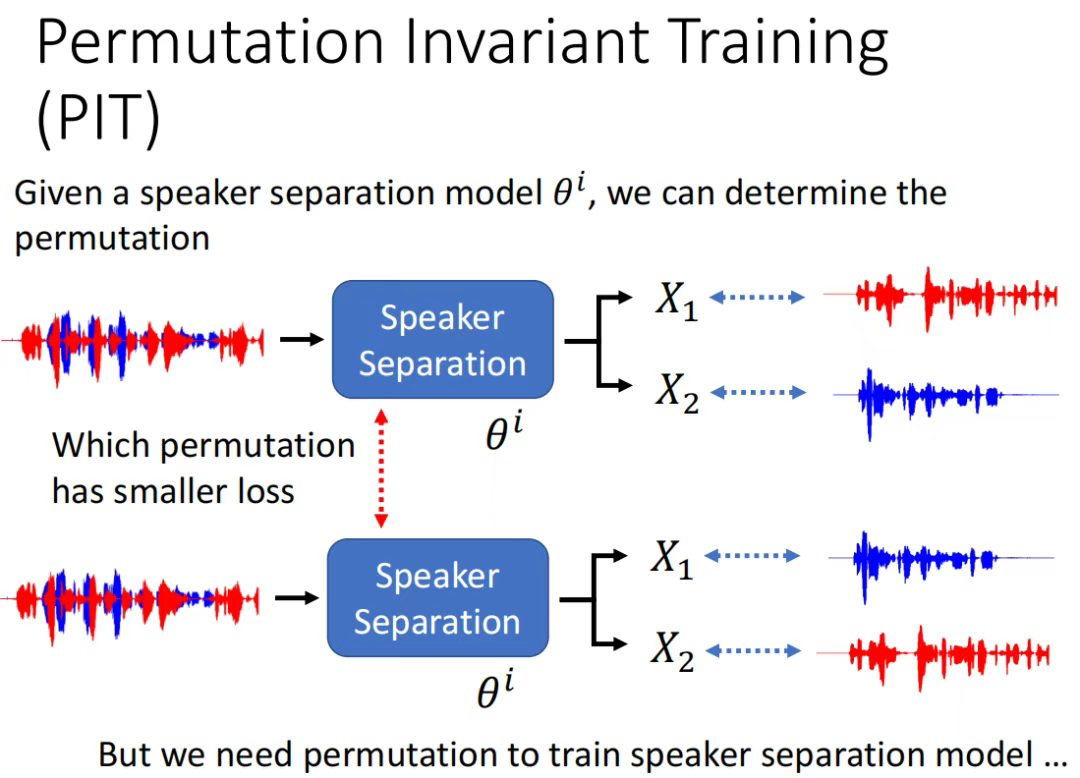
图6.排列不变训练策略[1]
为了解决这个问题,在执行分离任务的时候,我们可以采用排列不变训练(Permutation Invariant Training, PIT)策略。如图6所示,PIT方法通过比较不同排列组合下的损失,来确定最佳的信号对应关系。具体来说,对于给定的混合信号,模型会输出多路分离信号。然后,对于每一种可能的排列组合,计算其对应的损失值。最终选择损失最小的排列作为最优解。
这种方法的优点在于,它不需要预先知道输出信号与源信号之间的对应关系,而是通过数据驱动的方式自动确定。这使得PIT策略在实际应用中更加灵活和鲁棒。然而,PIT方法也存在一些局限性。例如,当源信号数量较多时,可能的排列组合会急剧增加,导致计算量变大。此外,在某些情况下,不同排列组合的损失值可能非常接近,使得模型难以确定唯一的最优解。总的来说,PIT为解决声音分离任务中的信号对应问题提供了一种有效的思路。
而在执行提取任务的时候,由于是根据线索抽取指定的声音,我们往往能提取预知抽取出来的信号与源信号的对应关系,而无需像PIT方法对每一种可能的排列组合,计算其对应的损失值,只需要根据给定的唯一序列直接计算损失。
四、数据集
通用声音分离(Universal Sound Separation)任务中,常用的开源数据集可分为语音主导、通用音频(含非语音)和音乐源分离三大类,汇总如下:
数据集名称 | 类型 | 简介 | 规模/特点 |
WSJ0 | 语音 | 华尔街日报朗读语料,单通道 2-/3-说话人混合标准基准 | 约 80 h 干净朗读 |
LibriMix | 语音 | LibriSpeech+WHAM 噪声合成的 2-/3-说话人混合 | Libri2Mix / Libri3Mix |
VCTK-2Mix | 语音 | VCTK 说话人+WHAM 噪声,两说话人混合 | 110 位说话人,48 kHz |
FUSS | 通用音频 | Google 发布,任意声源混合;基于 FSD50K | 23 k 条混合,最多 4 源,16 kHz |
AudioSet | 通用音频 | Google 发布的跨场景环境/事件/音乐数据集,含 527 类超过 200 万条样本条 10 s 片段 | 单声道,提供平衡子集(Balanced-train)与评估子集,基于 YouTube 来源 |
VGGSound | 通用音频 | Oxford 发布的大规模“视频-音频”对应数据集,含 300+ 类日常声音,音频从 YouTube 片段提取并人工校验 | 约 200 k 条 10 s 片段,48 kHz 单声道,带类别标签 |
MUSDB18 | 音乐 | 150 首完整歌曲及鼓、贝斯、人声、其他4stems | 10 h,44.1 kHz 立体声 |
MIR-1K | 音乐 | 中文流行歌曲 1000 片段,人声/伴奏双通道 | 133 min,4–13 s/片段 |
五、通用声音分离的的一些观点
在早期的Universal sound Separation论文中,首次在语音/非语音分离任务和通用声音分离任务上系统评估了分析-合成变换(STFT/Conv)的组合,并在窗口大小参数上为每种方法进行优化。
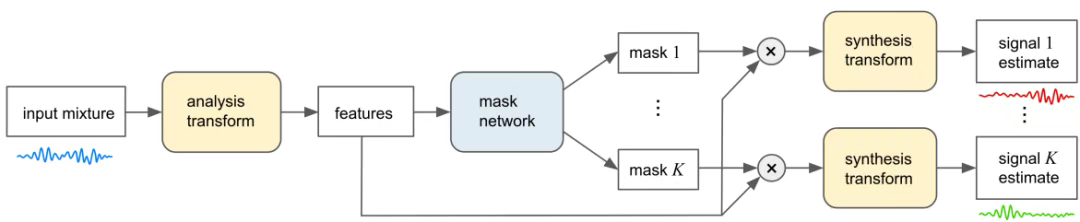
图7.声音分离流程图[2]
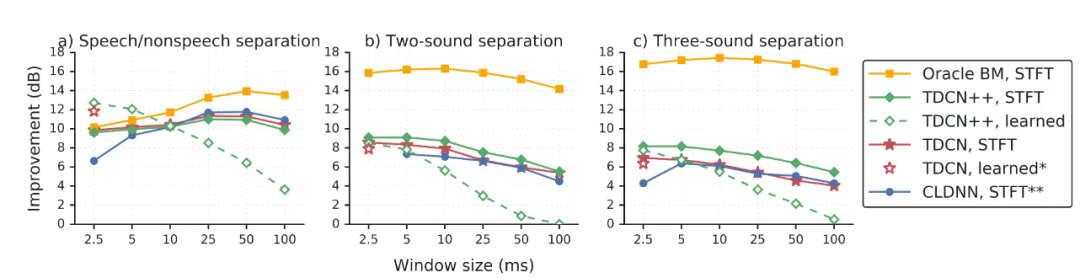
图8.不同类型基和窗口大小对分离性能的影响[2]
对于语音/非语音分离,所有掩蔽网络都更偏好较长的STFT窗口(25-50毫秒是最优窗口长度),而在使用可学习基(Conv)时则以短窗口效果最佳。
对于通用声音分离,无论采用哪种基,最优的窗口长度总体上都比语音/非语音分离要短(2.5 毫秒或 5 毫秒)。
对于语音/非语音分离任务,使用可学习基(Conv)的模型取得了最优性能;而对于通用声音分离任务,STFT 更能提供更好的表示。
六、总结
通用声音的分离与提取,正试图让 AI 在纷繁复杂的声学世界中“听得清、找得准”。从鸡尾酒会式的盲源分离,到凭一条文字或参考音频就能“按图索骥”的声音提取,技术已能初步应对人声、音乐、环境噪声等多源混叠的挑战,但仍面临四大瓶颈:未知声源数量、线索质量不足、标签置换歧义,以及跨场景泛化性有限。评估层面,SNR→SI-SDR→SI-SDRi 的演进凸显了更鲁棒的指标需求,而排列不变训练(PIT)则为“谁对应谁”这一经典难题提供了数据驱动的解法。数据方面,WSJ0/LibriMix 等语音集、FUSS/VGGSound 等通用音频集与 MUSDB18 音乐集共同构成了从“干净朗读”到“真实世界噪声”的多维基准。实验提示:语音任务偏好长窗 Conv 基,通用任务反而需要短窗 STFT,窗口与变换的“因地制宜”成为性能跃迁的新杠杆。未来,随着更丰富的多模态线索、更高效的训练策略及跨域泛化框架的出现,通用声音分离有望让机器在任何声学场景下,都能像人一样“只取所需、不闻其扰”。希望本文对通用声音分离与提取任务感兴趣的读者带来入门帮助。
七、参考
参考:
[1]李宏毅《深度学习与人类语言处理》课程
[2] I. Kavalerov et al., “Universal Sound Separation,” in 2019 IEEE Workshop on Applications of Signal Processing to Audio and Acoustics (WASPAA), Oct. 2019, pp. 175–179.
