IndexTTS 2.5 让声音跨越语言

今天和大家聊聊Bilibili最新发布的 IndexTTS 2.5,支持中/英/日/西/阿五国语言零样本配音,推理速度翻倍升级,跨语言情绪还原更自然,同时也支持原声的语速控制能力,补齐上代模型短板。 这次新版 IndexTTS 2.5 并没…
177 0 0

今天和大家聊聊Bilibili最新发布的 IndexTTS 2.5,支持中/英/日/西/阿五国语言零样本配音,推理速度翻倍升级,跨语言情绪还原更自然,同时也支持原声的语速控制能力,补齐上代模型短板。 这次新版 IndexTTS 2.5 并没…
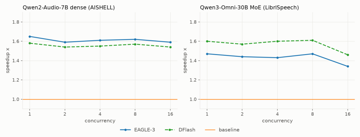
投机解码(Speculative Decoding)可以在不改变模型输出的前提下加速自回归解码。本文介绍我们在 ASR 和 TTS 两类语音任务上的投机解码实践:ASR方向,Qwen2-Audio-7B和 Qwen3-Omni-30B 使用…
多语言语音识别在向低资源语言扩展时,通常需要按顺序适配多种新语言,如何在学习新语言的同时不损害已有语言的性能至关重要。近期,清华大学语音与音频技术实验室(SATLab)提出了一种融合语言均衡梯度投影与经验回放的统一持续学习方法(UGP),利…
今日论文合集:CS.SD语音与音频 | 共 4 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Alignment Drift i…
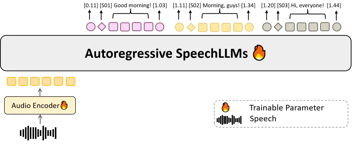
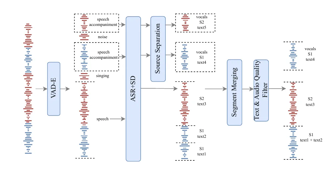
MOSS 开源 MOSS-Transcribe-Diarize-0.9B。这是一个专为真实复杂语音场景打造的端到端多说话人语音转录模型。它不需要像传统方案一样,将 ASR、Speaker Diarization、Alignment 拆成多个…
传统的自动语音识别系统主要遵循"单次通行(Single-pass)"的转录范式,将识别过程视为从音频到文字的开环映射任务。这种范式在交互逻辑上缺乏"反馈-修复"机制,在评价维度上无法区分关键语义错误与无关紧要的字面偏差。本文解读的论文 To…
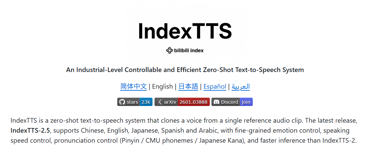
IndexSpeech 团队正式开源 IndexTTS-2.5,针对 IndexTTS-2 的多语言、情绪表现和推理效率进行优化。新版本支持中文、英语、日语、西班牙语和阿拉伯语,并保留跨语种与音色情感解耦能力,同时新增语速控制和更细粒度的发…
今日论文合集:CS.SD语音与音频 | 共 9 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. CookVoice: Unifie…
今日论文合集:CS.SD语音与音频 | 共 10 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Whisper-Aware LL…
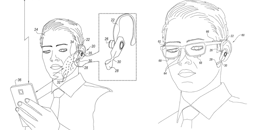
地铁里、会议室中、医院病房内——很多场合我们都需要“说点什么”,却又不便发出声音。 苹果公司近日公开了一项专利申请(WO2026159706A1),提出一种默声语音检测方案:用户在不发声的情况下靠面部肌肉运动“默念”,设备读取面颊皮肤微动后…
