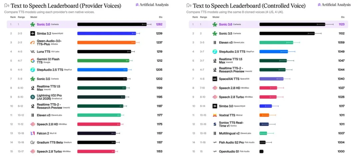
Cartesia 发布 TTS 模型 Sonic-3.6:支持 44 种语言,重点提升跨语言翻译与语音自然度

来源丨RTE开发者社区、Data接化发 Cartesia 发布 Sonic-3.6 TTS 模型,重点提升 44 种语言下的语音自然度,并称这是其目前最逼真的 TTS 版本。 相比三个月前发布的 Sonic-3.5,新版本根据开发团队反馈进…
265 0 0

来源丨RTE开发者社区、Data接化发 Cartesia 发布 Sonic-3.6 TTS 模型,重点提升 44 种语言下的语音自然度,并称这是其目前最逼真的 TTS 版本。 相比三个月前发布的 Sonic-3.5,新版本根据开发团队反馈进…
今日论文合集:CS.SD语音与音频 | 共 6 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. A Multiplication-…
小红书 FireRedTeam 开源多语言 TTS 模型 FireRedTTS3,基于语义增强的连续语音表示进行语音生成。模型包含 Base 和 Instruct 两个版本:Base 支持 24 种语言、21 种中文方言的 Zero-sho…

今日论文合集:CS.SD语音与音频 | 共 11 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Adding Voice Clo…

近年来,大规模语音识别模型在普通话识别上取得了显著进展,但中文方言识别仍然面临数据稀缺、地域差异大、声学与词汇分布复杂等挑战。一个常见做法是在预训练 ASR 模型上继续使用方言数据进行微调,虽然能够有效提升方言识别性能,却往往会导致模型原有…

今天和大家聊聊Bilibili最新发布的 IndexTTS 2.5,支持中/英/日/西/阿五国语言零样本配音,推理速度翻倍升级,跨语言情绪还原更自然,同时也支持原声的语速控制能力,补齐上代模型短板。 这次新版 IndexTTS 2.5 并没…

投机解码(Speculative Decoding)可以在不改变模型输出的前提下加速自回归解码。本文介绍我们在 ASR 和 TTS 两类语音任务上的投机解码实践:ASR方向,Qwen2-Audio-7B和 Qwen3-Omni-30B 使用…

多语言语音识别在向低资源语言扩展时,通常需要按顺序适配多种新语言,如何在学习新语言的同时不损害已有语言的性能至关重要。近期,清华大学语音与音频技术实验室(SATLab)提出了一种融合语言均衡梯度投影与经验回放的统一持续学习方法(UGP),利…

今日论文合集:CS.SD语音与音频 | 共 4 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Alignment Drift i…

MOSS 开源 MOSS-Transcribe-Diarize-0.9B。这是一个专为真实复杂语音场景打造的端到端多说话人语音转录模型。它不需要像传统方案一样,将 ASR、Speaker Diarization、Alignment 拆成多个…
