
声浪

语音人的新赛道:脑机接口中的"语音解码"大有可为!

语音小伙伴们看过来,今天给大家介绍个新赛道! 你是否想过,大脑处理语音信号的过程与我们熟悉的语音识别系统有着惊人的相似性? 从时序信号处理到特征提取,从编码解码到多模态融合,脑机接口与语音技术在底层逻辑上竟然如此相通! 今天让我们一起探索这…
17 0 0
ElevenLabs 升级AI 文生音效模型,具有更长的剪辑和更好的音频质量
来源丨AI音频时代 AI语音技术公司ElevenLabs正式宣布将其AI文生音效模型升级至版本2。此次更新在音效生成的时长、质量与可控性三大维度实现跨越式提升,标志着AI音频创作正式迈入“专业可用”阶段。 特点说明 1、即时生成 几秒钟内开…
16 0 0
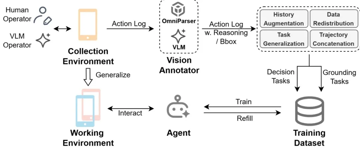
人人都能炼专属Agent,上海交大开源端侧Agent全栈工具链,真实场景性能超GPT-5!
手机AI助手能自动帮你订外卖、酒店和网购,正逐渐成为新趋势。这种能处理日常任务的智能助手,已从科幻走向现实。但实现真正“解放双手”仍面临挑战:如何高效训练并在手机端部署AI模型,此前似乎只有少数大公司能解决。从获取高质量数据、模型训练适配,…
15 0 0
CosyVoice TTS 3.0版本,让声音也能有情绪
CosyVoice 系列一直是 TTS 领域备受瞩目的标杆之作。从 CosyVoice 1 到如今的 CosyVoice 3,它不仅逐步实现了当前 TTS 技术的主流功能,更在技术架构上实现了全面覆盖与深度优化。近日,CosyVoice 3…
18 0 0
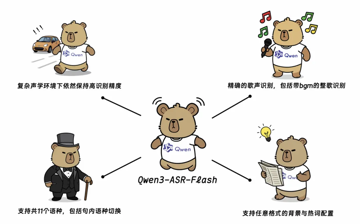
听得清,识得准,语音识别模型Qwen3-ASR-Flash来了!
今天,我们正式推出通义千问系列最新的语音识别模型 Qwen3-ASR-Flash,它基于Qwen3基座模型,经海量多模态数据以及千万⼩时规模的ASR(自动语音识别)数据训练构建而成。 Qwen3-ASR-Flash实现了⾼精度⾼鲁棒性的语⾳…
15 0 0
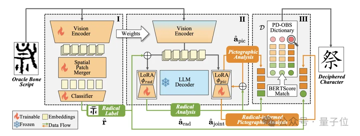
大模型破译甲骨文创下新SOTA!复旦团队推出新框架
来源丨量子位 让大模型破译从未见过的甲骨文,准确率拿下新SOTA! 自复旦大学的研究人员提出了一种基于部首和象形分析的可解释甲骨文破译框架—— 不仅在公开基准数据集HUST-OBC和EV-OBC上,达到最先进的Top-10识别准确率以及优异…
14 0 0