论文推介:Spatial-DCCRN—基于帧级角度特征和混合滤波器的多通道语音增强模型

近年来基于深度学习的语音前端处理及语音识别已经获得了长足的发展,然而对于包括噪声、说话人重叠、混响等多种影响因素在内的真实复杂声学场景,未经处理的语音的人耳主观听感与语音识别准确率都会明显下降。长期以来,基于多通道信号处理的前端语音增强是提…
90 0 0

近年来基于深度学习的语音前端处理及语音识别已经获得了长足的发展,然而对于包括噪声、说话人重叠、混响等多种影响因素在内的真实复杂声学场景,未经处理的语音的人耳主观听感与语音识别准确率都会明显下降。长期以来,基于多通道信号处理的前端语音增强是提…
文章来源于音频语音与语言处理研究组,作者琚雨恺 实时通信 (RTC) 在我们的日常生活中变得不可或缺,诸如腾讯会议在内的语音RTC应用已经成为我们日常使用的高频在线交流工具。然而,在通话过程中语音质量往往受到背景噪声、混响、无关说话人等干扰…
今日论文合集:cs.SD语音11篇,eess.AS音频处理11篇。 cs.SD语音 【1】 Massively Multilingual ASR on 70 Languages: Tokenization, Architecture, an…
我们在 2021 全国声学大会的报告中,探讨了新一代语音识别技术的若干新特点,特别是数据高效、自动机器学习以及可信赖。本文是我们面向数据高效语音识别的新工作,介绍清华大学语音处理与机器智能实验室(Speech Processing and…
cs.SD语音 【1】 A Multimodal Approach for Dementia Detection from Spontaneous Speech with Tensor Fusion Layer 标题:一种基于张量融合的多模…
今日论文合集:cs.SD语音13篇,eess.AS音频处理14篇。 cs.SD语音 【1】 Efficient Speech Translation with Pre-trained Models 标题:基于预训练模型的高效语音翻译 链接:…
Wenet 社区正式发布 wespeaker, 面向研究和产品的说话人表征学习框架,wespeaker 具有高质量,轻量级,面向产品,支持工业级数据训练,在线数据增强等诸多优点,欢迎大家体验、贡献。目前该工作已投稿ICASSP 2023,…
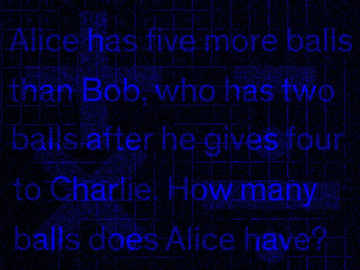
AI 到底擅不擅长数学,还得具体问题具体分析。 如果问计算机擅长什么,在所有的答案里,数学必须榜上有名。在经历了漫长的研究之后,顶尖学者们在研究计算机关于数学计算方面的发展,取得了令人惊讶的成绩。 就拿去年来说,来自加州大学伯克利分校、Op…
今日论文合集:cs.SD语音24篇,eess.AS音频处理23篇。 cs.SD语音 【1】 Egocentric Audio-Visual Noise Suppression 标题:以自我为中心的视听噪声抑制 链接:https://arxi…
11月3日,2022云栖大会杭州现场,阿里达摩院联手CCF开源发展委员会共同推出AI模型社区“魔搭”ModelScope,旨在降低AI的应用门槛。达摩院率先向魔搭社区贡献300多个经过验证的优质AI模型,超过1/3为中文模型,全面开源开放,…