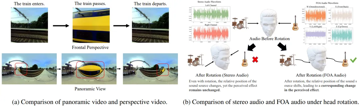
ICML 2025丨360° 视频到空间音频:OmniAudio 如何重新定义沉浸式体验?

当置身于一场音乐会,闭上眼睛,我们仍能凭借声音判断乐器的位置;在电影院,环绕音效让我们仿佛置身于电影场景之中。空间音频,作为一种能够模拟真实听觉环境的技术,正逐渐成为提升沉浸式体验的关键。然而,现有的技术大多基于固定的视角视频,缺乏对 36…
24 0 0

当置身于一场音乐会,闭上眼睛,我们仍能凭借声音判断乐器的位置;在电影院,环绕音效让我们仿佛置身于电影场景之中。空间音频,作为一种能够模拟真实听觉环境的技术,正逐渐成为提升沉浸式体验的关键。然而,现有的技术大多基于固定的视角视频,缺乏对 36…
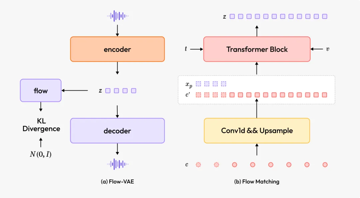
最近,TTS 模型又有重磅“上新”,Speech-02语音模型一出手,就将 OpenAI、ElevenLabs 甩在了后面,登顶 Arena 榜单,成为全球第一。 性能更强之外,Speech-02 还极具性价比,成本仅为 ElevenLab…
来源丨机器之心 近日,腾讯混元与上海 AI Lab、复旦大学、上海创智学院联合提出全新研究工作 UnifiedReward-Think,构建出首个具备长链式推理能力的统一多模态奖励模型,首次让奖励模型在各视觉任务上真正 “学会思考”,实现对…
为促进最新研究成果的传播与交流,CCF语音对话与听觉专委在专委会微信公众号启动论文导读栏目,定期分享最新语音、对话与听觉相关研究方向论文。本期分享七篇发表在ICASSP2025上的文章。本导读论文栏目持续征稿中,欢迎踊跃投稿,投稿方式请参见…
阿尔兹海默病(Alzheimer'sDisease,AD)是一种以认知能力下降和记忆丧失为特征的渐进性神经退行性疾病,及早发现对于其干预和治疗至关重要。近期,清华大学语音与音频技术实验室(SATLab)提出了一种将停顿信息进行编码,并与语言…
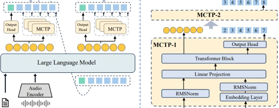
VITA 团队最新推出了突破性成果—VITA-Audio。作为一款端到端的语音模型,VITA-Audio 能在第一次前向传播中直接生成可解码的 Audio Token Chunk,大幅提升响应速度。 在 7B 参数规模下,VITA-Audi…
