
网易有道开源 14 语种零样本TTS:无需参考文本+跨语种无口音 +情感迁移+附子曰 4 整套生态

以下文章来源于一杯阔乐聊ai,以下文章来源于一杯阔乐聊ai 01、资源导航 项目主页:https://github.com/netease-youdao/Confucius4-TTS 在线 Demo:https://confucius4-t…
38 0 0

以下文章来源于一杯阔乐聊ai,以下文章来源于一杯阔乐聊ai 01、资源导航 项目主页:https://github.com/netease-youdao/Confucius4-TTS 在线 Demo:https://confucius4-t…


AudioCC交我学 作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术创新与应用实践的最新动态。…
以下内容来源:AIMS AI LAB 近日,AIMS AI Lab 共有16 篇论文被国际语音技术领域旗舰会议 Interspeech 2026 接收,覆盖多个前沿方向,包括语音大模型推理和后训练、情感计算、低资源语言、语音应用以及神经元群…

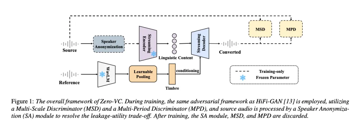
实时语音转换(Streaming Voice Conversion, VC)是虚拟人、实时变声、隐私通话等应用的核心技术。它的目标很明确:在极低延迟下,将源说话人的音色转换为目标说话人,同时保留内容和韵律。 然而,现有的流式零样本 VC 方…


当视觉信息丢失、模糊或被遮挡,模型 还能否精准地从嘈杂人声中提取出目标说话人的声音?本文提出的MeMo 框架,借鉴人类大脑的「注意力动量」机制,让模型像人一样——只要看一眼,就能持续聚焦。 在视觉受损场景下,MeMo 取得了约27% 的相对…

