Interspeech 2026丨智能语音信息处理团队14篇录用论文分享

来源丨语音及语言信息处理国家工程研究中心 本期分享 语音及语言信息处理国家工程研究中心智能语音信息处理团队被 Interspeech 2026接收的14篇论文,论文方向涵盖语音编码、语音合成、语音识别、语音匿名化、声音事件检测等。 1、An…
26 0 0

来源丨语音及语言信息处理国家工程研究中心 本期分享 语音及语言信息处理国家工程研究中心智能语音信息处理团队被 Interspeech 2026接收的14篇论文,论文方向涵盖语音编码、语音合成、语音识别、语音匿名化、声音事件检测等。 1、An…
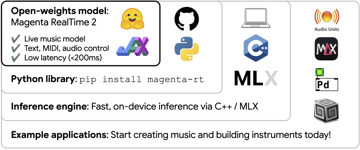
Google Magenta 团队发布并开源了Magenta RealTime 2(MRT2),一个 24 亿参数的实时音乐模型——你可以像演奏乐器一样使用它,并直接在 MacBook(Apple Silicon)本地运行。与"把提示词离线…
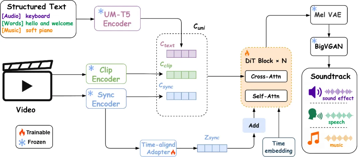
以下文章来源丨NJU语音实验室 南京大学与Video Rebirth 等单位联合提出并开源 Foley-Omni。区别于仅同时支持多种单任务的通用生成模型,Foley-Omni 进一步面向完整视频音轨生成,在统一框架中联合建模语音、音效与音…
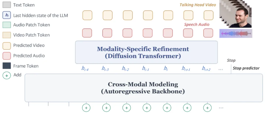
近日,HKUST Audio 团队推出新一代联合音视频生成模型 Talker-T2AV。该模型面向talking head 场景,将传统 TTS 从单一语音生成进一步拓展到 文本到音频+视频联合生成,能够同时生成自然语音与同步的人脸运动,为…
本期分享中国科学技术大学语音及语言信息处理国家工程研究中心研究团队近期发表在IEEE Transactions on Audio, Speech and Language Processing期刊上的2篇关于超低码率语音编解码器的研究。 0…
近日,Soul AI Lab与西北工业大学音频语音与语言处理研究组、Moonstep AI,开源了端到端多人对话转录模型SoulX-Transcriber。 作为一款面向长音频、多说话人场景设计的语音理解模型,SoulX-Transcrib…
