声浪


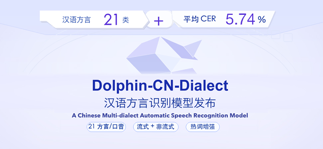
Dolphin-CN-Dialect 发布:同样的数据,换一种配方,让ASR听懂更多中国话
今天,海天瑞声与清华大学电子工程系语音与音频技术实验室(SATLab),发布Dolphin-CN-Dialect 汉语多方言语音识别模型! 获取渠道 体验地址 · 非流式识别:
56 0 0
第三届CCF语音对话与听觉处理前沿进展研讨会技术报告(RASDAP2026 Technical Report)
当前语音对话与听觉处理领域蓬勃发展,学术界与工业界不断涌现创新的技术与产品,为了更好地推动经验交流与前瞻研讨,由中国计算机学会(CCF)语音对话与听觉专委会发起的第三届CCF语音对话与听觉处理前沿进展研讨会(RASDAP2026,Recen…
25 1 0
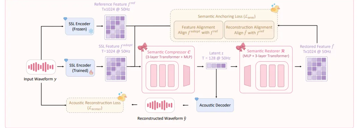
WavCube:一个 128 维连续表征,同时搞定语音理解、重建与生成
以下文章来源丨模型之声 标题:《WavCube: Unifying Speech Representation for Understanding and Generation via Semantic-Acoustic Joint Mod…
30 0 0
语音输入喊了这么多年,千问电脑版一出手就把键盘卷没了?
来源|机器之心 AI 正在悄悄改变人与电脑的交互方式,而下一个被重塑的,可能就是每天发生几百次的「输入」这个动作。 语音输入并非新概念。从早期的 Siri、Google Assistant,到近几年 Whisper、Otter.ai 等工具…
24 0 0