百度王海峰署名:MoE-Adapter解决大模型音频异质处理难题,兼顾性能与算力效率

标题:MoE Adapter for Large Audio Language Models: Sparsity, Disentanglement, and Gradient-Conflict-Free 链接:https://arxiv.o…
21 0 0

标题:MoE Adapter for Large Audio Language Models: Sparsity, Disentanglement, and Gradient-Conflict-Free 链接:https://arxiv.o…
白铂 博士,华为 2012 实验室理论研究部主任 信息论首席科学家 引 言 本篇是《大模型的第一性原理》系列解读文章的第二篇(点击回顾第一篇),我们将从信号处理的角度解读原论文[1]。重点探讨语义向量化背后的信号处理和信息论原理,并从时间序…
来源丨PaperWeekly 无需重新训练,只要抑制 0.1% 的特定神经元,就能让模型“闭嘴”? 近年来,大语言模型(LLMs)在问答、推理与生成任务中展现出卓越能力,但其幻觉(Hallucination)问题仍然是制约实际应用的核心挑战…
GLM-4.7上线并开源。新版本面向Coding场景强化了编码能力、长程任务规划与工具协同,并在多项主流公开基准测试中取得开源模型中的领先表现。 目前,GLM-4.7已通过BigModel.cn提供API,并在z.ai全栈开发模式中上线Sk…
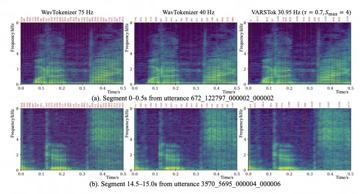
如何将一段连续的、信息密度不均的波形,变成一串 AI 能够理解和处理的“密码”?关键在于语音分词器——它就像是 AI 的“语音耳朵”,负责将声音信号转换成离散的符号序列。 然而,现有的语音分词器大多采用固定帧率,比如每秒生成 75 个 to…
AI视频生成这一年来太卷了。从OpenAI的Sora、Kuaishou的可灵、到字节的即梦,我们几乎每隔一段时间就能看到一款“要革影视行业命”的视频模型问世。而这一次,轮到「美团」出手。 美团团队刚刚在 GitHub 上开源了一款名为Lon…
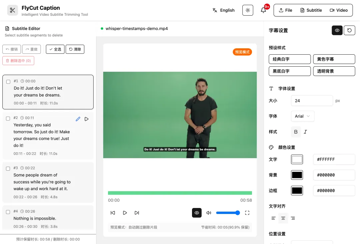
分享一款非常实用、创意十足的开源AI视频字幕编辑工具 — FlyCut Caption。 它不是那种复杂到需要剪辑经验的视频编辑器,而是一款基于 AI 的智能字幕编辑工具,能让你通过“改字幕”来“剪视频”。 也就是它不仅能智能生成字幕,还支…
来源丨机器之心 单 GPU 级世界模型来了。斯坦福大学教授李飞飞创业公司 World Labs 又推出了新成果! 上个月,World Labs 发布了空间智能模型 Marble,「只需一张图片,就能生成持久存在的 3D 世界,比以往更宏大、…
在自然人机交互中,实现如同人类般“边听边说”的全双工语音对话(Full-duplex Spoken Dialogue)一直是语音交互系统的终极目标。与传统的半双工系统不同,全双工系统要求模型能够在用户发言过程中,实时判断是否需要继续倾听、生…
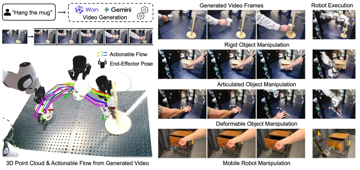
来源丨机器之心 本文共同第一作者为李鸿宇(布朗大学博士生)和孙凌峰(Robotics and AI Institute 研究员,博士毕业于加州大学伯克利分校)。通讯作者付佳慧在 Robotics and AI Institute 任研究员,…