声浪

IEEE TASLP | FPO: 细粒度偏好优化提升零样本TTS鲁棒性

近年来,基于大语言模型(LLM)的零样本文本转语音(Zero-shot TTS)系统发展迅速,已经能够在仅提供几秒参考音频的情况下,合成自然、清晰、且具有说话人风格的语音。然而,即便是最先进的系统,在真实使用场景中仍然频繁出现一些“局部灾难…
10 0 0
属于语音合成(TTS)的年终总结
写在前面 回复整个2025年的TTS发展,可以看到一个非常明显的趋势就是:大模型正在重新构建语音合成的范式。遥想2023年年初,我还在思考如何基于fastspeech的框架来打磨各个module的细节来提升表现力,训练数据最多也就在数百小时…
27 0 0
港大联合字节跳动提出JoVA: 一种基于联合自注意力的视频-音频联合生成模型
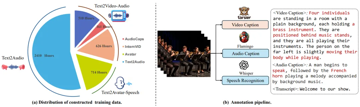
近日,来自香港大学和字节跳动的研究团队提出了一种简单有效的框架 ——JoVA,它支持视频和音频的 Token 在一个 Transformer 的注意力模块中直接进行跨模态交互。为了解决人物说话时的 “口型 - 语音同步” 问题,JoVA 引…
17 0 0
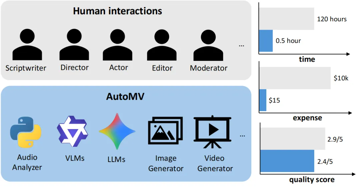
告别“音画割裂”与“人物崩坏”!AutoMV:首个听懂歌词、卡准节拍的开源全曲级MV生成Agent
来源 | 量子位 现有的AI视频生成模型虽然在短片上效果惊人,但面对一首完整的歌曲时往往束手无策——画面不连贯、人物换脸、甚至完全不理会歌词含义。 近日,来自M-A-P、北京邮电大学、南京大学NJU-LINK实验室等机构的研究者们提出了Au…
19 0 0