属于语音合成(TTS)的年终总结

写在前面 回复整个2025年的TTS发展,可以看到一个非常明显的趋势就是:大模型正在重新构建语音合成的范式。遥想2023年年初,我还在思考如何基于fastspeech的框架来打磨各个module的细节来提升表现力,训练数据最多也就在数百小时…
29 0 0

写在前面 回复整个2025年的TTS发展,可以看到一个非常明显的趋势就是:大模型正在重新构建语音合成的范式。遥想2023年年初,我还在思考如何基于fastspeech的框架来打磨各个module的细节来提升表现力,训练数据最多也就在数百小时…
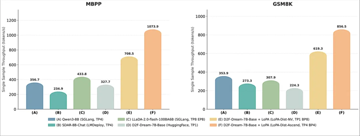
在大语言模型(LLMs)领域,扩散大语言模型(dLLMs)因其并行预测特性,理论上具备超越传统自回归(AR)模型的推理速度潜力。然而在实践中,受限于现有的解码策略,dLLMs 的单步生成往往局限于 1-3 个 Token,难以真正释放其并行…
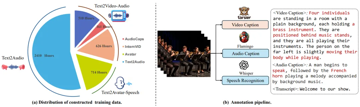
近日,来自香港大学和字节跳动的研究团队提出了一种简单有效的框架 ——JoVA,它支持视频和音频的 Token 在一个 Transformer 的注意力模块中直接进行跨模态交互。为了解决人物说话时的 “口型 - 语音同步” 问题,JoVA 引…
机器之心编辑部 今天,Meta 完成了一项大收购,将智能体初创公司 Manus 收入麾下。 目前,双方交易的具体细节(包括具体收购金额等)尚未公布。 自今年 3 月推出全球首款通用 Agent 以来,Manus 迅速走红,成为人工智能领域的…
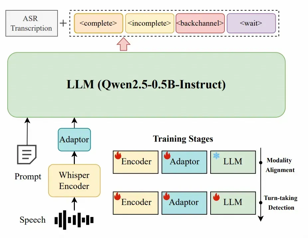
从2022年优化智能客服开始,我就开始尝试优化人机语音对话中的“语义完整度”模块。当时大部分人的精力都集中在优化识别率,在语音对话系统中,这不是一个核心模块,似乎是可有可无的,但语义上的完整度对于用户体验、信息收集的效率都有很大的影响。特别…
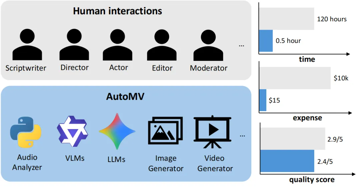
来源 | 量子位 现有的AI视频生成模型虽然在短片上效果惊人,但面对一首完整的歌曲时往往束手无策——画面不连贯、人物换脸、甚至完全不理会歌词含义。 近日,来自M-A-P、北京邮电大学、南京大学NJU-LINK实验室等机构的研究者们提出了Au…
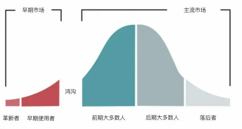
最近一些朋友,包括从事投资方向的朋友,看到我的笔记和文章后,会找我聊语音相关的技术和现状,以及对当前一些技术和应用的看法。今天想分享一下,在我看来,大模型的AI时代,未来在智能语音方向,我只看好两个方向:语音理解和被动语音记录。 基础技术上…
来源丨PaperWeekly 无需重新训练,只要抑制 0.1% 的特定神经元,就能让模型“闭嘴”? 近年来,大语言模型(LLMs)在问答、推理与生成任务中展现出卓越能力,但其幻觉(Hallucination)问题仍然是制约实际应用的核心挑战…
