Soul App与西工大、上交大开源语音合成模型 SoulX-Podcast,登顶HuggingFace TTS趋势榜!

近日,Soul App AI团队(Soul AI Lab)与西北工业大学ASLP@NPU团队和上海交通大学X-LANCE Lab正式开源语音播客生成模型SoulX-Podcast。该模型是一款专为多人、多轮对话场景打造的语音生成模型,支持中…
22 0 0

近日,Soul App AI团队(Soul AI Lab)与西北工业大学ASLP@NPU团队和上海交通大学X-LANCE Lab正式开源语音播客生成模型SoulX-Podcast。该模型是一款专为多人、多轮对话场景打造的语音生成模型,支持中…
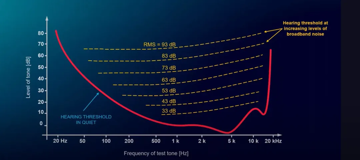
⏩什么是掩蔽效应? 人们在安静环境中听一个声音,即使这个声音的声压级很低也可以听到,说明人耳对这个声音的听阈可以很低。但是,在倾听一个声音的同时,如果存在另一个声音(掩蔽声),就会影响到人耳对所听声音的听闻效果,这时对所听声音的听阈就要提高…
音乐结构分析(MSA)作为能够识别音乐作品中具有功能性意义的段落(如前奏、主歌、副歌)并精准检测其边界的关键技术,正在成为音乐理解和可控音乐生成的重要基础。然而,现有的MSA方法通常会因训练数据的限制、标注不一致、依赖复杂预处理流程等原因而…
近年来,单步扩散模型因其出色的生成性能和极高的推理效率,在图像生成、文本到视频、图像编辑等领域大放异彩。目前主流的训练方法是通过知识蒸馏,最小化学生模型与教师扩散模型之间的分布差异。然而,现有的方法主要集中在两条平行的理论技术路线上: 基于…
近年来,语音技术一度被推上风口,不少企业纷纷投入资源自研相关能力。然而从实际应用和商业回报来看,语音为产品带来的真实收益,往往远低于管理者最初的预期。如果用一句话总结原因,那就是: 语音为产品带来的收益,远低于决策者在办公室里的预期! 详细…
AI视频生成这一年来太卷了。从OpenAI的Sora、Kuaishou的可灵、到字节的即梦,我们几乎每隔一段时间就能看到一款“要革影视行业命”的视频模型问世。而这一次,轮到「美团」出手。 美团团队刚刚在 GitHub 上开源了一款名为Lon…
