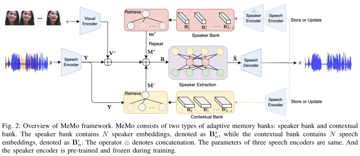
看一眼就够了!MeMo:让 模型 在「看不见」时,依然能「听得准」

当视觉信息丢失、模糊或被遮挡,模型 还能否精准地从嘈杂人声中提取出目标说话人的声音?本文提出的MeMo 框架,借鉴人类大脑的「注意力动量」机制,让模型像人一样——只要看一眼,就能持续聚焦。 在视觉受损场景下,MeMo 取得了约27% 的相对…
23 0 0

当视觉信息丢失、模糊或被遮挡,模型 还能否精准地从嘈杂人声中提取出目标说话人的声音?本文提出的MeMo 框架,借鉴人类大脑的「注意力动量」机制,让模型像人一样——只要看一眼,就能持续聚焦。 在视觉受损场景下,MeMo 取得了约27% 的相对…
近日,Interspeech 2026 公布了论文录用结果,上海交通大学跨媒体语言智能实验室共7篇论文被会议接收。Interspeech 是由国际语音通信协会(ISCA)组织的语音研究领域的顶级会议之一,是全球最大的综合性语音信号处理领域的…
近日,第 64 届国际计算语言学年会(Annual Meeting of the Association for Computational Linguistics,ACL)公布了论文录用结果,上海交通大学跨媒体语言智能实验室共5篇论文被会…
近日,Cartesia 发布 Sonic-3.5 与 Ink-2 语音模型:基于状态空间模型,首音延迟降至 82ms 并集成原生轮次检测。 Cartesia 推出新一代实时语音端到端模型 Sonic-3.5 与 Ink-2。该系列模型基于状…
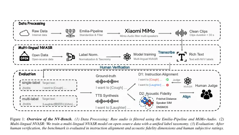
现在的语音合成(TTS)越来越像真人了,但总觉得少了点“人味儿”。 为什么?因为真人说话不仅仅是念文字,还充满了非语言发声(Nonverbal Vocalizations, NVs): 生理反应:咳嗽(Cough)、叹气(Sigh)、呼吸声…
本期分享西工大音频语音与语言处理研究组(ASLP@NPU)被 Interspeech 2026接收的11篇论文,以下是发表论文的相关信息。 01、OmniCodec: Low Frame Rate Universal Audio Codec…
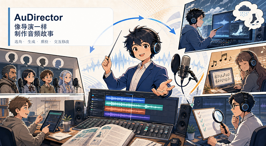
一个面向沉浸式音频故事创作的自反思闭环多智能体框架。 录取信息:Accepted to Interspeech 2026 论文题目:AuDirector: A Self-Reflective Closed-Loop Framework fo…
