
VoxMem:音频大模型能跨会话记住说话人、语气和环境声吗?

语音助手正在从“一问一答”走向跨越多次会话的长期交互。用户上周提过的计划、某位家庭成员说过的话、某次对话时的语气,都可能在之后被问起。但语音里的信息远不止文字:谁说的、怎么说的、背景里有什么声音,都只存在于音频信号里,一旦转成文字就丢失了。…
385 0 0


语音助手正在从“一问一答”走向跨越多次会话的长期交互。用户上周提过的计划、某位家庭成员说过的话、某次对话时的语气,都可能在之后被问起。但语音里的信息远不止文字:谁说的、怎么说的、背景里有什么声音,都只存在于音频信号里,一旦转成文字就丢失了。…
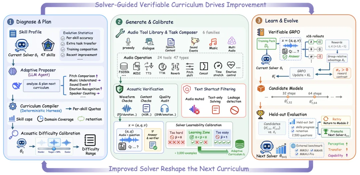
同一句话播放两遍,内容一模一样,只是第二遍音调更高,让它挑出音调更高的那一遍。能把语音转写准确的模型,未必答得好这样的题。类似的问题还有:一段对话里有几位说话人?一段音乐的节奏有没有加快?这些任务都在提醒我们:知道“说了什么”,不等于听懂声…

今日论文合集:CS.SD语音与音频 | 共 12 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 快速导航 1. 语音合成与声音生成 1…

Edge0 发布 Audio8-ASR-Infinite 预览版,面向中英文实时语音识别,提供 80、120 和 160ms 三档流式音频时钟,并可将转写延迟配置在 240–560ms。 模型原生上下文为 30 秒,但通过滚动 KV 缓存持…
过去一年,OpenAI、Thinking Machines Lab 等多模态团队开始把注意力从「生成更拟人的语音回答」,迈向一个更难的问题:AI 如何真正参与一场实时发生的互动。 全双工模型让智能体边听边说,全模态让语音、视觉等信息协同判断…

今日论文合集:CS.SD语音与音频 | 共 25 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 快速导航 1. 语音识别与关键词检测…
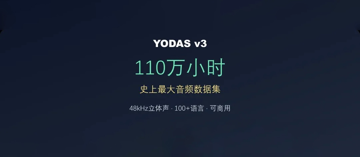
ESPnet 团队发布开放语音数据集 YODAS v3,收录超过 110 万小时、147 种语言的真实世界音频,全部以 48kHz 发布,其中超过 70% 包含两个及以上真正不同的音频通道。 相比此前主要面向语音识别的 YODAS,v3 加…

今日论文合集:CS.SD语音与音频 | 共 15 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 快速导航 1. 语音识别与关键词检测…

虚假音频检测技术日益受到关注,但现有技术仍存在两方面的局限:一是人工模仿音频检测。真人模仿者可复现目标说话人的韵律、音色和风格,与AI合成音频不同,人工模仿音频无明显生成痕迹,对现有检测方法构成严峻挑战。二是可解释性检测。为增强检测可信度,…

本文来源丨21db声学人 视觉—语言—动作模型已经让机器人越来越会“看着做事”,但现实操作中的很多关键状态并不写在画面里:微波炉“叮”的一声、电话铃响、咖啡壶沸腾时的喷溅声,往往只出现几百毫秒。上海交通大学与剑桥大学团队提出 HEAR 框架…
