
 语音小管家
AudioCC交我学
过去几年里,语音生成(TTS)任务经历了一次非常深刻的变化:从传统的声码器 + 声学模型架构,逐步跨入“语音大模型(Speech-LM)时代”。
在这个转折点上,一个关键的技术方向愈发重要——离散语音表征(Discrete Speech Representation)。它不仅改变了 TTS 的建模方式,也让 TTS 第一次真正具备了语言模型的“语义理解、上下文建模与 In-Context Learning 能力”。
这篇推文将带你系统回顾这段发展历程:离散表征为什么会出现?如何让 TTS 与 LLM 结合?技术路线经历了哪些关键节点?我们按时间顺序梳理这场“范式转移”背后的技术脉络。
⏩为什么 TTS 需要离散表征?
传统 TTS 使用 mel-spectrogram 或连续音频 latent,虽然包含丰富声学细节,但也存在明显局限:
学习难度高:连续特征维度大、噪声多,训练不稳定,对模型容量要求高。
不利于语言建模:连续特征混合了大量底层物理信息,不利于结构化表示。
无法直接与大语言模型结合:连续向量无法作为 token 输入 Transformer。
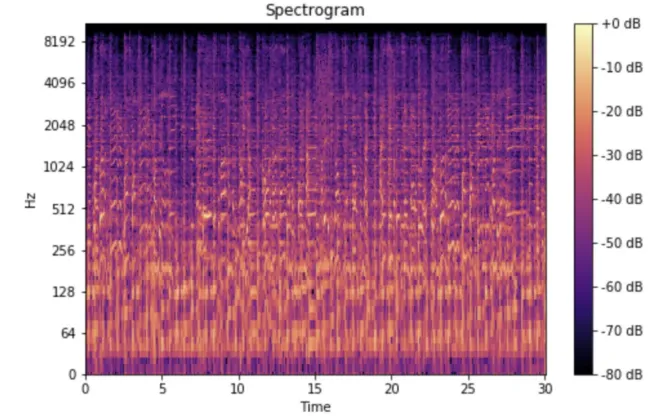
这些问题促使研究者提出核心问题:能否将语音 token 化,使语音也能像文本一样被大模型学习?
离散表征由此成为 TTS 进入大模型时代的关键起点。
⏩第一阶段:语义层离散化 — HuBERT(2021)
HuBERT 是离散语义建模的开端,它通过自监督方式学习语音中的高层结构,将语音转化为类似音素、音节的“语义 token”。
其核心机制包括:
k-means 聚类生成伪标签:HuBERT 不需要人工标注,而是利用 k-means 聚类为语音帧生成 pseudo label,从而得到初步的语义类边界。其创新在于:通过聚类刻画音素级模式,不依赖声学特征工程,可迭代更新类别,逐步提升 token 质量。
Masked Prediction:通过对部分语音帧进行掩码,模型需要预测其对应的 cluster 标签。这类似 BERT 的 Masked LM,但作用于语音帧。其本质是:让模型从上下文中恢复语音单位,从而学习高层语音结构(类似音素、韵律等)
迭代优化:HuBERT 的训练分为多阶段,初始聚类、模型训练、用模型提特征再聚类、再训练模型。通过多轮迭代,token 越来越接近真实语音语义。
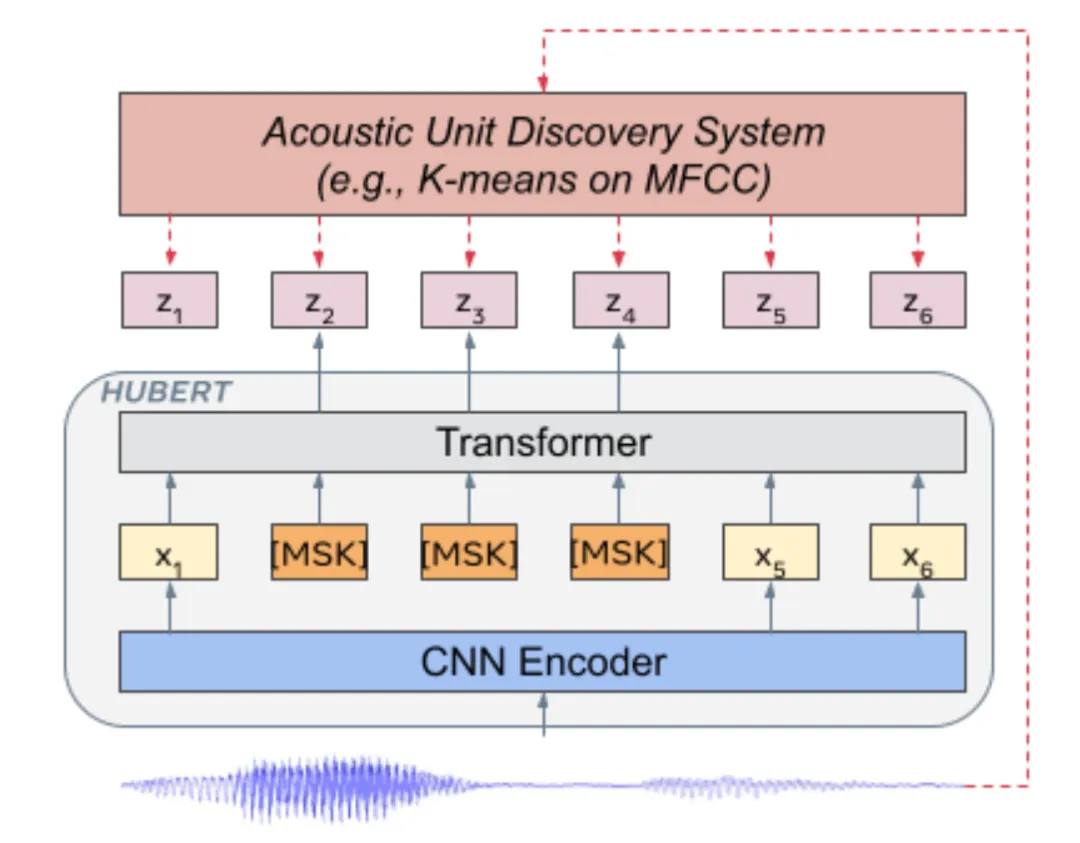
HuBERT 首次得到稳定、可用于 “语义级建模” 的离散语音单位,为“语音的 NLP 化”奠定基础。HuBERT 的出现,使语音不再只是一串连续信号,而具有了可离散化的“语言结构”。但它仍面临说话人特征表达有限、聚类参数敏感、训练流程复杂等问题。
⏩第二阶段:声学层离散化 — EnCodec(2022)
如果 HuBERT 对应的是“语义 token 化”,EnCodec 则实现了“声学 token 化”。
Meta 在 2022 年提出的 EnCodec 使用 Residual Vector Quantization(RVQ),将连续音频表示量化为多个 codebook 的离散索引,为后续 TTS 大模型提供了完整的声学离散表征。
其核心技术包括:
多层 codebook 逐层量化残差(RVQ):传统 VQ 使用单一 codebook,难以表达高维结构;RVQ 将量化过程拆成多步,每一步只需要量化残差。其核心思想为通过多级量化,先抓主要成分,再逐层补充细节。使 EnCodec 成为真正可用于 TTS 的高保真音频 tokenizer。
EMA 训练稳定策略:每个 codebook entry 使用指数滑动平均方式更新,避免 codebook 崩塌,保证离散 token 的分布均衡。
Straight-Through Estimator(STE):在反向传播时假装量化操作是恒等映射,使得离散量化可以被梯度更新。这是让离散 token 可训练的关键技术。
多域损失(GAN + 频域 + 时域):通过引入waveform reconstruction loss、STFT loss、GAN perceptual loss等综合保证音质与感知质量。
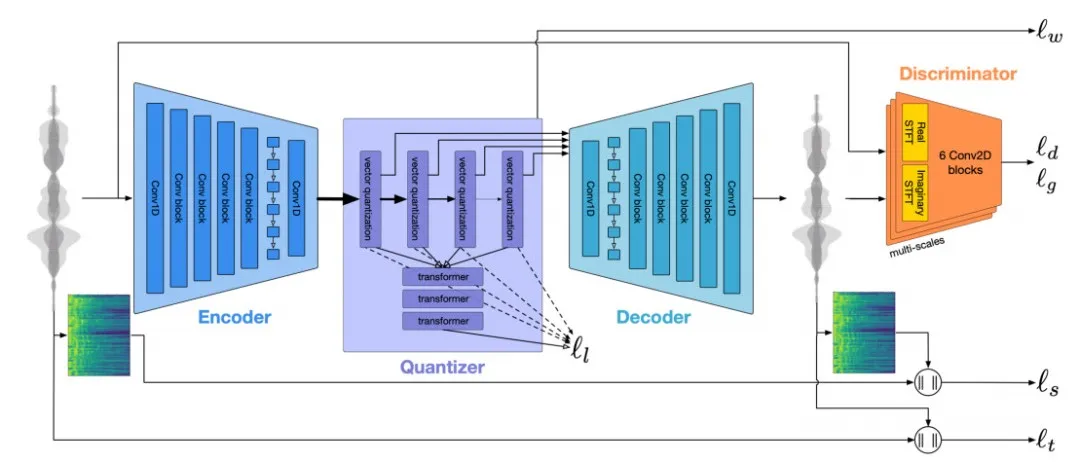
EnCodec 是第一代真正可用的“音频 Tokenizer”,使 TTS 能够使用离散 token 进行自回归建模,高保真高压缩与 LLM 完美兼容,为后续大模型奠定基础。从这一点开始,TTS 可以像 NLP 一样:建模 token 序列,而不是建模连续信号。
⏩第三阶段:TTS 进入大模型时代— VALL-E(2023)
微软在 2023 年发布的 VALL-E,是首个真正意义上的语音大模型(Speech-LM)。
它使用文本 token + 音频 token,采用语言模型的方式预测下一帧语音 token。这一范式正式把 TTS 转变为一个 Codec Language Modeling 任务。
VALL-E 的核心技术创新:
Codec Language Modeling:模型完全按照 GPT 的方式训练,输入为文本 token + 历史声学 token,输出为下一声学 token。这一创新使得TTS 任务适配 LLM 统一建模框架。
In-Context Learning:因为输入包含参考音频 token,模型自然学会在生成中“模仿提示语音的风格”。无需训练专门模块,这就是 CLM 的“天然能力”。
多级 token 的联合建模:RVQ 中第一个 codebook 比后续 codebook 更重要,VALL-E 在损失中体现了这一点,采用AR+NAR结构联合建模,使模型学习结构更稳定。
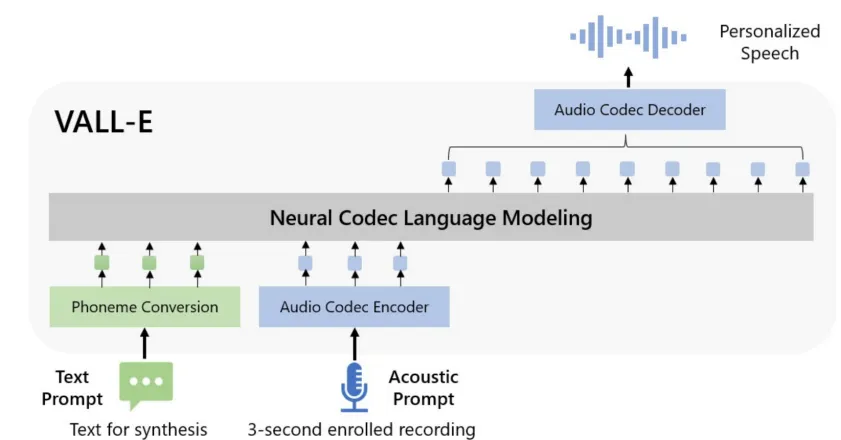
VALL-E首次展现出极强的 zero-shot TTS能力,支持 In-Context Learning(风格模仿),不再依赖声学特征工程,且训练方式与大语言模型完全一致。尽管存在错字,风格单一,工程结构复杂等局限性,VALL-E 标志着 TTS 完整进入大模型时代。
⏩第四阶段:系统化与实用化 — VoiceCraft / Seed-TTS / CosyVoice 2(2024)
随着 VALL-E 的成功,一系列工作开始补足其不足,让离散 token TTS 走向系统化与大规模应用。
1)VoiceCraft:强化上下文建模和编辑能力
核心创新:
Causal Masking: 随机屏蔽部分 token 并移动到末尾,迫使模型利用全局上下文。改善了 VALL-E 中 token 依赖弱的问题,提升全局建模能力。
Delayed Stacking 将多个 codebook 的 token 进行时间错位堆叠,减少每个时间步的预测负担,提高稳定性。
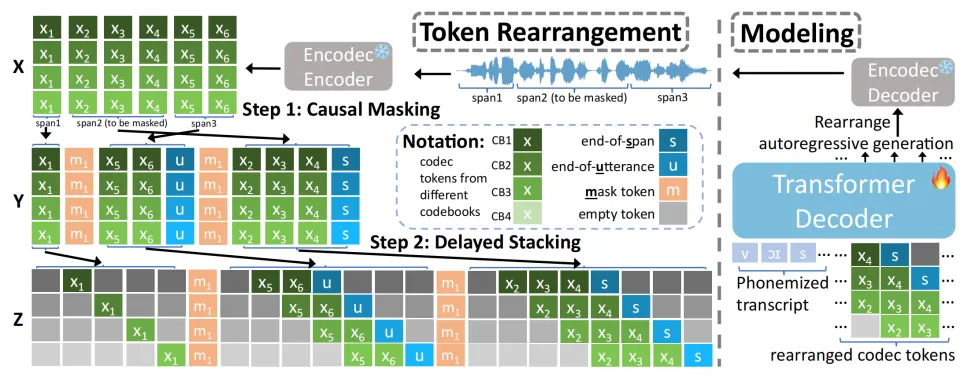
VoiceCraft 进一步完善了 TTS 的语言模型化能力,使长句子更稳定,且支持语音编辑、替换等任务。
2)Seed-TTS:完整的工业级训练体系
Seed-TTS 的技术体系非常完整,是当前工业界最具代表性的 TTS 框架之一。由四个模块组成的“粗到细”结构:Speech Tokenizer,Autoregressive Transformer,Diffusion Transformer,Vocoder。从语义 → 声学 → 细节 → 波形逐步生成。并辅以:大规模预训练,说话人微调(SFT),指令微调(IFT),强化学习优化等多阶段训练,提高可控性与稳定性。
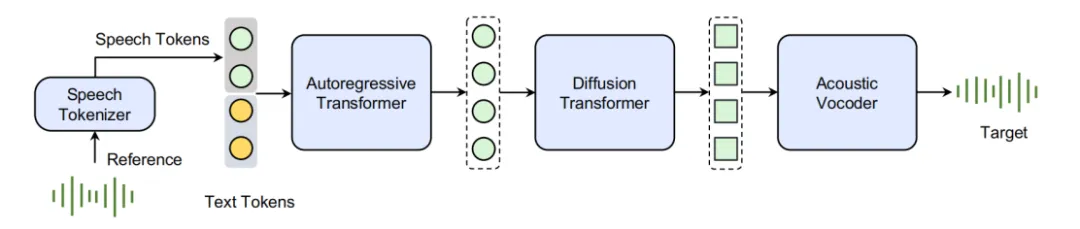
Seed-TTS 展现了极强的情感、风格与细节控制能力。
3)CosyVoice 2:高性能开源系统
其核心创新如下:
文本与语音双 tokenizer:强化声学与语义接口一致性。
Flow Matching替代 Diffusion:生成速度大幅提升,稳定性更好,且结构更轻量。
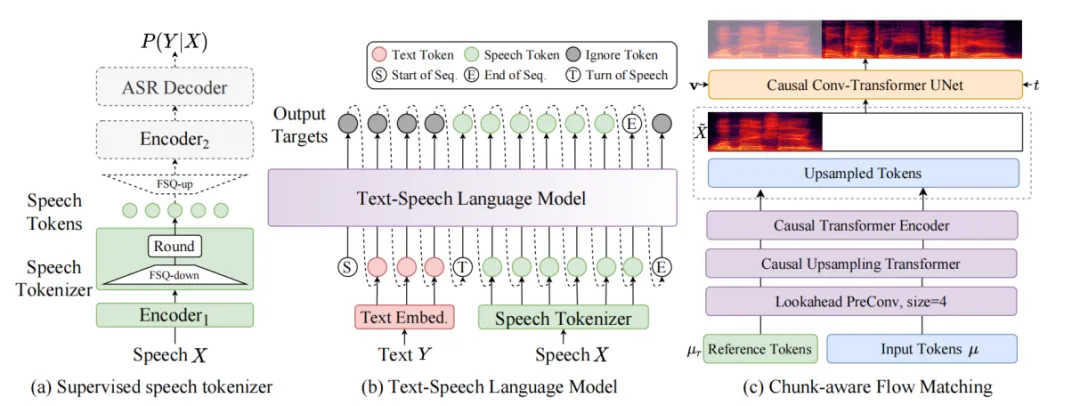
CosyVoice 2 是目前最具工程化与实用性的开源离散 TTS 系统之一,具备指令能力与语音编辑能力,多语言、多任务统一框架。
⏩第五阶段:层次化与结构创新 —VoxCPM(2025)
VoxCPM 引入“任务解耦”与“层次化建模”,代表着离散 TTS 的发展进入更深层次,从“单层 token 建模”迈向“多层、高语义结构建模”的新阶段。
其架构包括:
TSLM:建模长时语义、文本结构、语气与文体逻辑。解决“大段文本生成时语义漂移”的问题。
RALM:专注声学细节建模,补充韵律、能量、发音连续性。
FSQ(半离散量化):在连续与离散之间提供折衷方案。结合连续与离散优点,对大模型友好,减少量化损失,在音质与可训练性之间取得更好平衡。
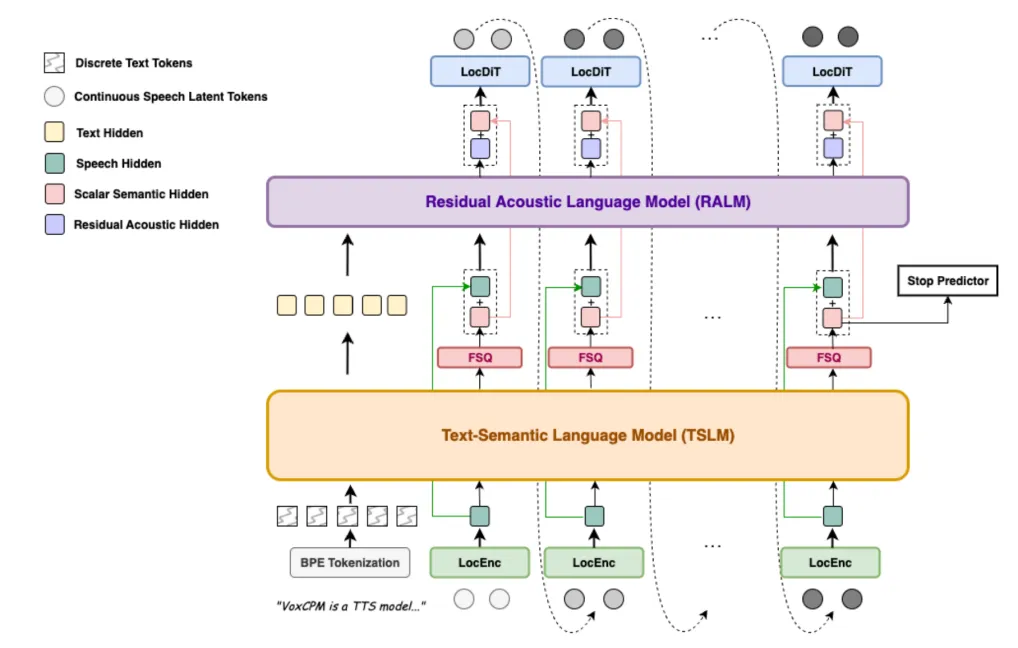
VoxCPM实现语义—声学分离式大模型结构。优势包括:明确区分“内容”与“表达”,有效缓解自回归误差积累,提升风格、文体等高层信息的建模能力。而且模型能够根据上下文自动调整节奏、语气、情绪,突破了传统 TTS 的表达边界。VoxCPM 指向未来可能 TTS 的趋势:层次化、多级 token 协同建模。
⏩小结:离散表征推动 TTS 走向大模型时代
回顾近几年 TTS 的技术演进,离散表征的引入无疑推动了整个领域向大模型化迈出了决定性一步。从 HuBERT 的语义离散化,到 EnCodec 完成声学离散化,再到 VALL-E 将语音生成真正纳入语言模型体系,语音逐渐从连续信号演变为可被建模的符号序列,使模型能够在语义层面理解语音结构,并在长时依赖、风格迁移、跨说话人生成等任务中展现出前所未有的能力。随后 VoiceCraft、Seed-TTS、CosyVoice 等工作进一步完善了系统性和可控性,使离散 TTS 在稳定性、表达力、可编辑性和多任务统一方面取得显著优势,使 TTS 从“声码器驱动”真正转向“语言模型驱动”。
然而,离散表征所带来的挑战同样值得关注:量化误差仍会削弱声学细节,离散 token 与连续声学空间之间的协同尚未完全解决,不同层级 token 的语义边界与控制方式仍需进一步探索,而大规模自监督预训练的资源成本也在不断攀升。未来的发展或许会朝向更精细的层次化建模、更柔性的半离散表示、更强的跨模态融合以及更稳定的长时生成机制,最终形成一种真正统一的“语音语言模型”范式。可以预期的是,随着离散表征不断成熟,TTS 将不仅是声音的生成工具,而将成为 AI 理解、表达和参与人类交流的重要媒介,其在交互、内容创作、辅助沟通乃至多模态智能系统中的作用都会持续扩大,推动语音技术迈向新的高度。
供稿:周庭孝,编辑:方楠,审核:韩冰
