语音与音频学术速递[9.1]

今日论文合集:CS.SD语音与音频 | 共 20 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Parallel Time-Ba…
142 0 0

今日论文合集:CS.SD语音与音频 | 共 20 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Parallel Time-Ba…
“你食咗饭未呀?” 如果把这句粤语交给语音识别系统,它应该写成“你食咗饭未呀”,还是“你吃过饭了吗”? 乍看之下,方言识别似乎只是准不准的问题。但两个答案可能都对,也可能都不够对:前者保留了说话人的语言习惯和地域色彩,却未必方便所有人阅读;…
今日论文合集:CS.SD语音与音频 | 共 7 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Low-Power End-to-…
本文介绍由香港城市大学与华为香港研究所联合完成的工作SpeechEditBench。该工作构建了一个覆盖中英文、七类原子任务与多属性组合编辑的指令语音编辑综合评测基准,已被EMNLP 2026 Main Conference接收。 论文题目…
早期 AudioLM 后训练通常以多任务 SFT 为主:通过混合音频理解、语音生成与对话数据,建立基础的音频指令能力。对于功能验证和常规任务覆盖,这一路径足够直接;但随着底座语言能力增强、音频任务边界扩展,单一 SFT 目标开始面临一个更复…
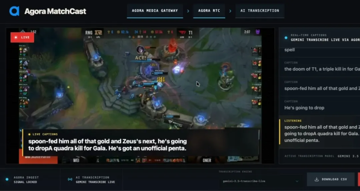
近日,Google 正式发布了 Gemini 3.5 Transcribe。和 Gemini 系列之前的产品定位不同,这不是一个通用多模态模型,而是一个独立的专用转写模型,只负责语音转文字。 目前 Gemini 3.5 Transcribe…
今日论文合集:CS.SD语音与音频 | 共 6 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. SpeechGym: An Aud…
很多人第一次遇到语音识别的"幻觉",是在一段几乎没有人声的录音里。 会议散场后忘了关录音,最后十分钟只有空调声和收拾东西的动静。转写结果却工整地写着一句:"谢谢观看,请点赞订阅。" 没有人说过这句话。模型也不是听错了某个字,而是凭空写出了一…
今日论文合集:CS.SD语音与音频 | 共 8 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Domain-Adaptive A…
本文旨在介绍论文《Fourier is Frontier: Frequency-Aware Autoencoding for High-Fidelity Music Reconstruction》的相关内容,详情如下: GitHub:htt…
