FireRedTTS-2:小红书开源语音模型,3分钟生成4人对话!

最近小红书团队放出了一个具有突破性意义的 TTS 开源项目 FireRedTTS-2 。它是一款专门面向多人对话场景的 TTS(Text-to-Speech)模型。 FireRedTTS-2是一种长形式流式TTS系统,专注于多人对话生成,采…
26 0 0

最近小红书团队放出了一个具有突破性意义的 TTS 开源项目 FireRedTTS-2 。它是一款专门面向多人对话场景的 TTS(Text-to-Speech)模型。 FireRedTTS-2是一种长形式流式TTS系统,专注于多人对话生成,采…
阿里巴巴通义实验室推出了FunAudio-ASR端到端语音识别大模型。这款模型通过创新的Context模块,针对性优化了“幻觉”、“串语种”等关键问题,在高噪声的场景下,幻觉率从78.5%下降至10.7%,下降幅度接近70%。 FunAud…
全国人机语音通讯学术会议(National Conference on Man-Machine Speech Communication,简称NCMMSC),是我国语音科学和技术领域广大专家、学者及科研工作者开展学术研讨与产学交流的重要平台…
语音语言模型(LSLM)领域长期面临碎片化发展困境:架构路径各异、训练数据私有、评估标准缺失,这些问题严重阻碍了技术进步和公平比较。近日,北京深度逻辑智能科技有限公司推出LLaSO——全球首个完全开源的端到端语音语言模型研究框架,旨在为LS…
来源丨AI音频时代 人工智能研究实验室Stability AI正式推出企业级音频生成模型Stable Audio 2.5。也是首款针对企业级用例开发的模型。 Stable Audio 2.5在音频细节处理、生成速度、音乐结构完整性以及功能拓…
来源丨AI音频时代 语音技术及数据服务提供商Voices近日推出了一款面向AI训练的角色语音数据集。该数据集包含超过450种角色类型,由专业配音演员参与录制,覆盖了包括1920年代时髦女性、军事教官和老年巫师在内的多种形象。 据发布信息显示…
来源丨开源星探、AIGC Studio MultiTalk 是一款开源的音频驱动多人对话视频生成框架,由MeiGen-AI联合中山大学、美团和香港科技大学研发。MultiTalk在语音与嘴形同步方面达到了SOTA性能,并支持通过prompt…
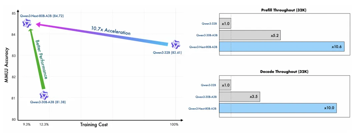
来源丨量子位 Qwen下一代模型架构,抢先来袭! Qwen3-Next发布,Qwen团队负责人林俊旸说,这就是Qwen3.5的抢先预览版。 基于Qwen3-Next,团队先开源了Qwen3-Next-80B-A3B-Base。 模型参数80…
